Dùng ngăn xếp để tìm dấu ngoặc sai đầu tiên
Kiểm tra thứ tự lồng ngoặc, trả vị trí lỗi và giữ trạng thái khi dữ liệu đến từng đoạn; phân biệt ranh giới đoạn với lúc kết thúc đầu vào.
Bộ kiểm tra ngoặc cần nhớ dấu mở nào phải được đóng tiếp theo. Ngăn xếp cung cấp đúng thứ tự đó: dấu mở chưa khớp được gặp gần nhất phải là dấu được đóng trước. Nếu đã biết danh sách và vòng lặp, bạn có thể làm rõ vai trò của ngăn xếp bằng một hàm trả về vị trí lỗi, hữu ích hơn chỉ trả True hoặc False.
Trước hết, xác định đầu vào được chấp nhận. Ví dụ nhận ba cặp (), [], {}; bỏ qua ký tự khác; coi mọi ký tự ngoặc là cú pháp; và trả chỉ số bắt đầu từ không của dấu đóng sai đầu tiên. Nếu hết văn bản mà còn dấu mở, hàm trả vị trí dấu mở chưa khớp gần nhất. Đầu vào hợp lệ trả về None.
Quy tắc cuối là lựa chọn cách báo lỗi. Trình soạn thảo có thể chỉ đến dấu mở chưa đóng sớm nhất hoặc đến cuối đầu vào. Cần chọn một quy tắc để kiểm thử và thông báo lỗi cùng mô tả một hành vi.
Lưu vị trí cùng với dấu ngoặc
Ngăn xếp chứa các cặp gồm ký tự mở và vị trí trong nguồn. Chỉ lưu loại ngoặc cũng đủ để kiểm tra hợp lệ, nhưng vị trí cho phép bên gọi gạch chân dấu cần sửa.
def bracket_error(text):
    expected_open = {')': '(', ']': '[', '}': '{'}
    stack = []
    for position, character in enumerate(text):
        if character in '([{':
            stack.append((character, position))
        elif character in expected_open:
            if not stack:
                return position
            if stack[-1][0] != expected_open[character]:
                return position
            stack.pop()
    return stack[-1][1] if stack else None

assert bracket_error('a{b[c](d)}') is None
assert bracket_error('([)]') == 2
assert bracket_error(']') == 0
assert bracket_error('([') == 1
Với ([)], ngăn xếp nhận ( ở vị trí không, rồi [ ở vị trí một. Khi ) đến tại vị trí hai, dấu mở trên đỉnh lại là [. Đầu vào đã sai ngay tại đây. Tìm sâu hơn trong ngăn xếp để lấy ( sẽ cho phép hai cặp cắt chéo, trái với quy tắc lồng nhau.
Với ([]), dấu ] loại [ khỏi đỉnh, để lộ ( cho dấu đóng tiếp theo. Cách vào sau, ra trước phù hợp với cấu trúc lồng. Hướng dẫn Python dùng cùng hai thao tác append và pop ở cuối trong phần dùng danh sách làm ngăn xếp.
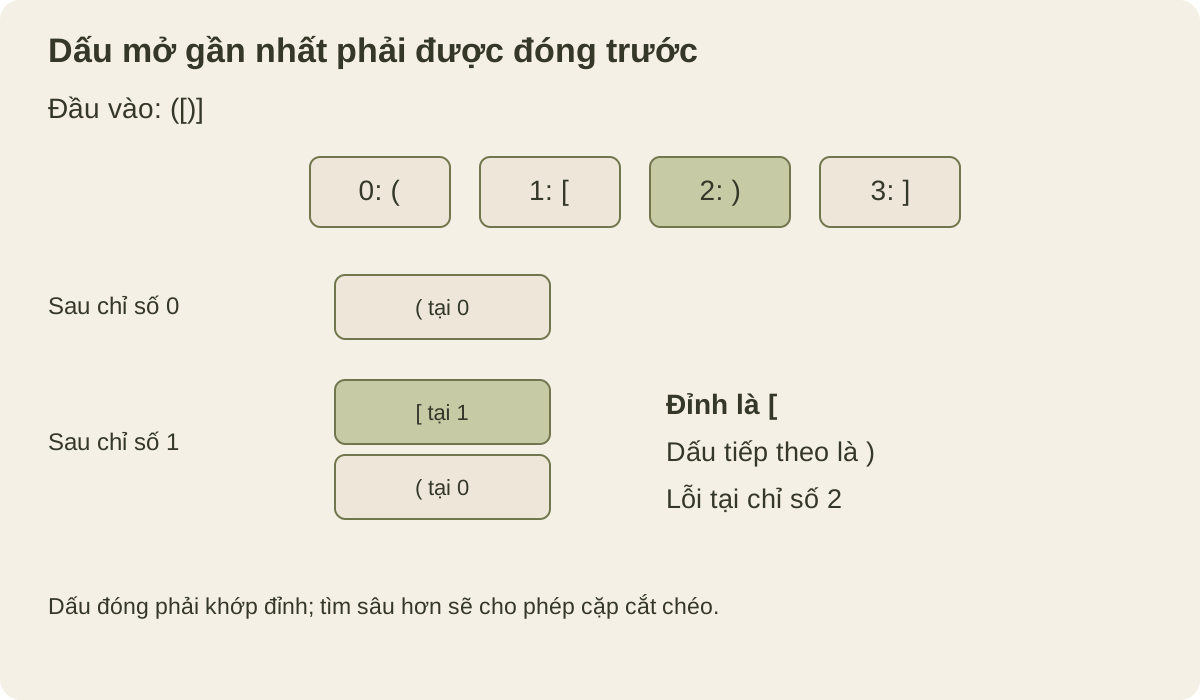
Dấu vết dừng ở lỗi đầu tiên. Các vị trí phía sau không ảnh hưởng câu trả lời của hàm này. Công cụ muốn phục hồi rồi báo nhiều lỗi cần quy tắc bổ sung để một dấu sai không tạo hàng loạt thông báo gây hiểu nhầm.
Bất biến đi theo phần đầu đã đọc
Sau khi đọc một đoạn đầu hợp lệ, ngăn xếp chứa đúng các dấu mở chưa khớp của đoạn đó, theo thứ tự xuất hiện ban đầu. Phần tử cuối là dấu mở của cặp trong cùng còn chưa hoàn tất. Lúc bắt đầu, đoạn đã đọc và ngăn xếp đều rỗng nên mệnh đề đúng.
Đọc ký tự thường không làm đổi các cặp chưa đóng hoặc ngăn xếp. Đọc dấu mở tạo thêm một cặp trong cùng, nên đẩy nó vào ngăn xếp giữ được mệnh đề. Dấu đóng chỉ hợp lệ nếu khớp đỉnh. Lấy cặp đó ra khôi phục mức lồng trước đó.
Nếu ngăn xếp rỗng khi gặp dấu đóng, đoạn đã đọc không có dấu mở nào để ghép. Nếu đỉnh là loại khác, dùng ký tự hiện tại để đóng nó sẽ vi phạm thứ tự lồng. Cả hai trường hợp đều giải thích việc trả lỗi ngay. Cuối đầu vào, ngăn xếp rỗng nghĩa là mọi dấu mở đã được đóng đúng thứ tự. Ngăn xếp còn phần tử chỉ ra những cặp chưa hoàn tất.
Đếm số dấu mở và đóng là chưa đủ. ([]) và ([)] có cùng số lượng từng ký tự nhưng chỉ chuỗi đầu lồng đúng. Ngay cả bộ đếm riêng cho từng loại ngoặc cũng làm mất thứ tự phân biệt hai chuỗi. Ngăn xếp lưu chính thông tin thứ tự còn thiếu đó.
Độ sâu quyết định lượng bộ nhớ
Mỗi ký tự được xét một lần. Mỗi dấu mở được đẩy vào một lần và lấy ra nhiều nhất một lần. Vì vậy, thời gian là O(n) với chuỗi dài n, nếu phân loại ký tự có chi phí hằng số và thêm cuối danh sách có chi phí khấu hao hằng số. Hàm có thể trả sớm khi gặp lỗi, nhưng trường hợp xấu nhất vẫn phải xét toàn bộ ký tự.
Bộ nhớ phụ là O(d), với d là độ sâu lồng lớn nhất mà một đoạn đầu hợp lệ đạt tới. Một triệu cặp cân bằng viết nối tiếp chỉ cần độ sâu một. Một triệu dấu mở tròn liên tiếp cần một triệu mục trước khi hàm đến cuối. Dịch vụ nhận đầu vào không kiểm soát có thể đặt độ sâu tối đa và báo vi phạm giới hạn đó như một loại lỗi riêng.
Vị trí từ phép duyệt chuỗi Python đếm điểm mã Unicode. Nó không phải vị trí byte trong UTF-8, và không phải lúc nào cũng là cột ký tự mà người dùng nhìn thấy. Nếu giao diện tô sáng của trình soạn thảo dùng đơn vị khác, hãy đổi vị trí tại chỗ nối giữa hai phần. Ví dụ ASCII thường che mất khác biệt vì cả ba đơn vị trùng nhau.
Giữ ngăn xếp khi văn bản đến từng đoạn
Bộ đọc tệp hoặc giao thức mạng có thể đưa ([ trong đoạn đầu rồi ]) trong đoạn tiếp theo. Nếu chạy hàm kiểm tra độc lập trên từng đoạn, nó sẽ báo dấu mở chưa đóng quá sớm. Ranh giới đoạn dữ liệu không phải cuối đầu vào logic. Cần giữ ngăn xếp và vị trí tuyệt đối qua các lần gọi; chỉ kiểm tra dấu mở còn lại khi bên gọi tuyên bố đã nhận đủ đầu vào.
class BracketStream:
    def __init__(self):
        self.stack = []
        self.offset = 0
        self.error = None
        self.finished = False

    def feed(self, chunk):
        if self.finished:
            raise ValueError('stream is finished')
        if self.error is not None:
            return self.error
        expected_open = {')': '(', ']': '[', '}': '{'}
        for local, character in enumerate(chunk):
            position = self.offset + local
            if character in '([{':
                self.stack.append((character, position))
            elif character in expected_open:
                if not self.stack or self.stack[-1][0] != expected_open[character]:
                    self.error = position
                    break
                self.stack.pop()
        self.offset += len(chunk)
        return self.error

    def finish(self):
        self.finished = True
        if self.error is None and self.stack:
            self.error = self.stack[-1][1]
        return self.error

stream = BracketStream()
assert stream.feed('([') is None
assert stream.feed('])') is None
assert stream.finish() is None

unfinished = BracketStream()
assert unfinished.feed('([') is None
assert unfinished.finish() == 1

broken = BracketStream()
assert broken.feed('ab(') is None
assert broken.feed('[)') == 4
assert broken.feed('more text') == 4
assert broken.finish() == 4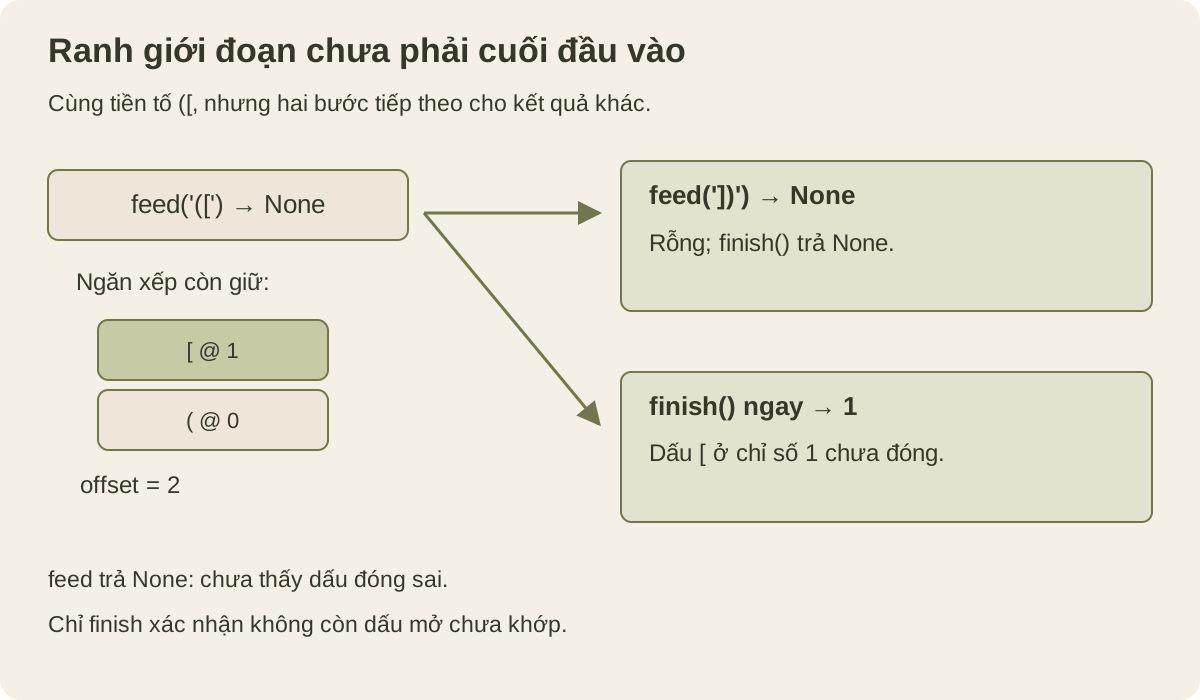
None từ feed chỉ nói rằng đến lúc này chưa thấy dấu đóng sai. Chỉ finish mới xác nhận được không còn dấu mở nào. Sau khi xảy ra lỗi, vị trí ấy được giữ nguyên: đoạn dữ liệu đến sau không thể sửa phần đầu đã sai hoặc thay lỗi đầu tiên. Gọi feed sau khi kết thúc sẽ phát sinh lỗi thay vì âm thầm bắt đầu tài liệu khác. Muốn xử lý tài liệu mới, bên gọi tạo một đối tượng mới.
Độ lệch tuyệt đối đếm ký tự đã cung cấp trước đoạn hiện tại. Trong ví dụ sai, đoạn thứ hai bắt đầu ở vị trí ba. Dấu ) nằm ở vị trí cục bộ một, nên vị trí toàn văn bản là bốn. Hàm có thể không đọc phần còn lại của đoạn lỗi vì nó không tiếp tục phân tích sau lỗi đầu tiên. Đoạn rỗng giữ nguyên trạng thái, không có nghĩa là hết đầu vào.
Giao diện này nhận chuỗi Python đã được giải mã. Luồng byte có thể cắt một ký tự UTF-8 nhiều byte giữa hai đoạn; giải mã từng đoạn byte riêng biệt sẽ gây lỗi khác. Hướng dẫn Unicode của Python phân biệt byte đã mã hóa với văn bản Unicode. Nếu tầng truyền đưa byte, bộ giải mã tăng dần cần đứng trước bộ kiểm tra ngoặc. Đổi kích thước đoạn không được làm đổi vị trí ký tự logic hay kết quả kiểm tra.
Để luyện tập, chia cùng một đầu vào tại mọi vị trí có thể và so sánh kết quả finish với hàm kiểm tra một lần. Thử lỗi ngay tại ranh giới đoạn, đoạn cuối rỗng và phần đầu lồng ngoặc chưa hoàn tất. Những trường hợp này kiểm tra vòng đời và trạng thái được giữ lại, không chỉ bảng ghép loại ngoặc.
Ngoặc trong chuỗi cần ngữ cảnh từ vựng
Hàm này coi dấu ngoặc trong print(")") là dấu đóng, dù bộ phân tích ngôn ngữ lập trình phải xem nó là nội dung chuỗi. Giao diện minh họa cố ý không xử lý chuỗi ký tự và chú thích. Công cụ làm việc với mã nguồn thật cần nhận dạng token trước, bao gồm ký tự thoát và các dạng chuỗi của ngôn ngữ.
Tài liệu phân tích từ vựng Python mô tả các quy tắc đó cho mã Python. Thêm vài phép kiểm tra dấu nháy vào vòng lặp ngăn xếp chưa đủ để xử lý mọi ngôn ngữ. Định dạng cấu hình có thể cho phép ngoặc nhọn trong giá trị đặt trong nháy, còn ngôn ngữ biểu thức toán học có thể không có chuỗi ký tự.
Hãy kiểm thử văn bản rỗng, từng dấu đóng đứng riêng, các loại ngoặc lồng đúng, cặp cắt chéo và đoạn đầu còn dang dở. Thêm ký tự thường quanh ngoặc để xác nhận chúng bị bỏ qua. Khi bổ sung khả năng xử lý chuỗi, cần tạo kiểm thử cho ngoặc nằm trong chuỗi và dấu nháy được thoát trước khi thay đổi ý nghĩa của đầu vào hiện có.