Chia đánh giá LLM theo nguồn tài liệu và thời gian
Giữ họ tài liệu cùng nhau, ghi rõ mốc khả dụng và đưa nhóm đi qua mốc vào phần loại có theo dõi để đánh giá rò rỉ dữ liệu.
Với kỹ sư đánh giá ứng dụng LLM, hãy chia dữ liệu theo nguồn thông tin chung thay vì chỉ xáo câu hỏi. Các cách diễn đạt lại từ một tài liệu, lượt hội thoại liền kề và phiên bản của cùng chính sách có thể tiết lộ gần như cùng đáp án. Đặt chúng ở hai phía ranh giới phát triển và kiểm tra dễ khiến khả năng khái quát trông mạnh hơn thực tế.
Ví dụ giả định Python cơ bản và manifest ghi thời điểm mỗi nguồn trở nên khả dụng. Điều này quan trọng ngay cả khi không huấn luyện trọng số. Ví dụ trong prompt, chỉnh truy xuất, ngưỡng phân luồng và đọc lỗi thủ công đều khiến hệ thống thích nghi với dữ liệu phát triển. Đánh giá cuối cần trường hợp chưa hướng dẫn các quyết định ấy.
Xem cách chia ngẫu nhiên làm lẫn nguồn tài liệu
Xét dữ liệu giả lập gồm ba trăm tài liệu, mỗi tài liệu tạo năm câu hỏi, tổng cộng một nghìn năm trăm câu. Nếu từng câu độc lập vào tập kiểm tra với xác suất 0,2, nhiều tài liệu sẽ có câu ở cả phát triển lẫn kiểm tra.
Với một tài liệu, xác suất cả năm câu ở phát triển là 0.8^5, còn cả năm ở kiểm tra là 0.2^5. Do đó, xác suất xuất hiện ở cả hai phía là 1 - 0.8^5 - 0.2^5 = 0.672. Trong ba trăm nhóm như vậy, số nhóm kỳ vọng bị chia qua hai phía là 201,6.
Có thể tái hiện phép tính bằng Python:
from math import isclose

questions_per_document = 5
test_fraction = 0.2
mixed_probability = (1 - (1 - test_fraction) ** questions_per_document
                     - test_fraction ** questions_per_document)
expected_mixed_documents = 300 * mixed_probability
assert isclose(mixed_probability, 0.672)
assert isclose(expected_mixed_documents, 201.6)
Đây là tính toán giải tích theo quy tắc gán độc lập đã nêu, không phải benchmark đã thực thi. Nó giải thích vì sao cách chia hàng 80/20 quen thuộc có thể không tách được nguồn thông tin nền.
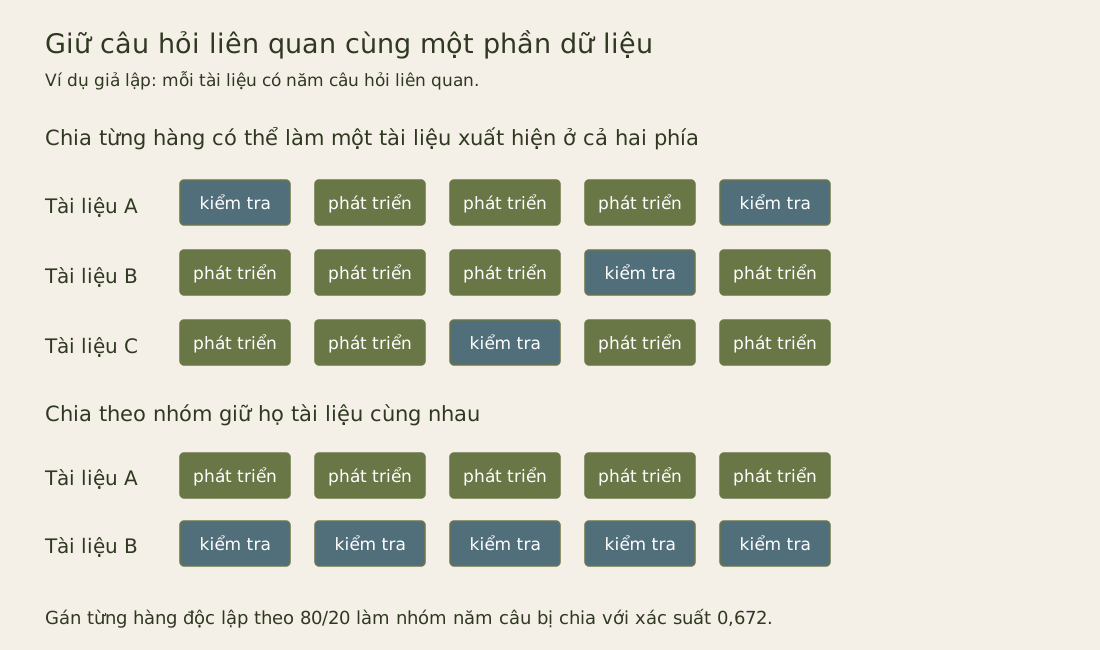
Giữ câu hỏi của một tài liệu cùng nhau giảm kiểu rò rỉ này nhưng chưa tự xử lý tài liệu trùng, mẫu dùng chung hoặc các bản sửa liên quan.
Chọn khóa nhóm cẩn thận
Mã tài liệu là khởi đầu tốt khi mỗi câu đến từ một nguồn. Nếu nhiều tệp là các bản sửa của cùng chính sách, nhóm theo họ chính sách hoặc mã nguồn gốc ổn định. Nếu không, tập phát triển có thể chứa câu trả lời cũ và tập kiểm tra chỉ là bản chỉnh nhẹ.
Với hội thoại, giữ lượt liên quan và câu hỏi tiếp nối cùng nhau. Lượt sau có thể cung cấp thông tin làm câu trước dễ hơn. Với lập trình, mô tả issue, commit lời giải và kiểm thử của cùng thay đổi có thể cùng tiết lộ đáp án dù được lưu thành các bản ghi khác nhau.
Bài báo BEIR đánh giá truy xuất qua các tập dữ liệu và miền riêng. Khi thiết kế đánh giá ứng dụng, cần ranh giới rõ tương tự về thông tin được dùng chung và phần được giữ lại. Điểm chỉ hiểu được trong quan hệ với cách xây dựng dữ liệu ấy.
Thêm thời gian nếu tác vụ cần thông tin mới
Nếu sản phẩm phải trả lời về tài liệu mới, chia theo thời gian có thể sát hơn chia nhóm ngẫu nhiên. Dùng nguồn cũ để phát triển, nguồn sau để đánh giá, với mốc cắt và dấu thời gian rõ ràng. Giữ liên kết các bản sửa để cập nhật tương lai không lọt qua bản gần trùng trước đó.
Chia thời gian cũng tạo yếu tố gây nhiễu: tài liệu sau có thể khác chủ đề, định dạng hoặc độ khó. Điều đó có thể phản ánh đúng thách thức triển khai, nhưng cần báo cáo. Không quy mọi thay đổi điểm cho chất lượng mô hình khi phân phối dữ liệu cũng đổi.
Cố định kho truy xuất cho từng điều kiện đánh giá. Nếu tài liệu trong câu hỏi kiểm tra lẽ ra đã được hệ thống production lập chỉ mục ở thời điểm ấy, hãy cung cấp nó theo điều kiện phù hợp. Nếu mục tiêu là kiểm tra câu hỏi thiếu bằng chứng, chủ động loại nguồn và gắn nhãn mục đích đó.
Kết hợp nhóm nguồn với mốc thời gian
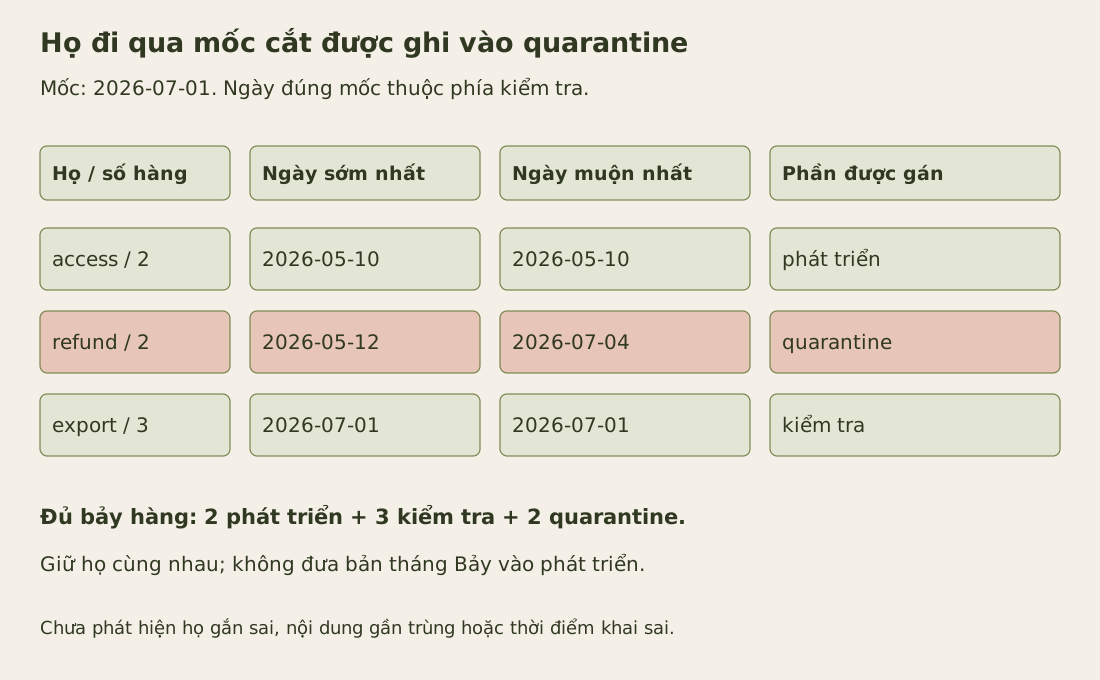
Một họ tài liệu đi qua mốc cắt tạo lựa chọn khó: chỉ nhóm có thể đưa hàng tương lai vào phát triển, còn chia ngày nghiêm ngặt có thể đặt cùng họ ở hai phía. Quy tắc nhỏ sau đưa họ như vậy vào quarantine, tức nhóm tạm loại khỏi phép đánh giá này. Nó hy sinh các hàng ấy thay vì giả vờ đáp ứng cả hai yêu cầu. Với dữ liệu thật ít mẫu, cách này có thể quá tốn kém, nhưng đánh đổi được thể hiện rõ.
Hàm nhận list hoặc tuple không rỗng gồm dictionary với đúng ba trường id, family và available_on. Ngày phải là ngày lịch ISO dạng ASCII chuẩn. Chúng mô tả lúc nguồn khả dụng do người xây dữ liệu cung cấp, không suy từ thời gian sửa tệp. Mã rỗng, mã hàng trùng, ngày sai và iterator chỉ dùng một lần đều bị từ chối.
from datetime import date

def day(text):
    if not isinstance(text, str) or not text.isascii():
        raise ValueError("invalid date")
    try:
        parsed = date.fromisoformat(text)
    except ValueError:
        raise ValueError("invalid date") from None
    if parsed.isoformat() != text:
        raise ValueError("noncanonical date")
    return parsed

def split_families(rows, cutoff_text):
    if not isinstance(rows, (list, tuple)) or not rows:
        raise ValueError("manifest must be a nonempty list or tuple")
    cutoff = day(cutoff_text)
    groups, seen = {}, set()
    for row in rows:
        if not isinstance(row, dict) or set(row) != {"id", "family", "available_on"}:
            raise ValueError("invalid manifest row")
        if any(not isinstance(row[key], str) or not row[key]
               for key in ("id", "family")) or row["id"] in seen:
            raise ValueError("invalid or duplicate identity")
        seen.add(row["id"])
        groups.setdefault(row["family"], []).append((row["id"], day(row["available_on"])))
    result = {"development": [], "test": [], "quarantine": []}
    for family in sorted(groups):
        members = groups[family]
        dates = [when for _, when in members]
        partition = ("development" if max(dates) < cutoff else
                     "test" if min(dates) >= cutoff else "quarantine")
        result[partition].extend(case_id for case_id, _ in members)
    return {name: sorted(ids) for name, ids in result.items()}

manifest = [
    {"id": "refund-v1", "family": "refund", "available_on": "2026-05-12"},
    {"id": "refund-v2", "family": "refund", "available_on": "2026-07-04"},
    {"id": "access-q1", "family": "access", "available_on": "2026-05-10"},
    {"id": "access-q2", "family": "access", "available_on": "2026-05-10"},
    {"id": "export-q1", "family": "export", "available_on": "2026-07-01"},
    {"id": "export-q2", "family": "export", "available_on": "2026-07-01"},
    {"id": "export-q3", "family": "export", "available_on": "2026-07-01"}
]
print(split_families(manifest, "2026-07-01"))
Kết quả đưa cả hai câu access vào phát triển, ba câu export vào kiểm tra và hai bản refund vào quarantine. Ngày đúng mốc thuộc phía kiểm tra. Đổi thứ tự đầu vào không đổi phân hoạch đã sắp. Không hàng nào mất: quarantine là kết quả có ghi nhận, không phải bộ lọc bỏ dữ liệu âm thầm. Bộ thử cũng kiểm tra ngày và định danh sai thay vì lặng lẽ bỏ chúng.
Tài liệu GroupShuffleSplit, được đọc ngày 21 tháng 9 năm 2026, làm rõ tham số kích thước áp dụng cho nhóm chứ không phải từng mẫu. Công cụ đó chia nhóm ngẫu nhiên, không triển khai quy tắc quarantine theo thời gian ở đây. Tách nhóm và mô phỏng thời gian thật là hai lựa chọn riêng; tên lớp quen thuộc chưa chứng minh cả hai được thi hành.
Hàm manifest không tìm được họ gắn nhãn sai, đoạn văn chép dưới mã khác hoặc dấu thời gian khả dụng không chính xác. Cần xem riêng nguồn gốc và bằng chứng trùng lặp. Đưa mọi họ có lịch sử dài vào quarantine còn có thể loại mất câu hỏi cập nhật quan trọng và làm lệch phân phối kiểm tra. Đánh giá theo dõi phiên bản riêng, được ghi tên rõ, có thể phù hợp hơn cho hành vi đó; đừng gọi nó là khái quát sang họ chưa từng thấy.
Trong hệ thống truy xuất, nhãn đáp án giữ lại và tài liệu nguồn có thể truy cập giữ vai trò khác nhau. Câu hỏi tháng Bảy có thể hợp lệ khi truy xuất tài liệu tháng Bảy nếu production đã lập chỉ mục trước lúc hỏi. Giữ chú giải đáp án ngoài ví dụ và bước chỉnh hệ thống, đồng thời cung cấp nguồn theo điều kiện truy xuất đã định nghĩa. Xóa mọi nguồn thuộc tập kiểm tra sẽ đo xử lý thiếu bằng chứng. Ghi mục tiêu trước khi diễn giải điểm.
Tách vai trò của từng tập
Dùng tập phát triển cho ví dụ prompt và gỡ lỗi. Dùng tập xác nhận để chọn ngưỡng hoặc so số ít thiết kế ứng viên. Giữ tập kiểm tra cuối chưa đụng tới cho tới khi hệ thống được chọn sẵn sàng đo. Tên các tập ít quan trọng hơn việc ghi chúng đã ảnh hưởng quyết định ra sao.
Khi lỗi kiểm tra được xem và dùng để sửa prompt, trường hợp ấy đã thành thông tin phát triển. Giữ nó làm ca hồi quy nhưng không tiếp tục coi cùng điểm là ước lượng chưa chịu ảnh hưởng. Thu hoặc dành sẵn dữ liệu mới cho quyết định phát hành sau.
Bài báo HELM nhấn mạnh đánh giá minh bạch qua kịch bản và thước đo. Manifest chia dữ liệu phục vụ cùng mục đích ở mức ứng dụng: cho biết kết quả hỗ trợ phát biểu nào và chưa kiểm tra kiểu khái quát nào.
Kiểm tra ranh giới bằng nội dung nguồn
Hash chính xác có thể tìm tệp nguồn trùng. Phát hiện gần trùng có thể đánh dấu mẫu hoặc cách diễn đạt lại cần đọc thủ công. Không phương pháp nào chứng minh độc lập ngữ nghĩa, nhưng cả hai có thể tìm giao nhau rõ ràng trước khi đánh giá trở nên tốn kém.
Lưu mã nhóm, mã bản sửa, dấu thời gian, phân hoạch và lý do loại. Giữ cách gán ổn định giữa các lần chạy để phép so mô hình không vô tình dùng trường hợp khác nhau. Nếu thay cách chia, tạo phiên bản dữ liệu mới và giải thích lý do.
Với ví dụ giả lập, gán từng họ chính sách vào một phần trước khi sinh hoặc chọn câu hỏi. Đọc mẫu họ gần ranh giới, nhất là những họ có đoạn chép lại hoặc bảng đáp án dùng chung. Mục tiêu là giữ lại quan hệ thông tin mà hệ thống có thể tận dụng, không chỉ giữ một nhóm số hàng.
Cách chia sạch không bảo đảm mô hình hosted chưa từng gặp tài liệu công khai tương tự lúc huấn luyện. Cần giữ rõ điều chưa biết ấy khi liên quan. Nhóm ứng dụng có thể xác lập rằng cách làm ví dụ, chỉnh hệ thống và xây dựng đánh giá của chính mình không chủ ý đưa đáp án giữ lại trở về hệ thống.