Tìm kiếm nhị phân không sai biên một phần tử
Chứng minh tìm cận trái và cận phải trên đoạn nửa mở, đếm giá trị trùng và xử lý vị trí chèn ngoài cuối mảng mà không truy cập sai chỉ số.
Một hàm tìm kiếm nhị phân đáng tin cậy bắt đầu từ kết quả chính xác: trả chỉ số đầu tiên có giá trị lớn hơn hoặc bằng mục tiêu, hoặc trả độ dài mảng nếu không có. Thao tác này gọi là tìm cận trái, hay lower bound. Nếu bạn từng viết hàm bị lặp mãi với hai phần tử hoặc trả một vị trí trùng bất kỳ, giao diện này giải thích lý do cho từng bước cập nhật biên.
Giả sử đầu vào tăng không giảm và phép so sánh tạo thứ tự nhất quán. Kết quả là vị trí chèn, nên vẫn hợp lệ khi mục tiêu không có trong mảng. Tìm hai trong [1, 2, 2, 2, 5] trả một. Tìm bốn trả bốn. Tìm sáu trả năm, là vị trí ngay sau phần tử cuối.
Giữ vùng chưa biết ở dạng nửa mở
Dùng hai biên lo và hi, viết khoảng tìm kiếm là [lo, hi). Đầu trái thuộc khoảng, đầu phải không thuộc. Mọi phần tử trước lo đã biết là nhỏ hơn mục tiêu. Mọi phần tử tại hoặc sau hi đã biết là lớn hơn hoặc bằng mục tiêu.
def lower_bound(values, target):
    lo, hi = 0, len(values)
    while lo < hi:
        mid = lo + (hi - lo) // 2
        if values[mid] < target:
            lo = mid + 1
        else:
            hi = mid
    return lo

assert lower_bound([], 2) == 0
assert lower_bound([1, 2, 2, 2, 5], 2) == 1
assert lower_bound([1, 2, 2, 2, 5], 4) == 4
assert lower_bound([1, 2, 2, 2, 5], 6) == 5
Nếu values[mid] < target, tính có thứ tự cho biết mọi giá trị đến hết mid đều quá nhỏ. Đặt lo = mid + 1 loại cả vùng đó. Giữ lo = mid có thể làm khoảng một phần tử không đổi và tạo vòng lặp vô hạn.
Trong trường hợp còn lại, mid có thể là vị trí đầu tiên thỏa điều kiện. Đặt hi = mid để giữ nó làm đáp án tiềm năng. Dù mid ra khỏi vùng chưa biết, nó trở thành vị trí đầu của vùng đã biết là thỏa điều kiện. Vì vậy, loại nó khỏi khoảng chưa biết không loại nó khỏi các kết quả biên có thể trả về.
Theo dõi đầu vào có giá trị trùng
Với [1, 2, 2, 2, 5] và mục tiêu hai, chỉ số giữa đầu tiên là hai. Giá trị tại đó thỏa điều kiện nên hi thành hai. Lần sau có chỉ số giữa một, cũng thỏa, nên hi thành một. Chỉ số giữa cuối cùng là không; giá trị quá nhỏ nên lo thành một. Hai biên cùng bằng một.
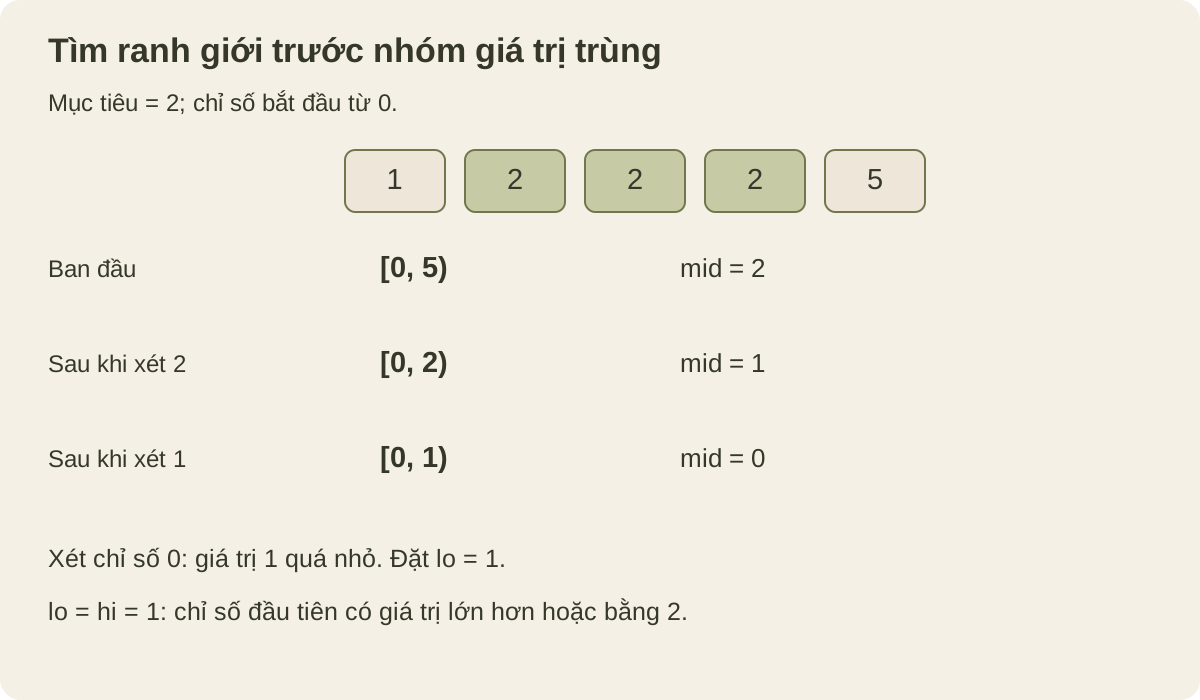
Nếu trả về ngay khi bằng nhau, dấu vết này dừng ở chỉ số hai và vi phạm yêu cầu lấy lần xuất hiện đầu tiên. Các giá trị trùng không phải ngoại lệ khó chịu. Chúng làm rõ khác biệt giữa tìm một phần tử khớp và tìm một ranh giới.
Bất biến đúng trước lượt đầu vì hai vùng đã biết đều rỗng. Mỗi bước cập nhật giữ khẳng định thứ tự tương ứng. Khi lo == hi, không còn vị trí chưa biết giữa vùng nhỏ hơn và vùng thỏa điều kiện, nên ranh giới chung là đáp án. Ghi chú bất biến vòng lặp của Cornell trình bày phương pháp chứng minh tổng quát cho các vòng tìm kiếm như vậy.
Độ dài khoảng là số nguyên không âm, giảm nghiêm ngặt sau mỗi lượt. Khi lo < hi, chỉ số giữa luôn nằm trong khoảng. Cả hai kiểu cập nhật đều loại ít nhất vị trí giữa đó, nên vòng lặp kết thúc cả với mảng một phần tử.
Vị trí chèn chưa có nghĩa là tìm thấy
Muốn trả chỉ số khớp đầu tiên, tìm cận trái rồi kiểm tra cả biên lẫn giá trị. Chỉ kiểm tra bằng nhau là không an toàn vì vị trí trả về có thể bằng độ dài mảng.
def first_index(values, target):
    position = lower_bound(values, target)
    if position < len(values) and values[position] == target:
        return position
    return None

assert first_index([1, 2, 2, 5], 2) == 1
assert first_index([1, 2, 2, 5], 3) is None
assert first_index([], 3) is None
Python cung cấp phép tìm vị trí chèn này qua bisect_left. Phân hoạch trong tài liệu giống phân hoạch đang dùng. Với mã ứng dụng thông thường, thư viện giúp bạn tránh duy trì thêm một bản vòng lặp nhạy cảm với biên.
Tìm kiếm cần O(log n) phép so sánh và O(1) bộ nhớ phụ. Chèn vào mảng động tại vị trí đó vẫn phải dịch phần tử, có chi phí xấu nhất O(n). Tìm chỗ nhanh không làm thao tác sửa cấu trúc bên dưới cũng nhanh như vậy.
Dùng hai cận để tìm cả đoạn bằng nhau
Cận trái tìm giá trị đầu tiên lớn hơn hoặc bằng mục tiêu. Cận phải tìm giá trị đầu tiên lớn hơn nghiêm ngặt. Chỉ phép so sánh trong vòng lặp thay đổi, nhưng ý nghĩa kết quả giải thích vì sao khi bằng nhau phải đưa biên trái tiến lên.
def upper_bound(values, target):
    lo, hi = 0, len(values)
    while lo < hi:
        mid = lo + (hi - lo) // 2
        if values[mid] <= target:
            lo = mid + 1
        else:
            hi = mid
    return lo


def equal_range(values, target):
    return lower_bound(values, target), upper_bound(values, target)

values = [1, 2, 2, 2, 5, 8, 8]
assert equal_range(values, 2) == (1, 4)
assert equal_range(values, 3) == (4, 4)
assert equal_range(values, 9) == (7, 7)
assert equal_range([], 2) == (0, 0)
Bất biến cận phải đặt các giá trị nhỏ hơn hoặc bằng mục tiêu trước lo, còn giá trị lớn hơn nghiêm ngặt nằm tại hoặc sau hi. Lập luận thu hẹp khoảng vẫn chứng minh được kết thúc. Python mô tả phân hoạch thứ hai trong bisect_right. Trộn hai phát biểu phân hoạch nhưng giữ nhánh bằng nhau cũ rất dễ tạo số đếm giá trị trùng trông hợp lý mà sai.
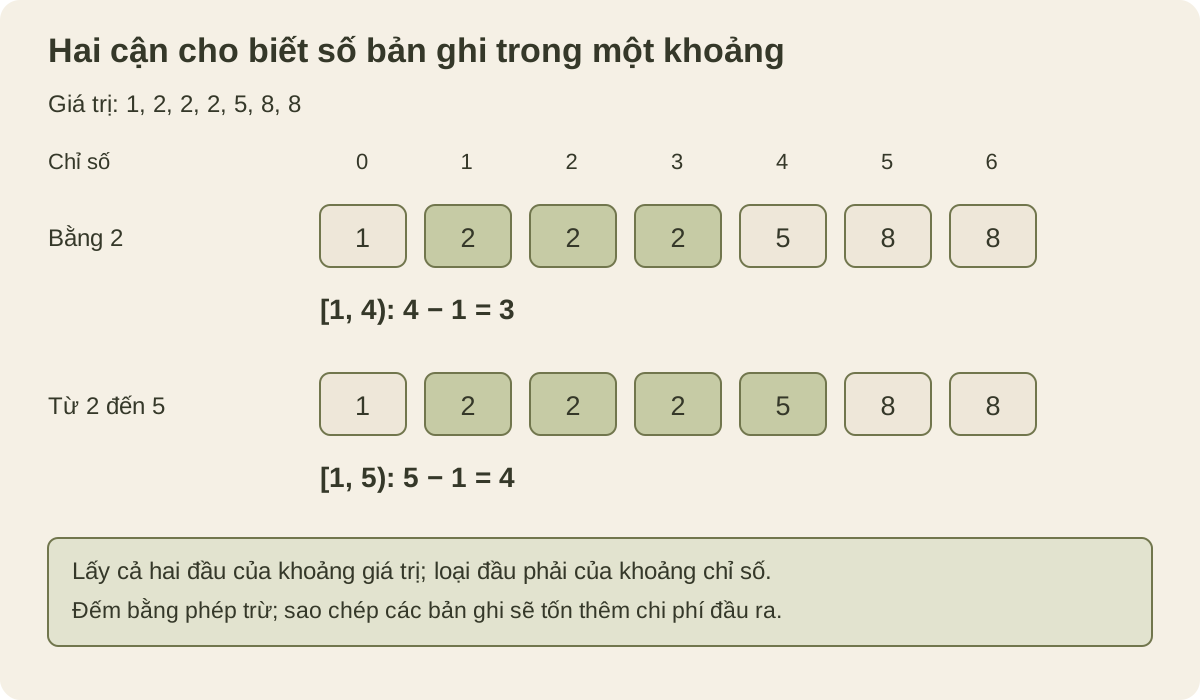
Mọi lần xuất hiện của mục tiêu nằm trong [left, right) do equal_range trả về, nên số lượng là right - left. Mục tiêu không tồn tại tạo đoạn rỗng tại vị trí chèn. Hai đầu mút không nhất thiết là chỉ số phần tử hợp lệ: cả hai có thể bằng độ dài mảng nếu mục tiêu lớn hơn mọi giá trị. Đếm chỉ cần phép trừ, không cần truy cập phần tử ở đầu mút nào.
Có thể đếm cả những bản ghi có khóa nằm trong một khoảng giá trị lấy cả hai đầu. Hai đầu đóng vai trò khác nhau: dùng cận trái cho giá trị nhỏ nhất được phép, cận phải cho giá trị lớn nhất được phép.
def count_inclusive(values, minimum, maximum):
    if minimum > maximum:
        raise ValueError('minimum exceeds maximum')
    return upper_bound(values, maximum) - lower_bound(values, minimum)

assert count_inclusive(values, 2, 5) == 4
assert count_inclusive(values, 3, 4) == 0
assert count_inclusive([], 2, 5) == 0
Trong ví dụ, khoảng giá trị từ hai đến năm nằm ở các chỉ số một đến bốn. Khoảng chỉ số nửa mở tương ứng là [1, 5), chứa bốn bản ghi. Nhầm đầu mút giá trị được lấy với đầu mút chỉ số được lấy sẽ đếm dư một bản ghi. Từ chối khoảng giá trị đảo ngược giúp tránh trả số đếm âm gây hiểu nhầm.
Mỗi phép tìm cận cần O(log n) so sánh, nên hai lần tìm vẫn là O(log n). Nếu sao chép values[left:right] để trả các bản ghi, danh sách Python cần thêm O(k) công việc và bộ nhớ cho k phần tử đầu ra. Giao diện chỉ trả số lượng có thể tránh bản sao. Chỉ báo chi phí tìm vị trí mà bỏ chi phí đầu ra bắt buộc sẽ mô tả một thao tác khác.
Hãy thử mục tiêu nhỏ hơn mọi giá trị, bằng một nhóm trùng và nằm giữa các nhóm. Sau đó so sánh số đếm trong khoảng lấy hai đầu với cách duyệt kiểm tra trực tiếp trên mảng nhỏ đã sắp. Ghi rõ điều kiện có thứ tự và ý nghĩa hai đầu trong mô tả kiểm thử, để đổi một ký tự so sánh không âm thầm đổi kết quả được yêu cầu.
Kiểm thử cả điều kiện thứ tự
Đầu vào rỗng và mục tiêu ngoài hai đầu kiểm tra cách xử lý biên. Các nhóm trùng kiểm tra có thật sự tìm cận trái hay không. Mảng một và hai phần tử dễ lộ bước cập nhật không tạo tiến triển. Có thể sinh toàn bộ mảng số nguyên nhỏ đã sắp và so kết quả với chỉ số đầu tiên thỏa điều kiện.
NaN dấu phẩy động không đáp ứng các kỳ vọng so sánh thông thường trong chứng minh này. Chẳng hạn, cả nan < x lẫn nan >= x đều có thể sai. Danh sách chứa NaN cần thứ tự toàn phần tường minh hoặc quy tắc từ chối chúng trước khi dùng thuật toán. Tương tự, mảng sắp không phân biệt hoa thường phải được tìm bằng cùng quy tắc khóa đó.
Đừng sắp lại bên trong mỗi lần tìm mà không tính chi phí. Nếu bên gọi hứa mảng có thứ tự, hãy nêu rõ và kiểm thử phần mã duy trì lời hứa ấy. Dữ liệu thay đổi liên tục có thể hợp với cấu trúc khác. Vòng tìm cận vẫn hữu ích khi có điều kiện đơn điệu từ sai sang đúng, kể cả tìm trên miền đáp án thay vì trên các phần tử đã lưu.