Radix sort cho mã có độ dài cố định
Theo dõi các lượt chữ số ổn định, kiểm tra nguồn dữ liệu chỉ đọc một lần và tái hiện lỗi khi một nhóm đồng chữ số bị đảo thứ tự.
Radix sort từ chữ số ít quan trọng nhất xử lý mã có độ dài cố định từ phải sang trái, dùng một phép sắp xếp ổn định ở mỗi vị trí. Tính ổn định giữ thứ tự đã tạo bởi các chữ số ít quan trọng hơn khi chữ số tiếp theo bằng nhau. Nếu đã hiểu counting sort, bạn có thể thấy cách nhiều phép sắp xếp khóa nhỏ kết hợp thành thứ tự đầy đủ mà không cần so sánh trực tiếp cả mã.
Ta dùng chuỗi đúng ba chữ số thập phân ASCII, kể cả số không ở đầu. Theo hợp đồng này, thứ tự từ điển trùng với thứ tự của các số nguyên không âm được mã hóa. Các mã "002" và "024" vẫn giữ độ dài trong kết quả. Chuỗi dài không đều, số có dấu và văn bản cần thứ tự theo ngôn ngữ đòi hỏi quy tắc khác.
Theo dõi ba lượt trên cùng các mã
Bắt đầu với 170, 045, 075, 090, 802, 024, 002, 066. Lượt ổn định theo hàng đơn vị cho 170, 090, 802, 002, 024, 045, 075, 066. Những mã cùng chữ số đơn vị giữ thứ tự đầu vào: 170 vẫn trước 090 và 802 vẫn trước 002.
Lượt hàng chục tiếp theo cho 802, 002, 024, 045, 066, 170, 075, 090. Chẳng hạn, 170 và 075 cùng có chữ số hàng chục là bảy. Lượt đơn vị đã đặt 170 trước 075 vì chữ số 0 nhỏ hơn chữ số 5, và tính ổn định giữ thứ tự đó. Cuối cùng, lượt hàng trăm tạo 002, 024, 045, 066, 075, 090, 170, 802.
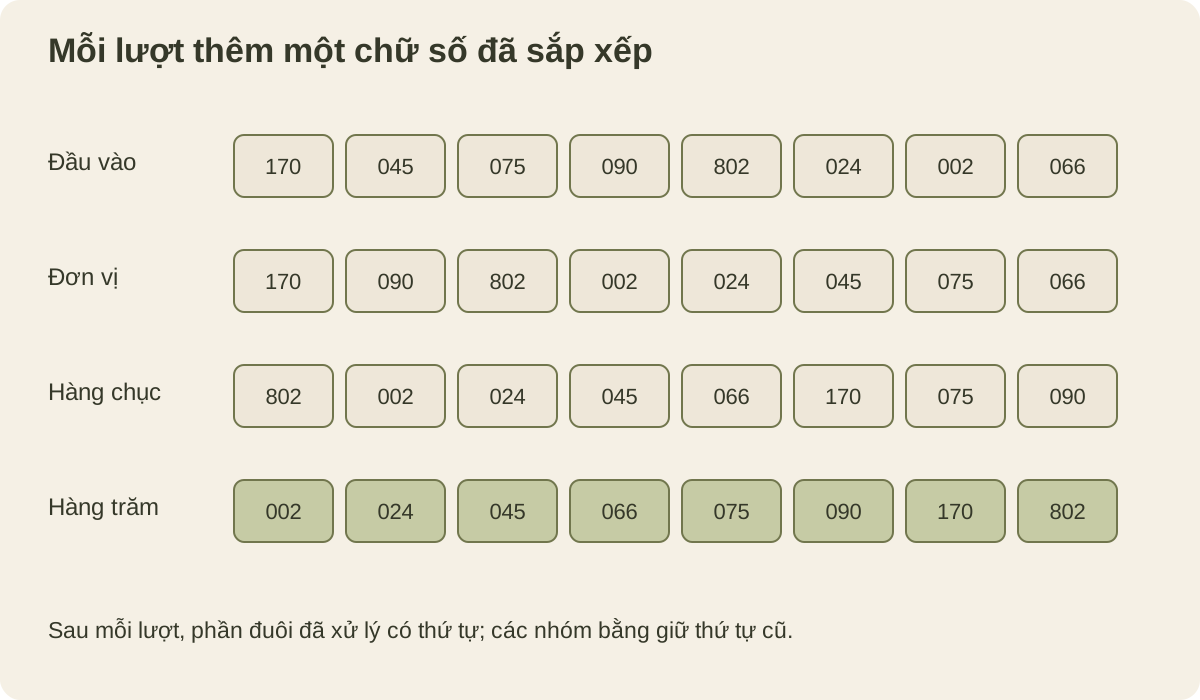
Sau mỗi lượt, chỉ xét phần đuôi đã xử lý. Lượt hàng chục sắp xếp hai chữ số cuối nên 802 và 002 nằm cùng ở đầu, dù giá trị đầy đủ của chúng cách xa nhau. Thứ tự tạm thời đó là điều ta mong đợi.
Cài đặt phép phân phối chữ số ổn định
Mười nhóm là đủ cho một chữ số thập phân. Quét từ trái sang phải, nối từng mã vào cuối nhóm tương ứng với chữ số rồi ghép các nhóm từ không đến chín. Thao tác nối cuối giữ thứ tự bên trong mỗi nhóm có cùng chữ số.
def radix_sort_ids(identifiers, width):
    if type(width) is not int or width < 1:
        raise ValueError('width must be a positive integer')
    result = list(identifiers)
    if any(not isinstance(value, str) or len(value) != width or
           any(character not in '0123456789' for character in value)
           for value in result):
        raise ValueError('expected fixed-width ASCII decimal identifiers')
    for position in range(width - 1, -1, -1):
        buckets = [[] for _ in range(10)]
        for value in result:
            buckets[ord(value[position]) - ord('0')].append(value)
        result = [value for bucket in buckets for value in bucket]
    return result

identifiers = ['170', '045', '075', '090', '802', '024', '002', '066']
assert radix_sort_ids(identifiers, 3) == [
    '002', '024', '045', '066', '075', '090', '170', '802',
]
assert radix_sort_ids([], 3) == []
Việc kiểm tra thuộc tập chữ số ASCII là có chủ ý. Cơ chế nhận diện chữ số rộng hơn của Python có thể chấp nhận ký tự mà phép ánh xạ bằng trừ mã ký tự này không xử lý được. Biểu diễn của khóa chuỗi là một phần hợp đồng thuật toán, nên kiểm tra đầu vào phải khớp quy tắc tạo chỉ số thật sự.
Cài đặt thực tế có thể dùng mảng đếm, vị trí tiền tố và vùng đệm kết quả tái sử dụng để tránh cấp phát nhiều danh sách nhóm nhỏ. Nguyên tắc phân phối ổn định vẫn giống nhau. Tài liệu LSD sort của Princeton và mã cài đặt dùng đếm theo chỉ số khóa để thực hiện các lượt đó.
Tính ổn định duy trì chứng minh quy nạp
Sau lượt đơn vị, các mã có thứ tự theo chữ số cuối. Giả sử sau một lượt chúng đã được sắp theo k chữ số cuối. Lượt tiếp theo phân nhóm theo chữ số nằm ngay trước phần đuôi ấy. Các nhóm xuất hiện theo thứ tự tăng của chữ số mới. Bên trong một nhóm cùng chữ số, tính ổn định giữ phần đuôi k chữ số vốn đã có thứ tự.
Do đó, kết quả có thứ tự theo k + 1 chữ số cuối. Khi đã xử lý đủ width chữ số, phần đuôi ấy chính là toàn bộ mã, chứng minh thứ tự cuối cùng. Mỗi lượt cũng bảo toàn tập giá trị và số lần xuất hiện vì mỗi mã đi vào và đi ra đúng một nhóm.
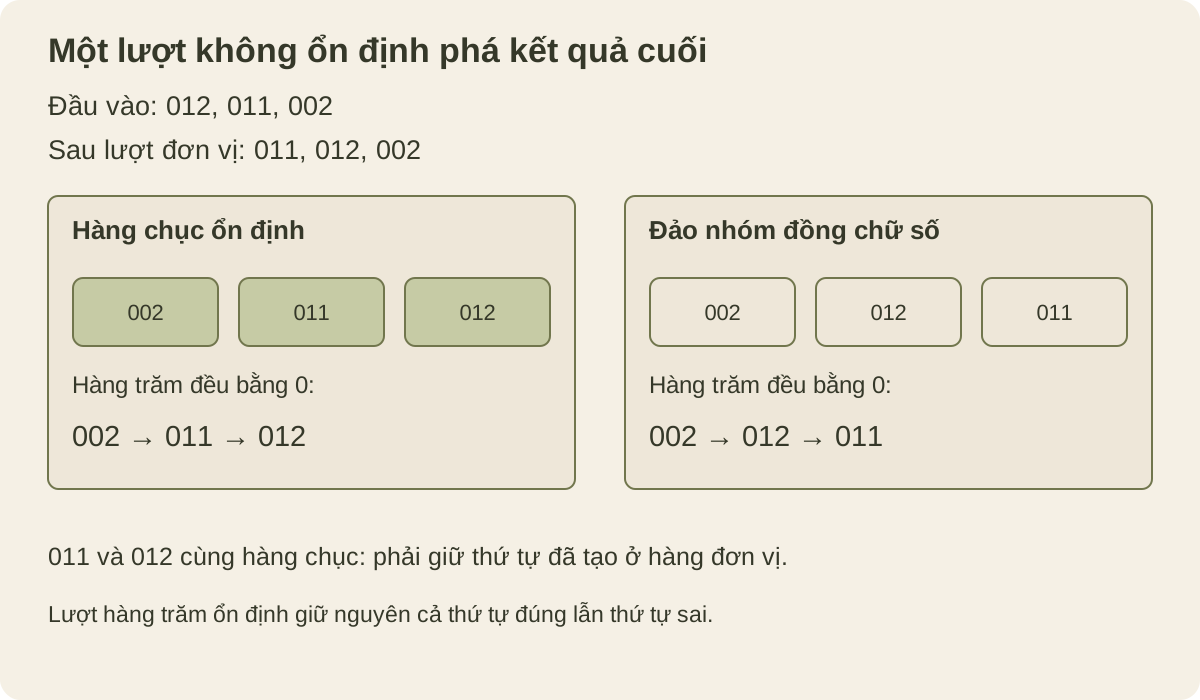
Một lượt không ổn định phá vỡ quy nạp. Xét 12 và 11. Lượt đơn vị sắp chúng thành 11 rồi 12. Cả hai cùng có chữ số hàng chục là một, nên lượt hàng chục không ổn định có thể đảo chúng thành 12 rồi 11. Mỗi lượt riêng vẫn gom đúng các chữ số bằng nhau nhưng thứ tự mã đầy đủ cuối cùng lại sai.
Cơ số và độ dài khóa đều có chi phí
Với n mã, độ dài w và cơ số R, một lượt dựa trên đếm có chi phí O(n + R). Toàn bộ phép sắp xếp có chi phí O(w(n + R)), cộng O(wn) để kiểm tra đầu vào. Ví dụ thập phân cố định R bằng mười. Bộ nhớ làm việc phụ là O(n + R) tham chiếu hoặc ô khi vùng đệm được tái sử dụng giữa các lượt.
Gọi radix sort đơn giản là “tuyến tính” thường ngầm giả sử độ dài và cơ số bị chặn độc lập với n. Khi mã dài hơn, số lượt cũng tăng. Chọn cơ số lớn hơn xử lý nhiều thông tin hơn trong một lượt nhưng tăng mảng nhóm và có thể thay đổi hành vi bộ nhớ đệm. Cần xét những lựa chọn này trong một phép so sánh cài đặt cụ thể.
Radix sort không chịu cận dưới của sắp xếp so sánh vì nó đọc chữ số và dùng chúng làm chỉ số. Cận dưới đó giả sử thông tin về thứ tự chỉ đến từ so sánh các khóa đầy đủ. Hai kết quả không mâu thuẫn; chúng đếm công việc trong những mô hình thao tác khác nhau.
Xác định thứ tự mã có nghĩa gì
Các số không ở đầu có thể quan trọng với hệ thống bên ngoài dù so sánh số học bỏ qua chúng. Đừng đổi mã thành số nguyên chỉ để tiện sắp xếp nếu bên gọi cần giữ biểu diễn gốc. Cài đặt này bảo toàn chuỗi và trả về một danh sách mới.
Với chuỗi thập phân dài không đều, thêm số không cho đủ độ dài có thể hỗ trợ thứ tự số học nếu độ dài được chọn thống nhất và chuỗi gốc vẫn được giữ kèm bản ghi. Với tên Unicode tùy ý, nhóm chữ số và thứ tự mã ký tự không tái hiện quy tắc đối chiếu của một ngôn ngữ. Hãy dùng khóa đối chiếu đã xác định và cách sắp xếp phù hợp, thay vì tự giả định có thể mở rộng ví dụ thập phân này.
Hãy kiểm thử số không đầu, mã đầy đủ lặp lại, mọi giá trị cùng một nhóm chữ số và các vị trí chữ số khác nhau. Từ chối rõ ràng độ dài sai và ký tự ngoài ASCII. Khi học thuật toán, lưu kết quả sau mỗi lượt rồi so sánh riêng phần đuôi đã xử lý trước khi xét toàn bộ thứ tự cuối.
Kiểm tra nguồn chỉ đọc một lần trước khi sắp xếp
Bản thân việc kiểm tra đầu vào cũng tiêu thụ iterator. Nếu mã kiểm tra một generator rồi mới gọi list, danh sách sao chép sẽ rỗng. Cài đặt này lưu các mã thành danh sách một lần, sau đó kiểm tra và sắp xếp danh sách ấy. Nó cũng từ chối giá trị không phải chuỗi và yêu cầu độ dài là số nguyên dương dựng sẵn; boolean không được xem là độ dài ở đây.
source = iter(['012', '002', '011'])
assert radix_sort_ids(source, 3) == ['002', '011', '012']
assert list(source) == []

for invalid_values, invalid_width in [
    (['12'], 3), (['123'], 3), (['12A'], 3),
    ([123], 3), ([], 0), ([], 2.5), ([], True),
]:
    try:
        radix_sort_ids(invalid_values, invalid_width)
    except ValueError:
        pass
    else:
        raise AssertionError('invalid representation was accepted')
Các ký tự có độ rộng đầy đủ trong đầu vào bị từ chối thứ hai trông giống chữ số thập phân nhưng không phải chữ số ASCII. Mã ký tự của chúng không tạo chỉ số từ không đến chín theo phép ánh xạ này. Việc từ chối giá trị dạng số cũng có chủ ý: đổi nó thành chuỗi sẽ tự thêm một chính sách biểu diễn, trong đó có cách xử lý số không đầu. Bên gọi phải cung cấp chính sách ấy trước khi dùng phép sắp xếp cụ thể này.
Lưu một lần hỗ trợ các iterable hữu hạn; nó không biến thuật toán thành sắp xếp theo luồng với bộ nhớ bị chặn độc lập với kích thước đầu vào. Tất cả mã vẫn cần sẵn có cho mỗi lượt chữ số. Độ dài được kiểm tra trước khi đọc nguồn, nhưng giá trị được kiểm tra sau khi nguồn đã được sao chép. Bên gọi cần giới hạn số đầu vào phải thực hiện việc đó riêng, đặc biệt khi nguồn có thể không kết thúc.
Cố ý phá một quy tắc đồng hạng để thấy lỗi
Có thể kiểm tra lập luận quy nạp bằng một lượt chữ số cố ý không ổn định. Đảo từng nhóm chữ số vẫn giữ các nhóm theo đúng thứ tự chữ số, nhưng đảo bản ghi có chữ số bằng nhau. Hàm phụ sau là minh họa lỗi, không phải một thuật toán sắp xếp thay thế.
def digit_pass(values, position, reverse_ties=False):
    buckets = [[] for _ in range(10)]
    for value in values:
        buckets[ord(value[position]) - ord('0')].append(value)
    if reverse_ties:
        for bucket in buckets:
            bucket.reverse()
    return [value for bucket in buckets for value in bucket]

start = ['012', '011', '002']
units = digit_pass(start, 2)
assert units == ['011', '012', '002']
stable_tens = digit_pass(units, 1)
broken_tens = digit_pass(units, 1, reverse_ties=True)
assert stable_tens == ['002', '011', '012']
assert broken_tens == ['002', '012', '011']
assert digit_pass(broken_tens, 0) == ['002', '012', '011']
Lượt đơn vị đặt phần đuôi một trước phần đuôi hai. Đến lượt hàng chục, 011 và 012 cùng thuộc nhóm chữ số một. Đảo nhóm đó phá thứ tự đơn vị. Tất cả chữ số hàng trăm đều bằng không, nên lượt hàng trăm ổn định về sau giữ nguyên thứ tự đã hỏng thay vì sửa nó. Chỉ kiểm tra phần tử thuộc đúng nhóm là hậu điều kiện quá yếu.
Để luyện tập, thêm cơ chế lưu bản sao sau mỗi lượt vào cài đặt thật. So từng ảnh chụp trạng thái với phép sắp xếp ổn định của thư viện theo phần đuôi đã xử lý của đầu vào gốc. Dùng mã ba chữ số trên một tập chữ số nhỏ để thường xuyên gặp giá trị bằng nhau, rồi thêm mã đầy đủ lặp lại dưới dạng bản ghi có nhãn nếu mở rộng giao diện cho dữ liệu đính kèm. Bài tập kiểm tra mệnh đề quy nạp ở từng giai đoạn, giúp xác định lượt hỏng đầu tiên thay vì chỉ báo danh sách cuối sai.