Lần theo các trang B-tree khi quét một khoảng
Theo dấu chỉ mục bốn lá, giải thích trang chỉ dùng để dừng và tách yêu cầu logic khỏi trượt bộ nhớ đệm cùng lần đọc thiết bị thật.
Một lần quét khoảng trên B-tree thường tìm đường xuống cây lúc đầu, rồi đi qua các trang dữ liệu kế tiếp. Nếu tìm riêng từng khóa, chương trình có thể phải đi lại đường dẫn điều hướng nhiều lần. Khác biệt ấy hữu ích khi đọc kế hoạch truy vấn chỉ mục, nhưng chưa cho biết số lần đọc thiết bị lưu trữ: các trang thường dùng có thể đã nằm trong bộ nhớ đệm.
Bài này dành cho lập trình viên đã biết mảng có thứ tự và muốn hiểu chỉ mục tổ chức theo trang. Ta dựng mô hình nhỏ theo kiểu B+tree, không thay đổi trong lúc chạy, lần theo một truy vấn khoảng, rồi tách số yêu cầu trang ở cấp mô hình, số trang khác nhau và I/O thật. Chỉ cần Python cơ bản. Mã dùng tên trang giả định cùng khóa số nguyên, không phân tích tệp cơ sở dữ liệu và không đo hiệu năng.
Mỗi bước điều hướng chọn giữa nhiều nhóm khóa
Bộ máy lưu trữ thường chia tệp thành các trang. Mô tả định dạng tệp SQLite quy định kích thước trang cố định trong một tệp cơ sở dữ liệu. Một trang có thể chứa nhiều khóa và tham chiếu, nên nút cây không nhất thiết chỉ có một khóa như cây tìm kiếm nhị phân đơn giản. Số nhánh thực tế phụ thuộc số byte khả dụng, độ dài khóa, phần đầu trang và mức sử dụng chỗ trống.
Gốc của mô hình có bốn con và ba khóa phân cách: 4, 8, 12. Bốn trang lá lần lượt chứa khóa 0 đến 3, 4 đến 7, 8 đến 11, và 12 đến 15. Mỗi lá còn ghi tên lá kế tiếp. Toàn bộ bản ghi, kể cả giá trị nhỏ vN, nằm ở lá. Mọi lá cách gốc cùng một số bước.
Ta định nghĩa khóa phân cách là khóa nhỏ nhất thuộc cây con bên phải nó. Vì vậy tìm 8 phải đi sang phải khóa phân cách 8, vào L2. bisect_right của Python thực hiện lựa chọn tại ranh giới ấy. Tìm 7 đi vào L1. Tìm khóa nhỏ hơn mọi khóa đã lưu vẫn bắt đầu ở L0; tìm khóa lớn hơn tất cả bắt đầu ở L3 và có thể không thấy gì.
Đây là quy ước của ví dụ. Cài đặt thật có thể dùng bất đẳng thức phân cách, khóa cận trên và vị trí chứa dữ liệu khác. SQLite phân biệt B-tree của bảng và của chỉ mục: dữ liệu trong cây của bảng nằm ở lá, còn khóa của cây chỉ mục có thể xuất hiện trong ô của trang trong. Không thể suy ra rằng mọi cấu trúc mang tên B-tree đều chỉ lưu thông tin hữu ích ở trang lá.
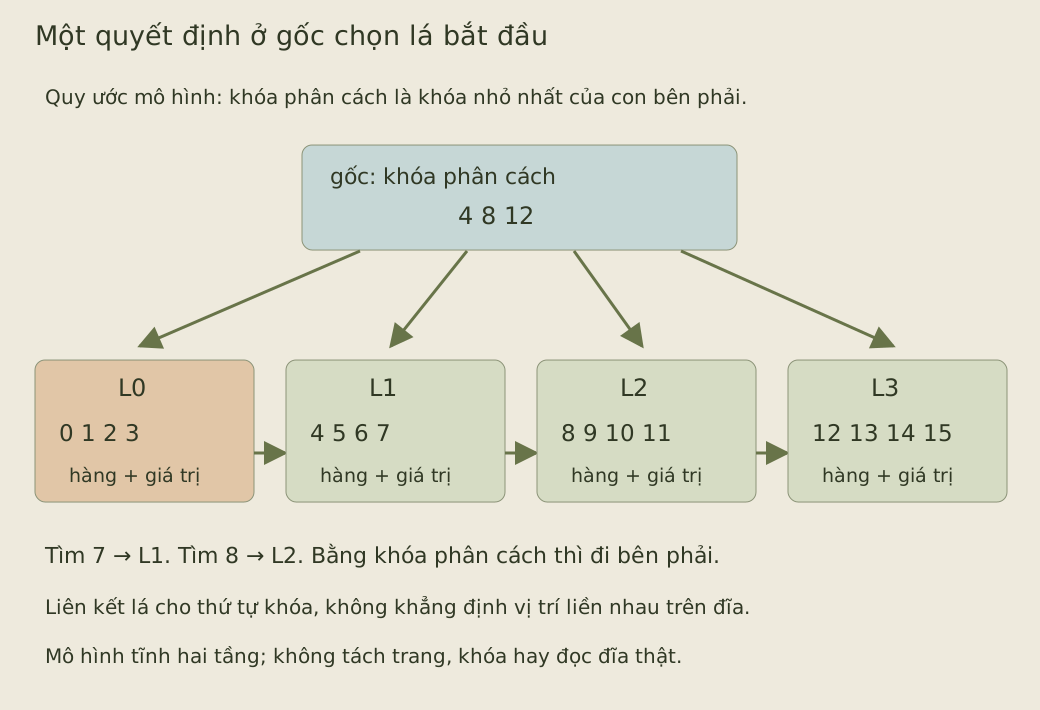
Mũi tên giữa các lá xác định trang tiếp theo theo thứ tự khóa. Chúng không khẳng định các trang lá nằm ở những sector liền nhau trên đĩa. Lịch sử cấp phát và tách trang có thể làm vị trí vật lý cách xa nhau dù phép quét đi qua chúng liên tiếp.
Đi xuống một lần rồi theo chuỗi lá
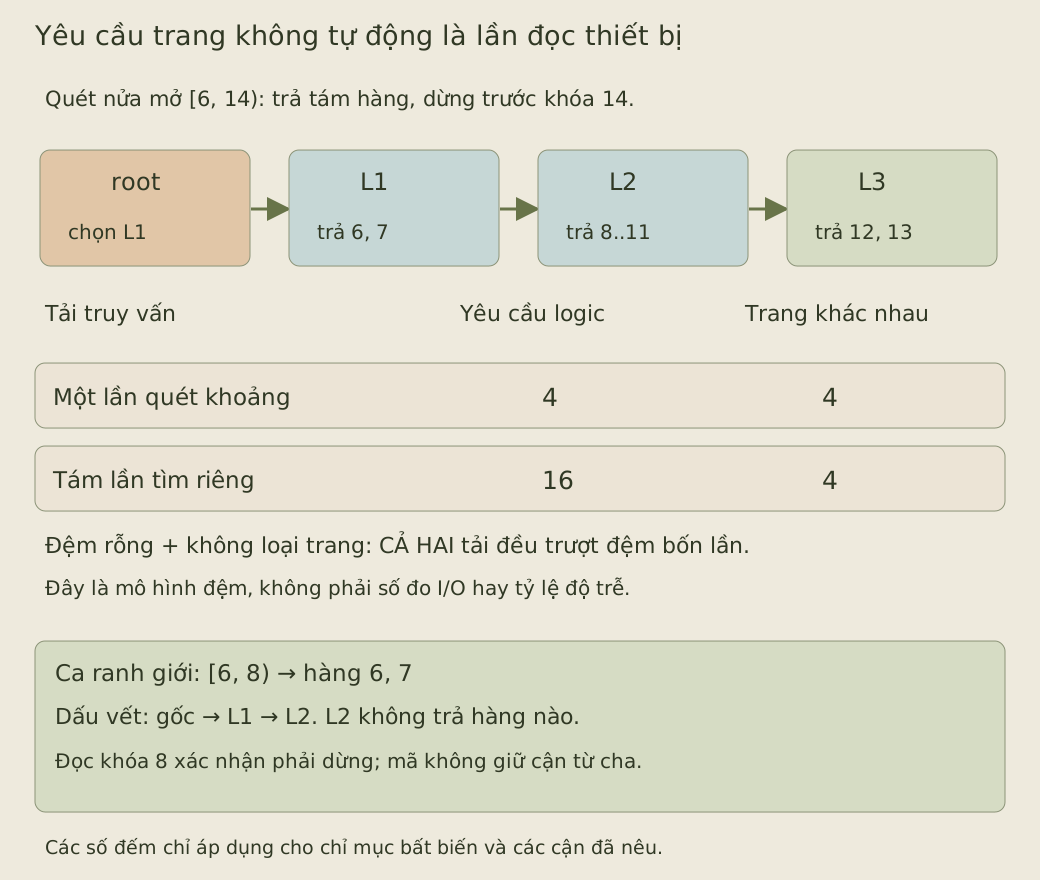
Truy vấn dùng khoảng nửa mở: lấy khóa lớn hơn hoặc bằng low, nhưng loại khóa bằng high. Với [6, 14), điều hướng theo 6 chọn L1. Phép quét bỏ qua 4 và 5, trả 6 và 7, rồi theo liên kết lá. L2 đóng góp 8 đến 11; L3 đóng góp 12 và 13. Gặp 14 thì dừng.
Đoạn sau là ví dụ đầy đủ cho Python 3.10 trở lên. read ghi lại một yêu cầu logic trước khi trả đối tượng Python vốn đã ở trong bộ nhớ. Mã không mở tệp. Các trang cố định là đầu vào được tin cậy và không bị sửa; mã không kiểm tra một chỉ mục tùy ý hay sửa chuỗi lá bị hỏng.
from bisect import bisect_right
from dataclasses import dataclass


@dataclass(frozen=True)
class Leaf:
    rows: tuple
    next_page: str | None


PAGES = {
    "root": ((4, 8, 12), ("L0", "L1", "L2", "L3")),
    **{
        f"L{i}": Leaf(
            tuple((key, f"v{key}") for key in range(4 * i, 4 * i + 4)),
            f"L{i + 1}" if i < 3 else None,
        )
        for i in range(4)
    },
}


class Index:
    def __init__(self):
        self.visits = []

    def read(self, page_id):
        self.visits.append(page_id)
        return PAGES[page_id]

    def start(self, key):
        separators, children = self.read("root")
        return children[bisect_right(separators, key)]

    def point(self, key):
        leaf = self.read(self.start(key))
        return next((row for row in leaf.rows if row[0] == key), None)

    def scan(self, low, high):
        if low >= high:
            return []
        result = []
        page_id = self.start(low)
        while page_id is not None:
            leaf = self.read(page_id)
            for row in leaf.rows:
                if row[0] >= high:
                    return result
                if row[0] >= low:
                    result.append(row)
            page_id = leaf.next_page
        return result


index = Index()
assert index.scan(6, 14) == [(key, f"v{key}") for key in range(6, 14)]
assert index.visits == ["root", "L1", "L2", "L3"]
print(index.visits)
Kết quả có tám bản ghi, nhưng dấu vết yêu cầu chỉ có bốn trang: gốc, L1, L2 và L3. Gốc giúp tìm lá đầu tiên phù hợp. Không cần quay lại gốc cho từng bản ghi tiếp theo, vì chuỗi lá giữ thứ tự khóa trên toàn bộ cây.
Ghi chú cài đặt B-tree của PostgreSQL mô tả phép quét tiến đi xuống cây lúc đầu rồi theo liên kết phải ở các lá. Tài liệu ấy còn giải thích cơ chế bổ sung khi trang thay đổi đồng thời, gồm khóa và việc nhớ đúng liên kết lá cần theo. Mô hình bất biến ở đây minh họa duyệt có thứ tự, không cung cấp các bảo đảm đồng thời đó. Nguồn được lưu lại từ nhánh phát triển, không phải cam kết cho mọi phiên bản đã phát hành.
Truy vấn thật còn có thể phải lấy hàng trong bảng. Lá của mô hình chứa toàn bộ giá trị cần trả, nên dấu vết kết thúc ở chỉ mục. Ghi chú PostgreSQL mô tả mục ở lá gồm khóa và định danh tuple trong heap; truy vấn cần trường khác của hàng có thể phải truy cập heap thêm. Vì vậy bốn yêu cầu trang trong mô hình không phải dự báo cho một truy vấn cơ sở dữ liệu bất kỳ trả tám hàng.
Tính cả trang chứng minh đã hết khoảng
Bây giờ đổi cận trên thành 8. L1 trả 6 và 7 rồi hết mục. Cài đặt này theo liên kết sang L2, đọc khóa đầu là 8, sau đó dừng mà không trả bản ghi nào từ L2. Dấu vết là gốc, L1, L2: ba yêu cầu cho hai kết quả.
Một trang được đọc nhưng không đóng góp kết quả không có gì mâu thuẫn. Nó cung cấp bằng chứng rằng khoảng cần tìm đã kết thúc. Cài đặt giữ lại cận trên phù hợp từ trang cha có thể tránh yêu cầu thêm ấy. Mô hình cố ý chỉ giữ định danh con đã chọn, nên chưa có tối ưu này. Hãy đếm hành vi của mã thay vì giả định mọi lá được đọc đều phải chứa một câu trả lời.
Chạy tiếp trong cùng phiên Python để so sánh tìm riêng từng khóa và các trường hợp biên:
scan_index = Index()
rows = scan_index.scan(6, 14)
point_index = Index()
assert [point_index.point(key) for key in range(6, 14)] == rows
assert len(scan_index.visits) == 4
assert len(point_index.visits) == 16
assert set(scan_index.visits) == set(point_index.visits)
assert len(set(scan_index.visits)) == 4

boundary = Index()
assert boundary.scan(6, 8) == [(6, "v6"), (7, "v7")]
assert boundary.visits == ["root", "L1", "L2"]
empty = Index()
assert empty.scan(8, 8) == [] and empty.visits == []
missing = Index()
assert missing.scan(20, 24) == []
assert missing.visits == ["root", "L3"]
print("logical requests:", len(scan_index.visits), len(point_index.visits))
print("distinct pages:", len(set(scan_index.visits)), len(set(point_index.visits)))
Khoảng rỗng hoặc có cận đảo ngược trả về trước khi đi xuống cây. Khoảng nằm hoàn toàn phía trên các khóa đã lưu vẫn cần gốc và lá cuối trong mô hình. Cần phân biệt truy vấn rỗng do chính hai cận của nó với một khoảng không rỗng nhưng không có bản ghi phù hợp.
Tách công việc logic khỏi lượt trượt bộ nhớ đệm
Tám lần tìm riêng đều yêu cầu gốc cùng một lá, tạo mười sáu yêu cầu logic. Phép quét khoảng tạo bốn yêu cầu. Cả hai chạm đúng cùng bốn trang khác nhau. Với bộ nhớ đệm giả định ban đầu rỗng và giữ lại mọi trang đã yêu cầu, cả hai đều có bốn lần trượt đệm; những yêu cầu lặp lại sau lần đầu của một trang sẽ trúng đệm.
Phép tính bộ nhớ đệm ấy chỉ là giả định. Buffer pool thật có thể đã chứa gốc, loại bớt trang, hoặc đọc đón trước. Bộ nhớ đệm của hệ điều hành và thiết bị tạo thêm các ranh giới khác. Trượt đệm ở một tầng không nhất thiết tạo lần đọc thiết bị vật lý. Vì vậy cả tỷ lệ bốn so với mười sáu lẫn con số bốn trang khác nhau đều chưa xác lập tỷ lệ độ trễ.
Quét vẫn tránh điều hướng lặp lại và có thể tạo mẫu truy cập thuận lợi. Nhưng kết quả toàn bộ còn phụ thuộc lấy hàng, lọc, so sánh khóa, đồng bộ và xử lý đầu ra. Hãy nói rõ đã đếm gì trước khi so sánh các cài đặt. Dấu vết yêu cầu trang giải thích thuật toán, không thay thế quan trắc cơ sở dữ liệu dưới một tải đã xác định.
Giữ dung lượng trang và chi phí cập nhật trong mô hình suy nghĩ
Khi cây lớn hơn nhiều, tìm một khóa phải qua nhiều tầng trang trong. Nhiều con trên mỗi trang có thể làm giảm số tầng, nhưng khóa lớn hơn có thể giảm số nhánh ấy. Dữ liệu lớn có thể cần vùng tràn; định dạng SQLite mô tả trang tràn cho nội dung không vừa phần dung lượng được cấp trong ô. Khi ấy chỉ đếm nút cây có thể bỏ sót các lần đọc bổ sung.
Quét một lá đầy và bất biến khá đơn giản; duy trì nó khi chèn là bài toán khác. Chèn có thể cần dịch mục, tách trang và sửa thông tin điều hướng. Xóa cùng bên đọc đồng thời tạo thêm quy tắc. Ví dụ không cài đặt các thao tác ấy, và việc mọi lá đều có đúng bốn bản ghi không phải bảo đảm về mức lấp đầy thông thường.
Để luyện tập có thể tái lập, liệt kê mọi khoảng nguyên có hai cận từ -2 đến 18 và so sánh kết quả với việc lọc danh sách mười sáu hàng ban đầu. Sau đó thêm bộ đếm cho một bộ nhớ đệm ban đầu rỗng, không loại trang, quanh read để tái hiện bốn lần trượt đệm ở cả hai tải chính. Cuối cùng thử [6, 8) và giải thích thông tin cận nào có thể loại yêu cầu đọc trang chỉ dùng để dừng. Trong mỗi thay đổi, giữ rõ thứ tự đầu ra, quy ước ranh giới và tầng đang được đếm.