Tính cosine trước khi chọn ngưỡng truy xuất
Tự tính cosine, phân biệt điểm hình học với xác suất đúng và đọc precision, recall từ một bộ cặp truy vấn có nhãn.
Độ tương đồng cosine đo góc giữa hai vector khác không. Với embedding văn bản, đại lượng này thường dùng để xếp hạng các đoạn tài liệu theo mức liên quan tới truy vấn. Điểm 0.9 không có nghĩa đoạn văn có xác suất 90 phần trăm trả lời đúng câu hỏi. Đây là đại lượng hình học; mức hữu ích của nó phụ thuộc vào model embedding và tác vụ.
Bạn có thể thấy khác biệt bằng vector hai chiều mà chưa cần gọi dịch vụ AI. Embedding văn bản thực tế thường có nhiều chiều hơn, nhưng phép tính vẫn giống nhau. Các tọa độ dưới đây được chọn để minh họa số học, không phải đầu ra đã đo của một model.
Tự tính điểm bằng vector nhỏ
Cho vector truy vấn q = (1, 0) và ba vector tài liệu a = (1, 1), b = (2, 0), c = (-1, 0). Cosine bằng tích vô hướng chia cho tích độ dài hai vector:
cosine(q, d) = dot(q, d) / (norm(q) * norm(d))

cosine(q, a) = 1 / sqrt(2) ≈ 0.707
cosine(q, b) = 2 / 2       = 1
cosine(q, c) = -1 / 1      = -1
Vector b cùng hướng với truy vấn dù dài gấp đôi. Cosine bỏ qua chênh lệch độ dài đó. Vector c ngược hướng; vector a nằm giữa hướng truy vấn và trục đứng. Những đặc điểm này do công thức xác định, không phụ thuộc cách đặt tên cho tài liệu.
Nếu cả hai vector được chuẩn hóa về độ dài một, tích vô hướng của chúng bằng cosine. Điều này có thể đơn giản hóa triển khai, nhưng việc chuẩn hóa phải là phần đã công bố của hợp đồng. Tích vô hướng thô trên các vector có độ dài khác nhau có thể cho thứ hạng khác. Vector toàn số không có độ dài bằng không, nên không xác định hướng; không thể an toàn chia cho norm của nó.
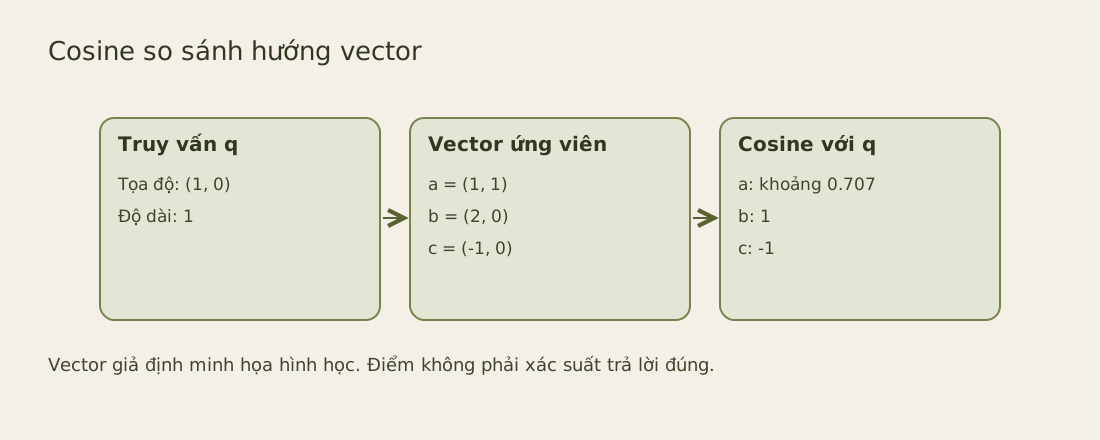
Hình nêu tọa độ được chọn và điểm đã tính. Nó không khẳng định hai vector ngược hướng biểu diễn hai nghĩa đối lập như “được duyệt” và “bị từ chối”. Hình học embedding không cung cấp bảo đảm ngôn ngữ đơn giản đó.
Gần nhau về vector vẫn có thể sai câu hỏi
Bài báo Sentence-BERT mô tả embedding câu phục vụ so sánh tương đồng hiệu quả. Hệ thống truy xuất có thể dùng dạng biểu diễn này để tìm kiếm mà không phải chạy một model lớn trên từng cặp truy vấn và tài liệu. Văn bản được nén thành vector, và quá trình đó có thể làm mất khác biệt quan trọng với ứng dụng.
Xét câu hỏi “Phụ cấp bữa ăn cho nhà thầu là bao nhiêu?” Đoạn về phụ cấp bữa ăn của nhân viên có nhiều từ và chủ đề tương tự, nên có thể xếp hạng cao dù áp dụng sai nhóm người. Đoạn về hoàn trả chi phí cho nhà thầu có thể dùng cách diễn đạt khác nhưng lại chứa đáp án. Xếp hạng tương đồng giúp chọn ứng viên; điều kiện áp dụng và nguồn hỗ trợ câu trả lời vẫn cần kiểm tra riêng.
Vì vậy siêu dữ liệu có thể quan trọng ngang khoảng cách vector. Khu vực pháp lý, phiên bản chính sách hoặc tenant có thể giới hạn tập ứng viên. Ứng dụng hoặc kho dữ liệu phải thực thi giới hạn quyền trước khi nội dung không được phép tới model. Chỉ dẫn model bỏ qua sau đó đã quá muộn để ngăn lộ dữ liệu.
Dùng đúng quy ước của model được triển khai
Hướng dẫn embeddings của OpenAI, được đọc ngày 20 tháng 9 năm 2026, mô tả tạo vector và tìm kiếm tương đồng. Hệ thống embedding khác có thể dùng tiền xử lý, số chiều, chuẩn hóa hoặc bộ mã hóa truy vấn và tài liệu riêng. Hãy đọc tài liệu của chính model được chọn.
Không so sánh vector từ hai model tùy ý chỉ vì mảng của chúng dài bằng nhau. Các chiều không tự có ý nghĩa chung giữa những model đó. Lưu mã model với từng chỉ mục và xây lại hoặc giữ chỉ mục riêng trong lúc chuyển đổi. Sai số chiều là lỗi dễ thấy; không gian vector không tương thích nhưng cùng số chiều có thể âm thầm trả kết quả trông hợp lý mà vô nghĩa.
Hàm Python sau giúp kiểm tra số học cục bộ với các giả định được thể hiện trực tiếp:
from math import sqrt

def cosine(left, right):
    if len(left) != len(right):
        raise ValueError("dimensions must match")
    left_norm = sqrt(sum(x * x for x in left))
    right_norm = sqrt(sum(x * x for x in right))
    if left_norm == 0 or right_norm == 0:
        raise ValueError("cosine is undefined for zero vectors")
    return sum(x * y for x, y in zip(left, right)) / (left_norm * right_norm)
Đây là mã tính vô hướng để minh họa, không phải khuyến nghị hiệu năng cho chỉ mục vector sản xuất. Với thư viện số học, bạn còn phải quyết định cách xử lý giá trị không hữu hạn, sai số dấu phẩy động và tính theo lô. Các kiểm tra rõ ràng giúp tránh nhầm lỗi đầu vào với chất lượng model kém.
Chọn ngưỡng từ quyết định ứng dụng cần đưa ra
Giả sử ứng dụng chỉ trả lời khi truy xuất có vẻ đủ mạnh. Tạo các cặp truy vấn và đoạn văn có nhãn, gồm nguồn liên quan, trường hợp gần giống nhưng sai điều kiện và câu hỏi không có đáp án. Chia thành tập chọn ngưỡng và tập đánh giá cuối. Ở mỗi ngưỡng ứng viên, xem còn giữ được bao nhiêu nguồn liên quan và chấp nhận bao nhiêu đoạn dễ gây trả lời sai.
Ngưỡng chọn cho câu hỏi chính sách ngắn chưa chắc dùng được cho tìm mã nguồn hay hỗ trợ đa ngôn ngữ. Ngay trong cùng lĩnh vực, model embedding mới cũng có thể đổi phân bố điểm. Lưu ngưỡng cùng phiên bản model và dữ liệu, rồi kiểm tra lại khi một trong hai thay đổi.
Đọc các lỗi phía sau ngưỡng
Một fixture có nhãn nhỏ giúp quyết định trở nên cụ thể. Giả sử tám cặp truy vấn và đoạn văn có điểm 0.92, 0.88, 0.82, 0.79, 0.70, 0.62, 0.55 và 0.30. Các đoạn thứ nhất, thứ ba, thứ tư và thứ sáu chứa đáp án với đúng điều kiện chính sách. Bốn đoạn còn lại không đáp ứng. Đây là điểm và nhãn giả định, không phải đầu ra từ dịch vụ embedding cụ thể.
pairs = [
    (0.92, True), (0.88, False), (0.82, True), (0.79, True),
    (0.70, False), (0.62, True), (0.55, False), (0.30, False),
]

def threshold_counts(threshold):
    tp = sum(score >= threshold and relevant for score, relevant in pairs)
    fp = sum(score >= threshold and not relevant for score, relevant in pairs)
    fn = sum(score < threshold and relevant for score, relevant in pairs)
    return tp, fp, fn

assert threshold_counts(0.80) == (2, 1, 2)
assert threshold_counts(0.60) == (4, 2, 0)
assert threshold_counts(0.90) == (1, 0, 3)
Ở ngưỡng 0.80, ba đoạn vượt qua: hai đoạn liên quan và một đoạn dễ gây sai. Precision là tỷ lệ đoạn liên quan trong các đoạn được chấp nhận, bằng hai phần ba; recall là tỷ lệ đã giữ trong toàn bộ bốn đoạn liên quan, bằng một nửa. Ở ngưỡng 0.60, cả bốn đoạn liên quan được giữ cùng hai đoạn sai. Trong fixture này precision tình cờ vẫn là hai phần ba, còn recall bằng một. Hạ ngưỡng không làm mọi thành viên trong tập được chọn tốt hơn; nó đổi nhóm lỗi ứng dụng phải xử lý.
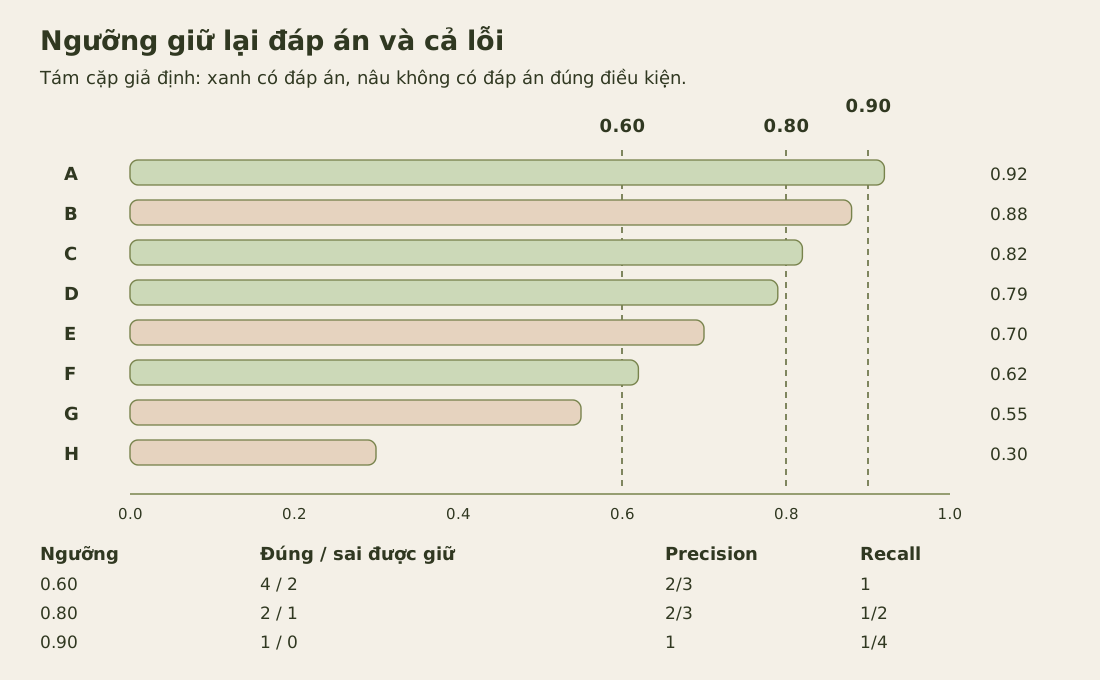
Ở ngưỡng 0.90, chỉ đoạn đứng đầu còn lại. Precision bằng một trên mẫu rất nhỏ này, còn recall bằng một phần tư. Precision của mẫu không bảo đảm điều gì cho truy vấn tiếp theo. Một đoạn gần giống nhưng sai có thể được điểm cao hơn trong tập khác. Nếu không đoạn nào qua ngưỡng, precision có mẫu số bằng không; cần báo rõ trạng thái đó thay vì âm thầm hiển thị điểm hoàn hảo.
Fixture đánh giá từng cặp truy vấn và đoạn văn. Sản phẩm lấy năm đoạn rồi viết một câu trả lời còn cần kiểm tra ở cấp truy vấn. Một đoạn đúng giữa bốn phiên bản chính sách sai chưa chắc tạo câu trả lời đúng. Ngược lại, loại tất cả đoạn có thể phù hợp khi câu hỏi không có đáp án. Định nghĩa riêng các kết quả đó thay vì tối ưu một con số theo cặp rồi gọi toàn bộ trợ lý là đáng tin cậy.
Bài The Illustrated Word2vec của Jay Alammar, xuất bản ngày 27 tháng 3 năm 2019, giới thiệu trực quan cách biểu diễn đối tượng bằng vector và so sánh trong không gian nhiều hơn hai chiều. Phép tính ở đây làm rõ giới hạn về tỷ lệ: nhân một trong hai vector khác không với một số dương không làm đổi cosine. Tính chất đó và hình minh họa dễ hiểu đều chưa xác định được ngưỡng cho ứng dụng.
Bài tập là đổi điểm của đoạn sai từ 0.88 thành 0.95, giữ nguyên nhãn. Tính lại tập được chọn ở ngưỡng cao nhất. Lúc này có một đoạn liên quan và một đoạn sai, nên precision bằng một nửa. Bài tập chỉ ra lỗi khi coi điểm hình học cao là mức tin cậy về sự thật, trong khi công thức cosine vẫn hoàn toàn đúng.
Với giao diện truy xuất ban đầu, hiển thị các đoạn xếp hạng cao cùng tên nguồn có thể trung thực hơn hiển thị cosine như phần trăm tin cậy. Người đọc có thể xem bằng chứng, còn ứng dụng đo riêng việc đoạn được lấy có chứa đáp án hay không. Phép đo ấy là cơ sở để quyết định khi nào nên đưa câu trả lời được sinh ra cho người dùng.