Bắt đầu pgvector bằng tìm kiếm chính xác trên bảng nhỏ
Chạy SQL với vector tự tính được, kiểm tra độ đo và bộ lọc tenant rồi giữ kết quả chính xác làm mốc cho chỉ mục gần đúng.
Nếu bạn là lập trình viên mới dùng pgvector và đã đọc được SQL cơ bản, hãy bắt đầu bằng tìm kiếm chính xác trên bảng nhỏ có khoảng cách tự tính được. Bảng đó tạo mốc tham chiếu cho ý nghĩa toán tử, thứ tự và bộ lọc trước khi thêm hành vi của chỉ mục gần đúng. Một truy vấn trả về văn bản có vẻ hợp lý chưa chứng minh nó dùng đúng độ đo.
README của pgvector, được đọc ngày 20 tháng 9 năm 2026, mô tả tìm kiếm vector chính xác và gần đúng. Ví dụ cài đặt trong nguồn chỉ phiên bản 0.8.6; nội dung cũng được đối chiếu với README của phiên bản đó. SQL dưới đây đã chạy trong cơ sở dữ liệu PostgreSQL 16.10 tách biệt, dùng pgvector 0.8.0, ngày 21 tháng 9 năm 2026 theo múi giờ Asia/Ho_Chi_Minh. README 0.8.6 là nguồn tham chiếu toán tử, không phải phiên bản dùng cho lần chạy cục bộ. Không có phép đo chỉ mục gần đúng hay tải công việc sản xuất.
Tạo các vector có hướng dễ nhìn
Dùng vector ba chiều để schema giống cột embedding mà số học vẫn đơn giản. Tọa độ được tạo để minh họa, không đại diện cho một model embedding văn bản thực tế.
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE demo_passages (
  id bigint PRIMARY KEY,
  label text NOT NULL,
  embedding vector(3) NOT NULL
);

INSERT INTO demo_passages (id, label, embedding) VALUES
  (1, 'same direction', '[2,0,0]'),
  (2, 'diagonal', '[1,1,0]'),
  (3, 'opposite direction', '[-1,0,0]');
Tìm với truy vấn [1,0,0]. Toán tử <=> của pgvector là khoảng cách cosine. Khoảng cách này bằng một trừ độ tương đồng cosine, nên giá trị nhỏ hơn biểu thị gần hơn theo độ đo đó.
SELECT id, label,
       embedding <=> '[1,0,0]'::vector AS cosine_distance
FROM demo_passages
ORDER BY embedding <=> '[1,0,0]'::vector, id
LIMIT 3;
Khoảng cách kỳ vọng là 0 cho vector cùng hướng, xấp xỉ 0.2929 cho vector chéo và 2 cho vector ngược hướng. Khóa sắp xếp phụ id làm thứ tự khi bằng khoảng cách trở nên xác định trong ví dụ tìm chính xác nhỏ này. Các giá trị suy ra từ tọa độ đã chọn, không phải kết quả đo hiệu năng.
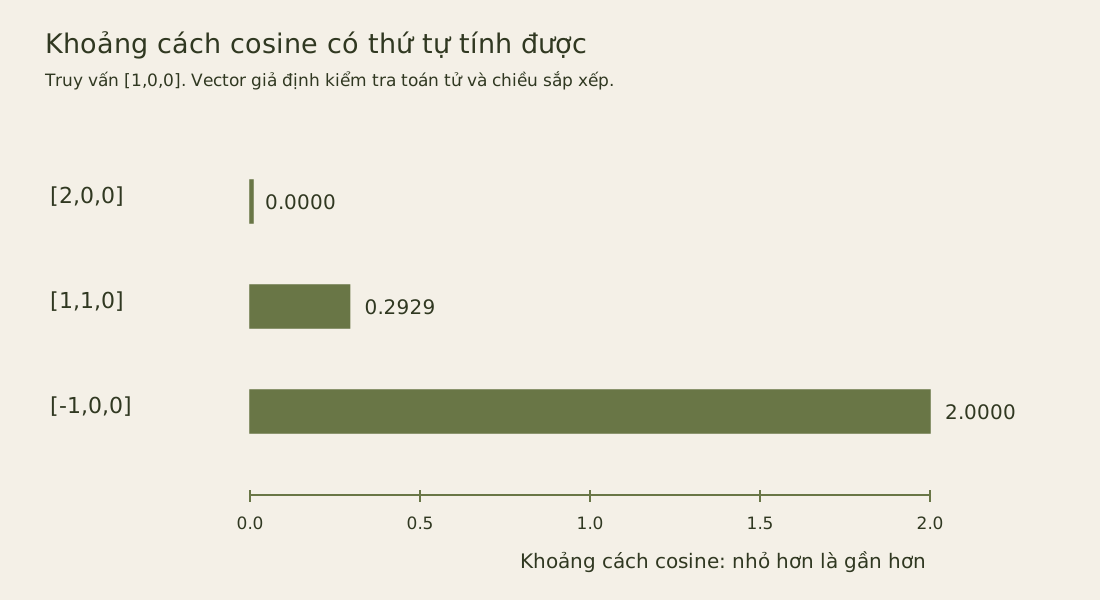
Hình nhấn mạnh việc sắp khoảng cách tăng dần. Sắp giảm dần vẫn tạo SQL hợp lệ nhưng trả vector xa nhất trước. Đây là lỗi tích hợp dễ phát hiện bằng dữ liệu nhỏ trước khi nạp cả kho tài liệu.
Xác nhận toán tử trước khi thêm chỉ mục
Các toán tử khoảng cách biểu diễn những mục tiêu khác nhau. Khoảng cách Euclid, tích vô hướng và khoảng cách cosine không thể thay thế cho nhau với vector tùy ý. Tài liệu của model embedding phải hướng dẫn lựa chọn độ đo và giả định chuẩn hóa.
Hướng dẫn embeddings của OpenAI mô tả tạo embedding và sử dụng tương đồng. Model khác có thể yêu cầu xử lý riêng cho truy vấn và tài liệu hoặc có quy ước khác. Lưu mã model và phiên bản tiền xử lý cùng chỉ mục, thay vì suy ra tương thích từ số chiều.
Sai số chiều cần thất bại rõ ràng. Vector cùng độ dài nhưng từ model không tương thích có thể qua kiểm tra kiểu mà vẫn tạo láng giềng vô nghĩa. Giữ các không gian vector riêng trong lúc chuyển đổi và so sánh chất lượng truy xuất bằng truy vấn có nhãn trước khi chuyển lưu lượng sản xuất.
Coi bộ lọc là một phần tính đúng đắn
Bảng đoạn văn thực tế có thể có tenant, phiên bản tài liệu, ngôn ngữ và mức hiển thị. Áp dụng bộ lọc quyền bắt buộc trước khi trả ứng viên cho ứng dụng. Điểm vector không được quyết định người dùng có quyền đọc tài liệu hay không.
Ví dụ, truy vấn theo tenant cần điều kiện lấy từ yêu cầu đã xác thực. Không tin mã tenant do model ngôn ngữ sinh ra. Nếu lưu đệm kết quả truy xuất, khóa cache phải giữ phạm vi đó và các điều kiện khác ảnh hưởng tập tài liệu đủ điều kiện.
Bộ lọc cũng quan trọng khi thêm chỉ mục gần đúng. Tùy chỉ mục và kế hoạch truy vấn, việc lọc có thể làm giảm số kết quả đạt điều kiện sau khi các ứng viên được duyệt. Tài liệu pgvector thảo luận tìm gần đúng có lọc và các lựa chọn điều chỉnh. Kiểm tra các đường đi đó với mốc chính xác, thay vì mặc định truy vấn LIMIT 10 luôn trả mười kết quả hợp lệ khi trong dữ liệu có đủ mười hàng.
Dùng một hàng gần nhất nhưng sai quyền để thử truy vấn
Mở rộng bảng bằng hai trường phạm vi. Giá trị mặc định gán ba hàng đã có cho tenant demo và đánh dấu đang hoạt động. Đây là bước dựng fixture, không phải chính sách chuyển đổi dữ liệu sản xuất. Hai hàng mới cùng hướng với truy vấn: một thuộc tenant khác, hàng còn lại thuộc demo nhưng đã ngừng hoạt động.
ALTER TABLE demo_passages
  ADD COLUMN tenant_id text NOT NULL DEFAULT 'demo',
  ADD COLUMN active boolean NOT NULL DEFAULT true;

INSERT INTO demo_passages (id, label, embedding, tenant_id, active) VALUES
  (4, 'other tenant', '[1,0,0]', 'other', true),
  (5, 'inactive passage', '[1,0,0]', 'demo', false);

SELECT id, label, embedding <=> '[1,0,0]'::vector AS cosine_distance
FROM demo_passages
WHERE tenant_id = 'demo' AND active
ORDER BY embedding <=> '[1,0,0]'::vector, id
LIMIT 3;
Kết quả có lọc vẫn là 1, 2 và 3. Bỏ cả hai điều kiện hợp lệ làm ba kết quả đầu trở thành 1, 4 và 5: hàng sai tenant và hàng không hoạt động đều có khoảng cách không. Đưa chúng cho model rồi yêu cầu bỏ qua đã vượt qua ranh giới truy xuất. Fixture buộc lỗi này lộ ra dù nhãn và tọa độ đều giả định.
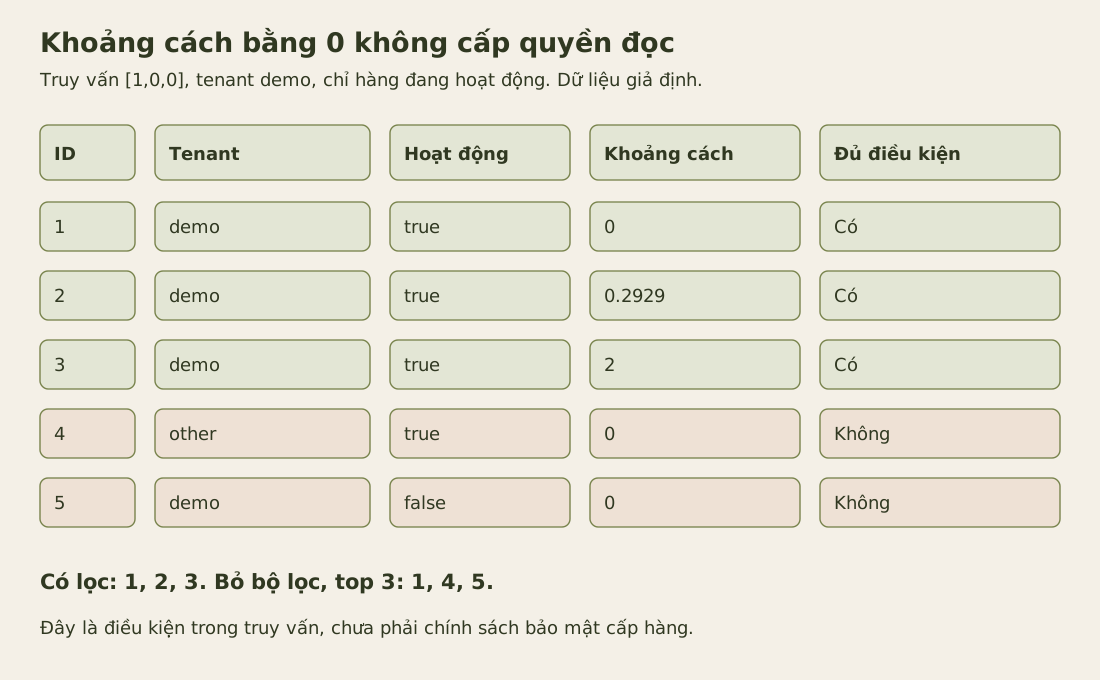
Trong ứng dụng, gắn tenant đã xác thực vào tham số truy vấn. Áp dụng cùng chính sách khi mở rộng tới tài liệu cha sau truy xuất; lọc một chunk không cấp quyền đọc mọi tài liệu lân cận. Chính sách bảo mật cấp hàng của cơ sở dữ liệu có thể bổ sung lớp thực thi nếu được thiết kế đúng cho các vai trò ứng dụng. Tuy nhiên, SQL ở đây chỉ minh họa điều kiện tường minh; nó không khẳng định vai trò cơ sở dữ liệu ấy bị ngăn bỏ điều kiện trong một truy vấn khác.
Thứ tự trả về là chính xác đối với các hàng thỏa truy vấn trong ảnh chụp cơ sở dữ liệu hiện tại. Đó là bảo đảm xếp hạng, không phải khẳng định mọi đoạn được trả đều trả lời câu hỏi. Ngay vector ngược hướng vẫn xuất hiện vì có ba hàng hợp lệ và truy vấn yêu cầu cả ba. Nếu sản phẩm cần loại các ứng viên yếu, hãy thêm và đánh giá quyết định về mức liên quan riêng; số hàng yêu cầu tự nó không biểu diễn được tiêu chí đó.
Thử thay độ đo trong một giao dịch
Vector cùng hướng có thể rất dài. Tạm đổi hàng 1 từ [2,0,0] thành [20,0,0], xem cả khoảng cách cosine và Euclid rồi rollback. Phép so sánh chỉ dùng ba hàng ban đầu để kết quả dễ đọc.
BEGIN;
UPDATE demo_passages SET embedding = '[20,0,0]' WHERE id = 1;
SELECT id,
       embedding <=> '[1,0,0]'::vector AS cosine_distance,
       embedding <-> '[1,0,0]'::vector AS l2_distance
FROM demo_passages
WHERE id IN (1, 2, 3)
ORDER BY id;
ROLLBACK;
Khoảng cách cosine vẫn là không, khoảng 0.2929 và hai. Khoảng cách Euclid lúc này lần lượt là mười chín, một và hai. Theo Euclid, hàng chéo gần nhất; theo cosine, hàng dài cùng hướng gần nhất. Không thứ tự nào là lỗi SQL: chúng trả lời hai câu hỏi hình học khác nhau. Rollback khôi phục fixture gốc để kiểm tra sau không vô tình dùng vector đã đổi.
Bài HNSW của Christopher Winslett trên Crunchy Data, xuất bản ngày 1 tháng 9 năm 2023, giải thích chỉ mục đồ thị gần đúng và khuyến nghị xem kế hoạch truy vấn. Đó là bước thử tiếp theo hữu ích sau các kiểm tra chính xác này. Phần điều chỉnh trong bài viết lịch sử không hứa hẹn kết quả cho phiên bản hiện tại, kho dữ liệu hay độ trễ truy vấn của bạn. Giữ fixture về độ đo và phạm vi làm mốc khi thêm lớp gần đúng đó.
Giữ tập kết quả chính xác làm tham chiếu
Trước khi tạo HNSW hoặc chỉ mục gần đúng khác, lưu một bản chụp kho tài liệu cố định và tập vector truy vấn đại diện. Tính các ID top-k chính xác của bản chụp. Sau đó so sánh tập kết quả gần đúng với mốc này dưới cùng độ đo và bộ lọc.
Báo recall tại k và độ trễ riêng nhau. Chỉ mục có thể trả nhanh nhưng bỏ lỡ láng giềng cần tìm; khớp hoàn toàn trên ba vector nhỏ cũng chưa nói gì về kho sản xuất lớn. Bảng nhỏ xác minh ý nghĩa truy vấn, còn tải đại diện đánh giá đánh đổi của chỉ mục.
Khi đánh giá hiệu năng, đọc kế hoạch truy vấn thật. Khóa sắp xếp phụ, biểu thức khoảng cách bị bọc trong hàm khác hoặc toán tử khác có thể ảnh hưởng việc dùng chỉ mục dự định. Không suy ra đã dùng chỉ mục chỉ vì định nghĩa chỉ mục tồn tại.
Giữ ví dụ nhỏ làm kiểm thử hồi quy
Giữ trường hợp ba vector để kiểm tra thứ tự khoảng cách và cách xử lý điểm bằng nhau. Trong phiên bản cấp ứng dụng, thêm hàng ngoài tenant người gọi và xác nhận nó không xuất hiện trong kết quả dù khoảng cách bằng không. Thêm đoạn đã xóa hoặc bị thay thế nếu sản phẩm loại những bản ghi đó.
Mốc đầu tiên hữu ích là truy vấn có kết quả dự đoán được mà không cần tin model embedding. Khi toán tử, số chiều và bộ lọc đúng, nạp embedding thực tế rồi đánh giá các đoạn được trả có trả lời câu hỏi thật hay không. Đó là những phép kiểm tra riêng, và mốc tìm kiếm chính xác giúp diễn giải cả hai.