Chọn ví dụ few-shot để làm rõ ranh giới quyết định
Chọn ví dụ gần ranh giới, tránh rò rỉ tập đánh giá và đọc kết quả theo cặp để xác định ví dụ few-shot có thực sự hữu ích.
Few-shot prompting là cách đặt một số ví dụ tác vụ ngay trong đầu vào của mô hình. Với lập trình viên xây bộ phân loại hoặc trích xuất, câu hỏi hữu ích là ví dụ nào làm rõ hành vi còn mơ hồ trong chỉ dẫn. Mười lần thành công gần như giống nhau có thể dạy ít hơn một tình huống ranh giới được chọn cẩn thận.
Giả sử trợ lý hỗ trợ khách hàng cần phân luồng tin nhắn vào thanh toán, truy cập tài khoản hoặc hỏi để làm rõ. Câu hỏi rõ ràng về hóa đơn thường không phải trường hợp khó nhất. Khó hơn là tin nhắn nhắc tới hai chủ đề hoặc dùng một từ khóa với nghĩa khác. Bộ ví dụ nên làm lộ quy tắc phân luồng trong những trường hợp đó. Các tình huống và số liệu dưới đây đều là giả định để học cách thiết kế và đánh giá prompt.
Xác định ranh giới trước khi chọn ví dụ
Giả định sản phẩm ưu tiên trở ngại đang chặn bước tiếp theo của người dùng. “Tôi không đăng nhập được để đổi thẻ thanh toán” phải tới luồng truy cập tài khoản: người dùng cần vào được tài khoản trước khi đổi thẻ. Sản phẩm khác có thể cho phép nhiều nhãn cùng lúc, nhưng khi đó tác vụ đã khác.
Bảng sau giữ nguyên các chuỗi tiếng Anh làm đầu vào kiểm thử; cột giải thích nêu rõ bài học bằng tiếng Việt. Giữ chuỗi gốc đặc biệt cần thiết với trường hợp chơi nghĩa của từ “charged”, vì dịch nguyên văn không giữ được sự mơ hồ ấy.
| Tin nhắn | Nhãn | Lý do chọn |
|---|---|---|
| I need a copy of last month’s invoice | billing | Yêu cầu hóa đơn rõ ràng |
| I cannot sign in to change my card | account_access | Trở ngại truy cập được ưu tiên dù có mục tiêu thanh toán |
| The demo will be charged with showing the new dashboard | clarify | Từ khóa không đủ để xác lập nhu cầu hỗ trợ |
| Something is wrong with my account | clarify | Chưa đủ chi tiết để chọn một luồng cụ thể |
Các câu này được tạo để minh họa. Câu thứ ba cố ý hơi gượng nhưng vẫn có thể hiểu theo ngữ pháp: “charged with” mang nghĩa được giao nhiệm vụ, không phải bị tính tiền. Nó giúp chỉ ra rằng có từ khóa chưa phải quy tắc phân loại mong muốn. Dữ liệu sản phẩm nên bổ sung các trường hợp gần giống nhưng khác nghĩa lấy từ nguồn thực tế được phép sử dụng và xử lý phù hợp, thay vì chỉ dựa vào câu nhân tạo.
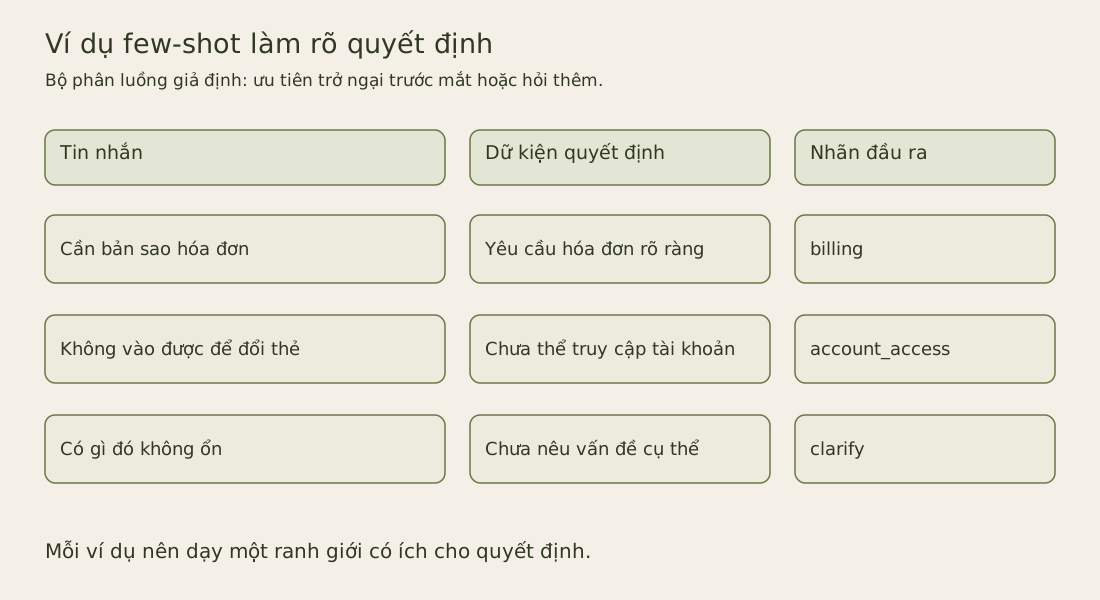
Hình cho thấy tin nhắn đổi thẻ nhận nhãn truy cập dù có nhắc mục tiêu thanh toán. Giá trị của ví dụ nằm ở quy tắc ưu tiên được chỉ rõ. Nếu quy tắc thay đổi, ví dụ cũng phải thay đổi cùng nó.
Giữ ví dụ nhất quán với chỉ dẫn
Bài báo GPT-3 đánh giá hành vi model với ví dụ được cung cấp trong ngữ cảnh. Nó thiết lập một bối cảnh nghiên cứu few-shot, không bảo đảm một số lượng ví dụ cụ thể sẽ giải quyết ứng dụng của bạn. Các ví dụ vẫn phải diễn đạt một tác vụ thống nhất.
Nếu chỉ dẫn yêu cầu chọn trở ngại trước mắt nhưng ví dụ lại gửi tin nhắn đổi thẻ sang thanh toán, prompt có mâu thuẫn. Model có thể đi theo tín hiệu này hoặc tín hiệu kia tùy câu chữ và ngữ cảnh. Hãy rà soát ví dụ như một phần đặc tả, với mức cẩn thận dành cho fixture kiểm thử.
Dùng định dạng đầu ra ổn định giữa các ví dụ. Nếu chỗ này là account_access, chỗ khác là login-help, cần quyết định chúng là từ đồng nghĩa hay hai lớp khác nhau. Chương trình nhận dữ liệu không nên phải đoán. Tách tên hiển thị cho người đọc khỏi giá trị nhãn mà ứng dụng yêu cầu.
Ưu tiên độ bao phủ thay vì lặp lại
Chọn các ví dụ khác nhau ở quyết định chúng dạy: một trường hợp rõ ràng, một tình huống mơ hồ, một trường hợp có từ khóa dễ gây nhầm và một trường hợp thiếu thông tin, nếu những khác biệt đó liên quan tới tác vụ. Không bắt buộc đúng bốn ví dụ; số lượng hợp lý phụ thuộc ranh giới cần dạy và ngân sách ngữ cảnh.
Ví dụ dài tiêu tốn token đầu vào trên mỗi yêu cầu, đồng thời có thể lấn chỗ của bằng chứng từ người dùng hiện tại. Một ví dụ ngắn giữ được dữ kiện quyết định có thể tốt hơn cả hội thoại đầy đủ. Bỏ tên, mốc thời gian và chi tiết kể chuyện không làm đổi nhãn, nhất là khi chúng đưa thêm dữ liệu cá nhân không cần thiết.
Hướng dẫn prompt của OpenAI, được đọc ngày 20 tháng 9 năm 2026, thảo luận cách dùng ví dụ và ngữ cảnh rõ ràng. Với tính năng đa ngôn ngữ, cần kiểm tra ví dụ ở một ngôn ngữ có hỗ trợ các ngôn ngữ dự định phục vụ hay không. Không mặc định bản dịch giữ nguyên mọi mơ hồ hoặc quy ước văn hóa của câu gốc.
Bảo vệ tập đánh giá chưa dùng để điều chỉnh
Tách các ví dụ model nhìn thấy khỏi tình huống dùng để ước lượng chất lượng. Nếu một tin nhắn kiểm thử xuất hiện nguyên văn trong prompt, kết quả không đo được cách hệ thống xử lý trường hợp chưa thấy. Các bản diễn đạt lại gần trùng nhau cũng có thể gây vấn đề khi giữ nguyên câu chữ đặc trưng và đáp án.
Gom các tin nhắn có quan hệ với nhau khi chia dữ liệu. Những biến thể từ cùng một hội thoại nguồn nên ở cùng một phần. Nếu không, prompt được điều chỉnh trên biến thể này có thể trông như khái quát hóa được sang biến thể khác vốn thực chất vẫn là cùng tình huống.
Ghi lại lỗi đánh giá nào đã ảnh hưởng tới việc chọn ví dụ. Khi dùng một lỗi để sửa prompt, tình huống đó đã trở thành dữ liệu phát triển. Nó vẫn có giá trị kiểm thử hồi quy, nhưng lần ước lượng khả năng khái quát hóa tiếp theo cần tập giữ riêng chưa bị dùng để điều chỉnh, thường gọi là holdout.
Kiểm tra ví dụ có đáng phần ngữ cảnh nó chiếm không
Thực hiện ablation, tức bỏ một ví dụ hoặc một loại ví dụ, trong khi giữ nguyên model, tập tác vụ và hợp đồng đầu ra. So sánh kết quả theo từng cặp trên cùng tình huống. Nếu bỏ ví dụ dễ gây nhầm làm tăng lỗi phân luồng theo từ khóa, ví dụ ấy có thể đang dạy một ranh giới hữu ích. Nếu bỏ một trường hợp thành công lặp lại không làm đổi kết quả trên tập đánh giá, prompt ngắn hơn có thể đã đủ cho tải công việc đó.
Lặp lại phép chạy khi cấu hình sinh có tính ngẫu nhiên, tránh coi một câu trả lời thay đổi là hiệu ứng ổn định. Theo dõi chi phí và độ trễ cùng chất lượng nếu ví dụ làm đầu vào dài thêm đáng kể. Quyết định thực tế là ngữ cảnh bổ sung có cải thiện tác vụ đủ để xứng đáng với chi phí vận hành hay không.
Đọc so sánh theo cặp thay vì chỉ nhìn hai tổng số
Giả sử một phép đánh giá minh họa so sánh prompt A với prompt B, trong đó B thêm ví dụ dễ gây nhầm. Hai prompt trả lời cùng 100 tin nhắn được giữ riêng. Có 70 tin nhắn đúng ở cả hai, 15 chỉ đúng với B, 5 chỉ đúng với A và 10 vẫn sai ở cả hai. Các số này chỉ minh họa cách tính, không phải quan sát từ model đã triển khai.
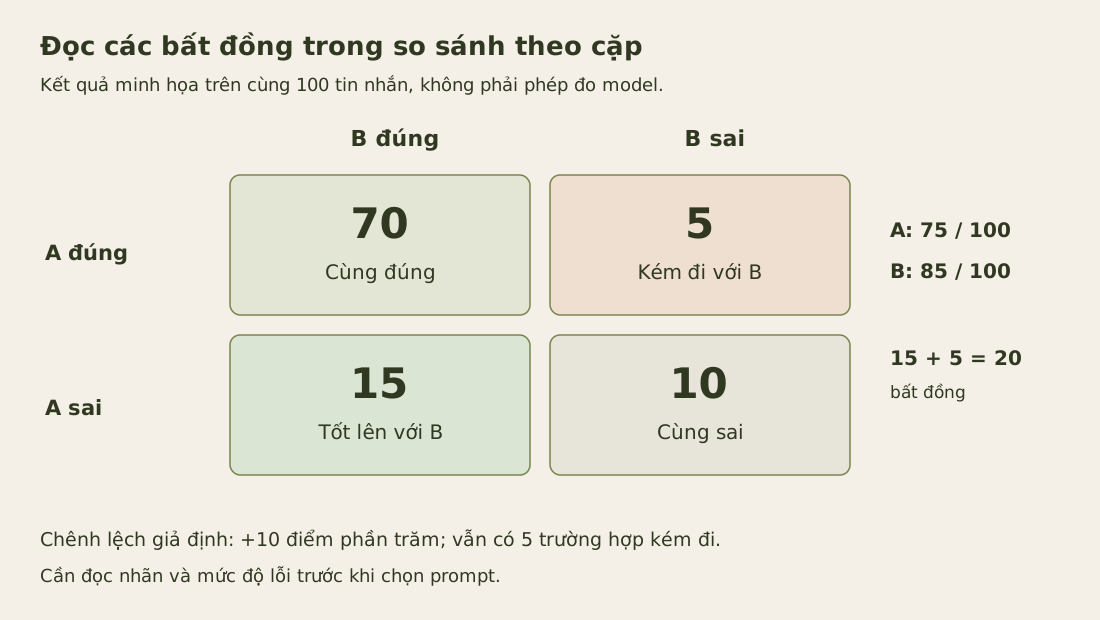
Prompt A đúng 75 tin nhắn, còn B đúng 85. Chỉ báo cáo chênh lệch tổng sẽ che mất năm trường hợp kém đi. Cần đọc hai mươi trường hợp bất đồng theo nhãn và mức độ nghiêm trọng trước khi quyết định ví dụ mới có ích cho sản phẩm. Đẩy người dùng đang bị chặn truy cập sang thanh toán có thể là lỗi đáng quan tâm dù một số câu hỏi thanh toán đơn giản được cải thiện. Những tổng số này chưa cho biết loại lỗi nào đã đổi.
def paired_summary(both_right, b_only, a_only, both_wrong):
    counts = (both_right, b_only, a_only, both_wrong)
    if any(type(n) is not int or n < 0 for n in counts):
        raise ValueError("counts must be nonnegative integers")
    n = sum(counts)
    if n == 0:
        raise ValueError("at least one paired case is required")
    return {
        "cases": n,
        "a_correct": both_right + a_only,
        "b_correct": both_right + b_only,
        "net_correct": b_only - a_only,
        "disagreements": b_only + a_only,
    }

assert paired_summary(70, 15, 5, 10) == {
    "cases": 100, "a_correct": 75, "b_correct": 85,
    "net_correct": 10, "disagreements": 20,
}
Hàm chỉ kiểm tra số học trên các cặp đã được gán nhãn. Nó không chấm câu trả lời, không tính khoảng tin cậy và không xác lập rằng ví dụ thêm vào gây ra một cải thiện ổn định. Chênh lệch độ chính xác trong tình huống giả định là mười điểm phần trăm. Muốn khái quát hóa, cần tập tác vụ đại diện và cách xử lý biến thiên do lấy mẫu dữ liệu cũng như do sinh câu trả lời. Giữ mã tình huống để tránh tính nhiều lần chạy hoặc các hội thoại có liên hệ thành những tin nhắn độc lập.
Bài tổng quan Prompt Engineering của Lilian Weng, xuất bản ngày 15 tháng 3 năm 2023, thảo luận việc chọn ví dụ và độ nhạy với thứ tự ví dụ. Dùng tổng quan nghiên cứu đó để thiết kế phép thử cho model của mình, thay vì mặc định thứ tự hiệu quả ở nơi khác sẽ chuyển sang nguyên vẹn. Trên tập phát triển, so sánh một nhóm nhỏ thứ tự đã định trước, giữ nguyên các ví dụ. Chốt thứ tự trước khi chạy holdout; chọn sau khi xem kết quả holdout sẽ biến tập ấy thành dữ liệu phát triển.
Bài tập thực hành là gán cho hai mươi trường hợp bất đồng giả định nhãn phân luồng và lý do thất bại. Sau đó xác định thông tin còn cần để chọn A hay B. Bạn cần biết hướng thay đổi và chi phí của từng lỗi, không chỉ tổng số đúng lớn hơn. Khi triển khai tiếng Việt, tạo trường hợp dễ gây nhầm quanh một cách dùng tiếng Việt thực tế: dịch từng chữ cụm “charged with” không giữ được sự đối lập với nghĩa thu phí trong tiếng Anh.
Với bộ phân luồng này, tiêu chí đầu tiên vẫn cụ thể: tin nhắn đổi thẻ phải theo quy tắc trở ngại trước mắt, còn tin nhắn mơ hồ về tài khoản cần được hỏi thêm. Điều kiện đó tạo cơ sở đánh giá rõ ràng trước khi quyết định thêm ví dụ chỉ vì prompt có vẻ đầy đủ hơn.