Tính ngân sách token trước khi thiết kế tính năng dùng mô hình ngôn ngữ
Lập ngân sách token cho trợ lý tài liệu đa ngôn ngữ, dành chỗ cho câu trả lời và xử lý đầu vào quá lớn mà không âm thầm cắt mất bằng chứng.
Khi bạn xây dựng trợ lý phục vụ người dùng quốc tế, ngân sách token phải tính mọi thứ gửi vào mô hình và để đủ chỗ cho câu trả lời. Token là đơn vị do bộ tách token của mô hình tạo ra, không phải một số từ hay ký tự cố định. Vì thế, tin nhắn trông ngắn hơn vẫn có thể chiếm nhiều dung lượng hơn một tin nhắn dài hơn ở ngôn ngữ hoặc định dạng khác.
Kho tiktoken cung cấp thư viện tách token cho các bộ mã hóa OpenAI được hỗ trợ. Ví dụ của thư viện chỉ cách chọn bộ mã hóa và đổi văn bản thành các mã token. Bộ tách chính xác phụ thuộc vào mô hình. Có thể dùng ước lượng ký tự trên token để lập kế hoạch sơ bộ, sau đó phải đếm các đầu vào đại diện bằng đúng bộ mã hóa dự kiến.
Phân bổ yêu cầu trước khi đưa nội dung vào
Giả sử ứng dụng đặt ngân sách 16.000 token cho một trợ lý. Đây là con số để học cách tính, không phải tuyên bố về giới hạn ngữ cảnh của mô hình nào. Ứng dụng dành 2.000 token cho đầu ra và 500 token dự phòng. Phần còn lại của yêu cầu được dùng tối đa 13.500 token.
Đầu vào không chỉ gồm câu hỏi người dùng. Chỉ dẫn hệ thống và nhà phát triển, schema công cụ, lịch sử hội thoại, đoạn tài liệu được truy xuất và phần đóng gói tin nhắn đều chiếm dung lượng. Nếu chỉ dẫn cùng định nghĩa công cụ dùng 2.000 token, câu hỏi hiện tại dùng 500, thì còn 11.000 cho lịch sử và bằng chứng theo ngân sách này.
| Thành phần | Token dành trước | Quy tắc |
|---|---|---|
| Chỉ dẫn và công cụ | 2.000 | Giữ hành vi bắt buộc và schema khả dụng |
| Câu hỏi hiện tại | 500 | Từ chối hoặc rút ngắn rõ ràng nếu vượt mức |
| Lịch sử | 3.000 | Giữ sự kiện cần cho yêu cầu hiện tại |
| Bằng chứng truy xuất | 8.000 | Chọn đoạn kèm các điều kiện diễn giải |
| Đầu ra | 2.000 | Dành chỗ cho câu trả lời đầy đủ |
| Dự phòng | 500 | Bù khác biệt do ước lượng và đóng gói |
Các phần cộng lại thành 16.000. Những giá trị đơn giản giúp bạn tự kiểm tra phép tính. Trong hệ thống thật, cách dành dung lượng nên dựa vào phân phối kích thước yêu cầu đã đo và quy tắc tính token được mô hình công bố.
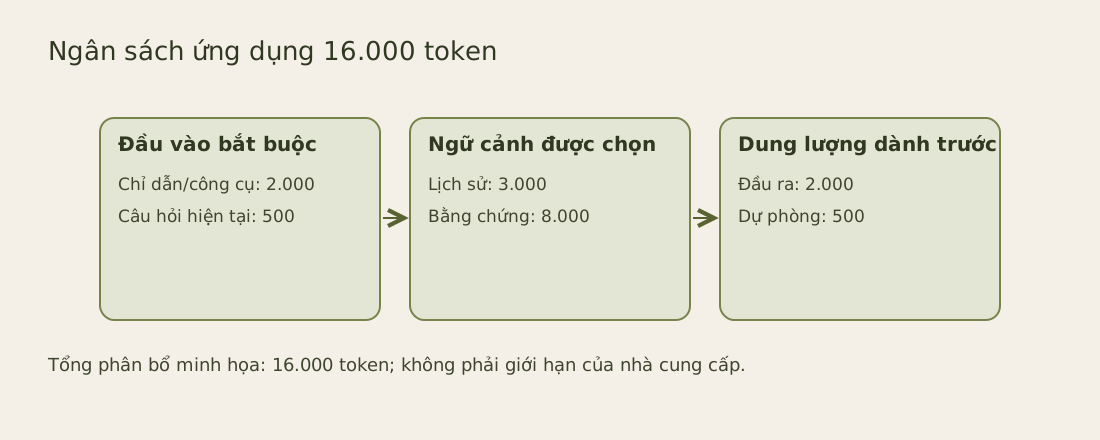
Phân bổ này làm rõ một đánh đổi: giữ thêm 2.000 token lịch sử đồng nghĩa với bỏ bớt bằng chứng, giảm chỗ cho đầu ra hoặc từ chối yêu cầu. Hàm cắt chuỗi ẩn cũng đưa ra lựa chọn tương tự, nhưng không cho lập trình viên biết yêu cầu nào đã bị hy sinh.
Đếm cả dữ liệu đa ngôn ngữ và dữ liệu có cấu trúc
Thử bộ tách token trên các kiểu nội dung mà độc giả thực sự dùng. Bao gồm tiếng Anh, tiếng Việt, mã nguồn, URL, bảng số và JSON có ký tự đã escape. Ngay cả khi trợ lý chỉ trả lời tiếng Anh, tài liệu được truy xuất hoặc tên người dùng vẫn có thể chứa chữ viết khác. Không nên mặc định số từ dự đoán chính xác số token của chúng.
Một lần kiểm tra cục bộ có thể ghi tên bộ mã hóa, hàm băm đầu vào và số token. Khi ngân sách thay đổi bất ngờ sau lần nâng thư viện, các thông tin đó giúp tái hiện nguyên nhân. Bạn không cần chép văn bản nhạy cảm vào nhật ký chung chỉ để nhớ nó dài bao nhiêu.
Bản ghi sử dụng do nhà cung cấp trả về có thể chứa cách tính mà phép đếm văn bản thuần cục bộ không bao quát. Đối chiếu một số yêu cầu đại diện với bản ghi đó. Bộ ước lượng cục bộ hữu ích cho quyết định trước khi gửi; thông tin sử dụng được trả về giúp giải thích dịch vụ thực sự xử lý và tính phí cho phần nào.
Chạy phép đếm mà người khác tái hiện được
Đoạn kiểm tra sau chọn rõ một bộ mã hóa. Nó không giả định mọi mô hình hiện tại đều dùng bộ mã hóa đó. Các chuỗi ngắn là ví dụ giả định nên việc in số đếm không làm lộ nội dung khách hàng.
Ví dụ đã được chạy với Python 3.12 và tiktoken==0.12.0 trong môi trường tách biệt ngày 20 tháng 9 năm 2026. Cài phiên bản gói đó trong môi trường dự án để tái hiện lần kiểm tra này, hoặc ghi lại phiên bản bạn chọn khi so sánh một lần nâng cấp.
import tiktoken
from importlib.metadata import version

encoding = tiktoken.get_encoding("cl100k_base")
samples = [
    "The parcel is delayed.",
    "Kiện hàng đang bị chậm.",
    '{"estimated_delivery":null,"state":"delayed"}',
]
print(version("tiktoken"), encoding.name)
for sample in samples:
    tokens = encoding.encode(sample)
    assert encoding.decode(tokens) == sample
    print(len(sample), len(tokens))
Lần chạy cục bộ cho kết quả:
0.12.0 cl100k_base
22 5
23 11
45 11
Hai câu tiếng Anh và tiếng Việt có số ký tự gần nhau nhưng số token khác nhau với bộ mã hóa này. Chuỗi JSON nhiều ký tự hơn nhưng có cùng số token với ví dụ tiếng Việt. Ba quan sát này cho thấy cần kiểm tra đầu vào thực tế; chúng không xác lập một tỷ lệ token chung cho bất kỳ ngôn ngữ nào.
Cột số đầu đếm ký tự trong chuỗi Python; cột sau đếm mã token. Không cột nào là số byte, và cả hai chưa tính toàn bộ cấu trúc tin nhắn của nhà cung cấp. Ghi phiên bản thư viện khi chạy và giữ đúng đầu vào, gồm dấu cách cùng dấu câu, khi so sánh kết quả. Đổi thư viện hoặc bộ mã hóa nên là một thí nghiệm có chủ đích, thay vì để ngân sách sản xuất thay đổi mà không biết lý do.
minbpe của Karpathy, được đọc ngày 20 tháng 9 năm 2026, giải thích cách gộp cặp ở mức byte bằng những triển khai bộ tách token ngắn, dễ đọc. Nó cho thấy lý do không nên tin vào một tỷ lệ từ trên token phổ quát: ranh giới token phụ thuộc các phép gộp đã học và bước tiền xử lý. Kho này cung cấp bối cảnh giáo dục, không xác định cách tính token của mọi nhà cung cấp hay bảo đảm mọi kiến trúc dùng cùng thuật toán.
Hãy đếm biểu diễn thực sự được gửi đi. Escape một chuỗi bên trong JSON làm thay đổi biểu diễn đó; nối những phần văn bản đã đếm riêng cũng có thể đổi ranh giới token ở chỗ nối. Ưu tiên ước lượng trên yêu cầu đã lắp ráp theo định dạng mà nhà cung cấp công bố. Nếu endpoint nhận ảnh, âm thanh hoặc dữ liệu không phải văn bản, đoạn mã này chưa đủ để tính toàn bộ dung lượng.
Giữ ý nghĩa khi giảm ngữ cảnh
Giả sử đoạn chính sách được chọn ghi “nộp hóa đơn trong vòng 14 ngày”, còn đoạn kế tiếp quy định ngoại lệ. Cắt ngữ cảnh đúng tại giới hạn token có thể bỏ mất ngoại lệ nhưng vẫn giữ một quy tắc chung nghe chắc chắn. Cách chọn tài liệu cần giữ cùng nhau các điều kiện cần để diễn giải đoạn được trích.
Lịch sử hội thoại cũng có quan hệ phụ thuộc. Người dùng có thể đã làm rõ quốc gia hoặc phiên bản sản phẩm ở lượt trước. Chỉ giữ hai tin nhắn cuối có thể xóa đúng sự kiện quyết định câu trả lời. Bản tóm tắt có thể giữ sự kiện đó, nhưng chính nó là một sản phẩm được sinh ra và có thể bỏ sót hoặc làm sai ý. Giữ tham chiếu về bằng chứng gốc khi có thể.
Hướng dẫn thiết kế prompt, được truy xuất ngày 20 tháng 9 năm 2026, bàn về việc cung cấp ngữ cảnh liên quan và chỉ dẫn rõ ràng. Thêm ngữ cảnh không tự động làm ngữ cảnh hữu ích hơn. Ứng dụng phải chọn nội dung hỗ trợ tác vụ hiện tại và phù hợp hợp đồng bằng chứng.
Quy định cách xử lý đầu vào quá lớn
Yêu cầu có thể vẫn vượt ngân sách sau khi đã bỏ lịch sử tùy chọn. Nếu chỉ dẫn bắt buộc, đầu vào người dùng và bằng chứng thiết yếu không vừa, ứng dụng cần một hướng xử lý rõ ràng. Có thể đề nghị người dùng thu hẹp câu hỏi, chia tài liệu thành các tác vụ được đánh giá riêng, hoặc chuyển sang mô hình có dung lượng phù hợp theo tài liệu.
Mỗi lựa chọn đều đổi hành vi. Chia tài liệu có thể làm mất quan hệ giữa các phần. Mô hình khác có thể khác về chất lượng hoặc khả năng tạo đầu ra có cấu trúc. Yêu cầu thu hẹp câu hỏi làm tăng thao tác cho người dùng nhưng giữ hợp đồng rõ ràng. Chọn theo yêu cầu sản phẩm, không chỉ theo lời gọi API nào chịu nhận đầu vào.
Tránh giảm phần dành cho đầu ra xuống gần bằng không chỉ để ép đầu vào đi qua. Câu trả lời dừng trước khi nói hạn chế hoặc hoàn thành đối tượng JSON gây một dạng lỗi khác. Ứng dụng cần phát hiện sinh chưa hoàn tất và không trình bày kết quả bị cắt như một câu trả lời đầy đủ.
Bộ dữ liệu kiểm thử trước phát hành có ích nên kết hợp hội thoại dài, câu hỏi đa ngôn ngữ và ngoại lệ chính sách gần ranh giới đoạn. Kiểm tra yêu cầu sau khi lắp ráp, không chỉ từng mảnh. Ghi rõ nội dung nào bị bỏ và lý do. Khi giải thích được lựa chọn cho một yêu cầu quá lớn, bạn đã có chính sách ngân sách có thể kiểm thử thay vì một phép cắt chuỗi không rõ ý nghĩa.
Làm rõ quyết định ngay tại ranh giới
Với ngân sách minh họa, 13.500 token đầu vào vừa khít sau khi dành phần đầu ra và dự phòng. Ước lượng 13.501 thì không vừa. Chênh lệch một token phải chọn nhánh xử lý vượt mức đã được mô tả, không âm thầm xóa cuối một ngoại lệ chính sách.
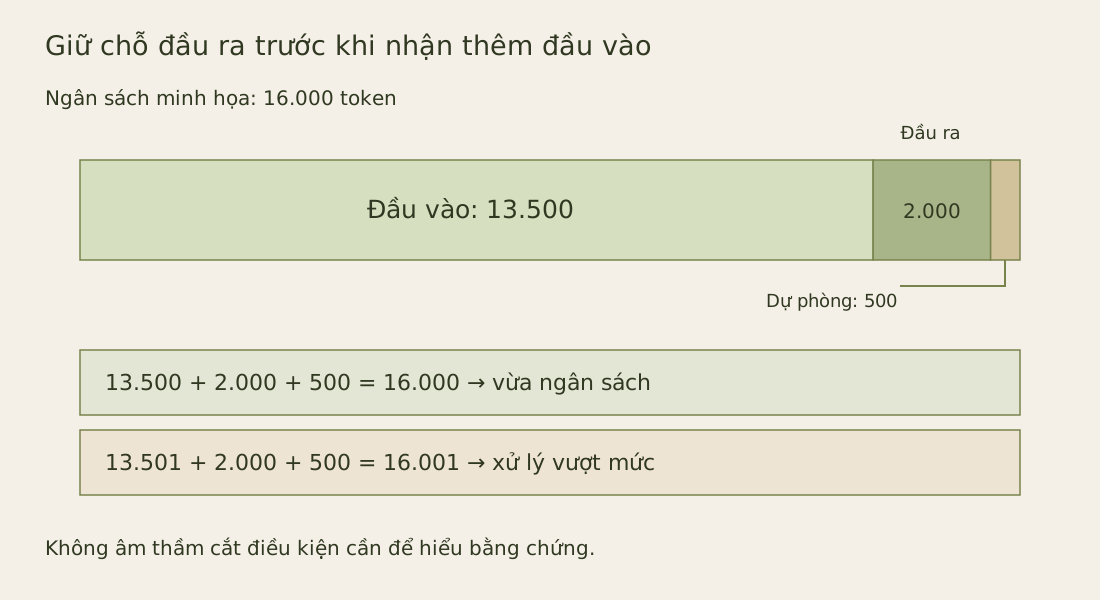
Để kiểm thử ranh giới, giữ cố định bằng chứng bắt buộc và chỉ tăng lịch sử tùy chọn. Xác nhận rằng giảm lịch sử vẫn giữ các điều kiện quốc gia, sản phẩm và ngày liên quan tới câu hỏi. Tiếp theo, làm cho riêng phần bắt buộc đã vượt dung lượng. Kết quả mong đợi là từ chối lắp ráp yêu cầu này một cách rõ ràng, rồi thực hiện hướng thu hẹp hoặc chuyển mô hình đã chọn. Kiểm thử không nên chỉ xác nhận chuỗi cuối vừa giới hạn; nó cần xác nhận bằng chứng nào còn lại và hành vi sản phẩm nào đã thay đổi.
Ngân sách ứng dụng có thể chặt hơn mức tối đa nhà cung cấp cho phép. Điều đó có thể giúp kiểm soát độ trễ hoặc lượng bằng chứng cần chọn, nhưng vẫn là quyết định sản phẩm cần quan sát thực tế. Phép tính ở đây xác định dung lượng theo phần đã dành. Nó không đo độ trễ, dự báo hóa đơn hay bảo đảm mô hình dùng đúng mọi đoạn được giữ lại.