Chọn hệ thống cơ sở để hiểu đúng kết quả LLM
So sánh phân luồng theo cùng trường hợp, tách độ khớp nhãn, coverage và lỗi trong những tin được chuyển thẳng bằng phép tính có thể chạy lại.
Với kỹ sư đang quyết định có phát hành tính năng LLM hay không, đánh giá cần một hệ thống cơ sở đại diện cho phương án thay thế đáng tin cậy của cùng tác vụ. Nếu thiếu nó, tỷ lệ thành công chưa nói được mô hình bổ sung năng lực hữu ích nào. Bài này giả định bạn đọc được hàm Python ngắn và đếm kết quả trong bảng. Với bài toán phân luồng hỗ trợ nhỏ, quy tắc từ khóa hoặc bộ phân loại đang dùng có thể hữu ích hơn điểm từ benchmark tổng quát không liên quan.
Giả sử sản phẩm phân tin nhắn vào nhóm thanh toán, truy cập tài khoản hoặc hỗ trợ kỹ thuật. Một số tin cần hỏi lại. Mục tiêu là đưa người dùng tới đúng nhóm và tránh phân sai một cách tự tin khi yêu cầu còn nhập nhằng. Đây là mục tiêu cụ thể hơn câu hỏi hệ thống nào “thông minh hơn”.
Định nghĩa nhãn trước khi so hệ thống
Viết hướng dẫn nhãn để người duyệt áp dụng mà không cần nhìn đầu ra mô hình. Thanh toán liên quan khoản phí, hóa đơn hoặc điều chỉnh tiền. Truy cập liên quan đăng nhập hoặc khôi phục quyền vào tài khoản. Kỹ thuật liên quan sử dụng sản phẩm sau khi có quyền truy cập. Tin thiếu thông tin nhận nhãn cần làm rõ.
Trường hợp ranh giới rất quan trọng. “Tôi không đăng nhập được để cập nhật thẻ” đề cập cả truy cập và thanh toán. Cần quyết định nhãn theo trở ngại trước mắt hay cho phép nhiều nhóm. Quy tắc ấy thuộc định nghĩa tác vụ. Nếu hai người dùng hai quy tắc khác nhau, phép đánh giá sẽ coi bất đồng của họ như lỗi mô hình.
Tạo tập phát triển nhỏ để viết quy tắc và prompt. Giữ tập kiểm tra riêng chưa được xem cho tới khi sẵn sàng so sánh. Thêm ví dụ gần giống như “I was charged with organizing the demo”, trong đó charged mang nghĩa được giao việc chứ không nói khoản phí. Đây là câu giả lập, không phải bản ghi khách hàng thật.
Xây dựng hệ thống cơ sở có thể kiểm tra
Hệ thống cơ sở đầu tiên có thể dùng vài quy tắc tường minh và hỏi lại khi nhiều nhóm cùng khớp. Nó phải đại diện cho phương án đơn giản có ích, không được cố ý yếu để LLM trông tốt hơn. Chỉ điều chỉnh quy tắc bằng dữ liệu phát triển.
rules = {
    "billing": {"invoice", "refund", "payment"},
    "access": {"login", "password", "signin"},
    "technical": {"crash", "export", "upload"},
}

def route(tokens):
    if not isinstance(tokens, (list, tuple)):
        raise TypeError("tokens must be a reusable list or tuple")
    if any(not isinstance(token, str) for token in tokens):
        raise TypeError("tokens must contain strings")
    vocabulary = set(tokens)
    matches = [name for name, words in rules.items() if words & vocabulary]
    return matches[0] if len(matches) == 1 else "clarify"
Đầu vào được chấp nhận là list hoặc tuple có thể duyệt lại. Chuỗi phần tử rỗng dẫn tới hỏi lại. Iterator chỉ đọc được một lần bị từ chối, thay vì vô tình bị tiêu thụ riêng cho từng nhóm. Hàm giả định token đã chuẩn hóa; nó không xử lý tốt cụm từ, phủ định hoặc nhiều ngôn ngữ. Đó là giới hạn cần đo, không phải lý do bỏ hệ thống cơ sở. Nếu sản phẩm có bộ phân loại mạnh hơn, hãy đưa nó vào làm phương án vận hành chính để so sánh.
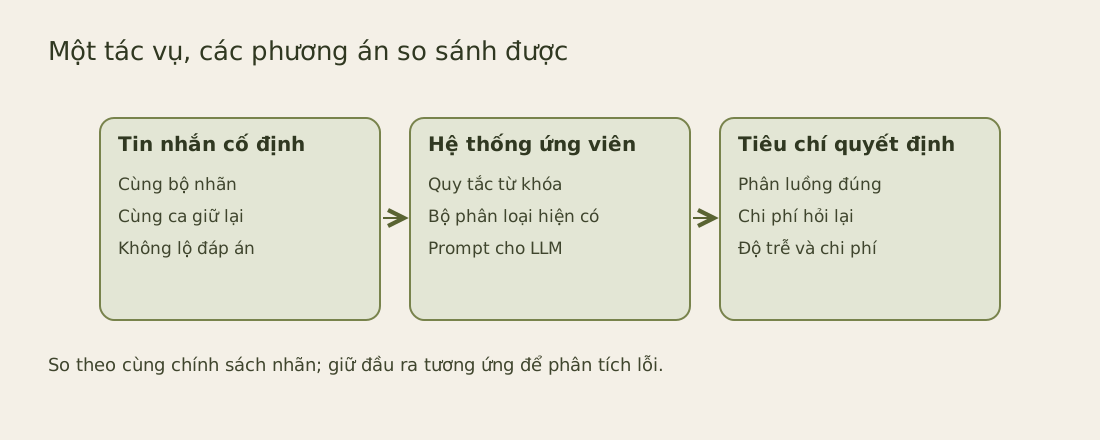
Mỗi hệ thống nhận cùng tin và được chấm theo cùng chính sách nhãn. LLM có thể nhận mô tả nhóm nhưng không được thấy đáp án giữ lại để kiểm tra. Cố định phiên bản prompt và quy tắc trước lần so cuối.
Báo cáo nhiều hơn độ chính xác tổng thể
Giả sử tập kiểm tra có tám mươi tin thanh toán và mười tin cho mỗi nhóm còn lại. Hệ thống luôn đoán thanh toán đạt tám mươi phần trăm chính xác nhưng sai mọi tin truy cập và kỹ thuật. Recall theo nhóm cùng ma trận nhầm lẫn sẽ làm lộ thất bại ấy.
Báo cáo riêng hành vi hỏi lại. Hệ thống có thể giảm phân sai bằng cách hỏi nhiều hơn, nhưng hỏi quá mức gây phiền. Cần ghi coverage, tức phần tin được chuyển thẳng vào nhóm, cùng tỷ lệ lỗi trong những tin đã chuyển. Cân bằng phù hợp phụ thuộc hậu quả của chuyển sai và khả năng người dùng chấp nhận thêm câu hỏi.
Bài báo HELM lập luận cho đánh giá trên nhiều kịch bản và thước đo thay vì một điểm hẹp. Với ứng dụng này, tiêu chí có thể gồm chuyển đúng, chuyển sai nghiêm trọng, tần suất hỏi lại, độ trễ và chi phí. Không cần chép mọi thước đo của benchmark lớn; chọn những gì có thể đổi quyết định sản phẩm.
Tính đánh đổi coverage từ đầu ra cố định
Dùng mười hai trường hợp viết thủ công theo thứ tự sau. Nhãn tham chiếu theo trở ngại trước mắt; câu “Invoice?” cố ý thiếu ngữ cảnh. Danh sách token thuộc bộ thử, nên đây không phải phép so sánh tokenizer. Đầu ra candidate được đặt ra để minh họa phép tính, không thu từ LLM.
cases = [
    ("b1", "Send my invoice", ["invoice"], "billing"),
    ("a1", "Reset my password", ["password"], "access"),
    ("t1", "Export fails", ["export"], "technical"),
    ("c1", "Help", ["help"], "clarify"),
    ("b2", "I was charged twice", ["charged", "twice"], "billing"),
    ("a2", "I cannot get in", ["cannot", "get", "in"], "access"),
    ("t2", "The invoice file will not upload", ["invoice", "upload"], "technical"),
    ("c2", "Payment or password?", ["payment", "password"], "clarify"),
    ("b3", "Where is my refund?", ["refund"], "billing"),
    ("a3", "Cannot login to view an invoice", ["login", "invoice"], "access"),
    ("t3", "Export causes a crash", ["export", "crash"], "technical"),
    ("c3", "Invoice?", ["invoice"], "clarify")
]
gold = [row[3] for row in cases]
baseline = [route(row[2]) for row in cases]
candidate = ["billing", "access", "technical", "clarify", "billing", "access",
             "billing", "access", "billing", "access", "technical", "billing"]
Hàm tổng hợp yêu cầu hai chuỗi nhãn không rỗng, cùng độ dài và chỉ dùng bốn nhãn quy định. Nó trả phân số chính xác để mẫu số vẫn rõ. Khi không tin nào được chuyển thẳng, tỷ lệ lỗi có điều kiện là None; trả số không sẽ gây hiểu nhầm rằng đã quan sát hoạt động phân luồng không lỗi. Cùng độ dài chưa chứng minh cùng mã trường hợp: hãy ghép cột theo mã ổn định trước khi gọi. Danh sách có thứ tự cố định phía trên cung cấp sự tương ứng ấy.
from fractions import Fraction

LABELS = {"billing", "access", "technical", "clarify"}

def summarize(expected, predicted):
    for sequence in (expected, predicted):
        if not isinstance(sequence, (list, tuple)) or not sequence:
            raise ValueError("labels must be a nonempty list or tuple")
        if any(not isinstance(label, str) or label not in LABELS
               for label in sequence):
            raise ValueError("unknown label")
    if len(expected) != len(predicted):
        raise ValueError("unaligned labels")
    paired = list(zip(expected, predicted))
    routed = [(want, got) for want, got in paired if got != "clarify"]
    wrong = sum(want != got for want, got in routed)
    return {
        "agreement": Fraction(sum(want == got for want, got in paired), len(paired)),
        "coverage": Fraction(len(routed), len(paired)),
        "misroute_given_routed": Fraction(wrong, len(routed)) if routed else None
    }

print(summarize(gold, baseline))
print(summarize(gold, candidate))
Hệ thống cơ sở khớp nhãn tham chiếu ở 7/12 trường hợp, chuyển thẳng 6/12 và phân sai 1/6 số đã chuyển. Candidate giả lập khớp 9/12, chuyển 11/12 và phân sai 3/11 số đã chuyển. Điểm khớp cao hơn đi cùng nhiều lần chuyển sai trực tiếp hơn và ít lần hỏi lại hơn. Các phân số chỉ mô tả danh sách được tạo ra, không ước lượng tần suất production hay chứng minh cải thiện mô hình bằng thống kê.
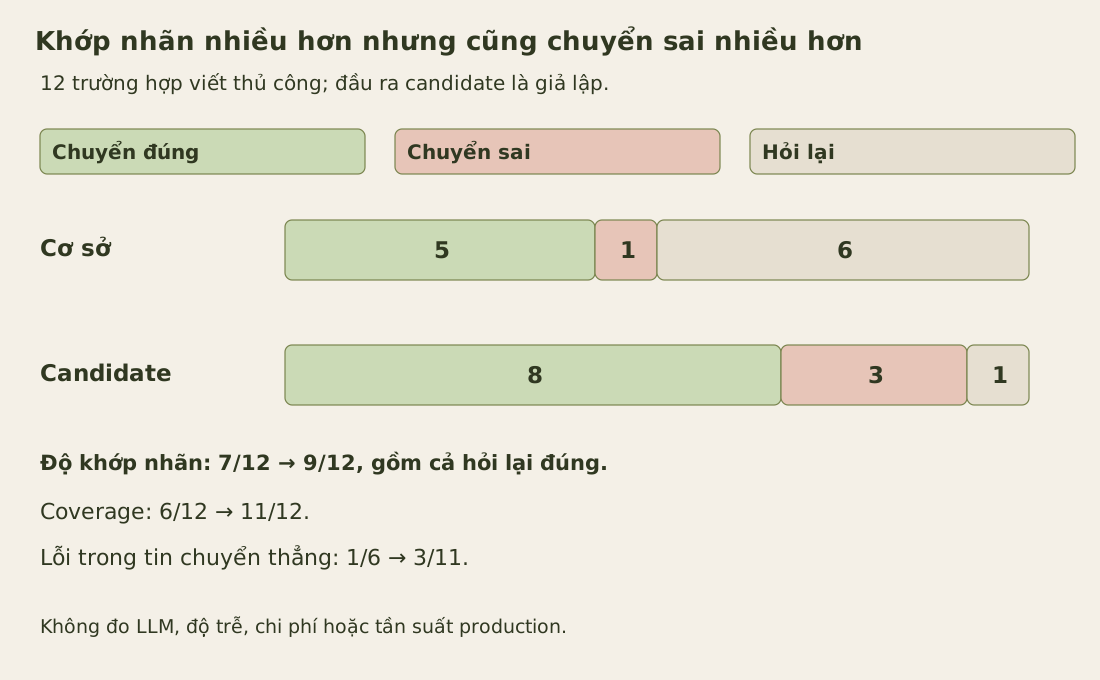
Cả hai đúng ở sáu trường hợp. Chỉ hệ thống cơ sở đúng tại c2; chỉ candidate đúng tại b2, a2 và a3. Cả hai sai tại t2 và c3. Đọc những hàng ấy trước khi đặt phạt bằng tiền hoặc ngưỡng phát hành. Hàm coi mọi lần không khớp nhãn có trọng số như nhau, trong khi sản phẩm có thể coi chuyển sai vấn đề truy cập nghiêm trọng hơn một câu hỏi thừa. Không có số đo độ trễ, hóa đơn token hoặc mức khó chịu của người dùng để âm thầm gộp thành điểm chung.
Trong Demystifying evals for AI agents, công bố ngày 9 tháng 1 năm 2026, Anthropic phân biệt tác vụ, logic chấm và kết quả được ghi, đồng thời bàn về kết hợp cách chấm cho các mặt thành công khác nhau. Ở đây, mã chỉ chấm nhãn được cung cấp; con người phải giải thích chính sách và cách dựng trường hợp. Chạy đúng phép tính không biến đầu ra candidate thành quan sát thực tế.
So từng trường hợp tương ứng
Giữ đầu ra của cả hai hệ thống cho từng tin. Cách nhìn theo cặp cho thấy LLM giải quyết điều gì quy tắc bỏ sót và trường hợp nào bị hồi quy. Xem các nhóm đó trước khi chấp nhận mức tăng trung bình. Nếu LLM hiểu diễn đạt lại tốt hơn nhưng phân sai khôi phục tài khoản, kết quả tổng hợp có thể che đánh đổi không chấp nhận được.
Lưu định danh mô hình thật, thiết lập sinh, nội dung prompt và ngày đánh giá. Nếu nhà cung cấp có định danh theo phiên bản, ghi lại. Nếu alias hosted có thể đổi, nêu giới hạn ấy. Hướng dẫn đánh giá của OpenAI, được đọc ngày 20 tháng 9 năm 2026, khuyên dùng dữ liệu đại diện cho tác vụ và đánh giá trong quá trình phát triển.
Không sửa prompt lặp lại theo tập kiểm tra cuối. Khi một trường hợp đã tác động đến lần sửa, nó thuộc lịch sử phát triển. Giữ tập chưa được dùng cho lần ước lượng tiếp theo hoặc thu thêm trường hợp được gắn nhãn độc lập. Nếu không, cải thiện có thể phản ánh việc học chính ví dụ đánh giá.
Quyết định trong phạm vi bằng chứng
Với hàng đợi nội bộ ít lưu lượng, quy tắc đơn giản có thể đủ và dễ bảo trì. Với tin quốc tế đa dạng, LLM có thể đáng chi phí nếu xử lý được cách diễn đạt và ngôn ngữ mà hệ thống cơ sở bỏ sót. Đó vẫn là giả thuyết cho đến khi có phép so tương ứng.
Điều kiện phát hành có thể yêu cầu giảm chuyển sai nghiêm trọng mà không tăng hỏi lại hoặc độ trễ quá mức. Chọn điều kiện trước khi xem số cuối. Khi ấy, kết quả trả lời câu hỏi kỹ thuật về hệ thống này, tác vụ này và tải công việc đã nêu. Nó không tạo bảng xếp hạng mô hình phổ quát.