Chọn toán học cho câu hỏi AI tiếp theo
Dùng phép tính vector, xác suất không lỗi và cập nhật hàm bậc hai để chọn kiến thức toán tiếp theo, đồng thời giữ rõ giới hạn suy luận.
Hãy chọn chủ đề toán tiếp theo từ câu hỏi bạn cần trả lời về hệ thống. Nếu đổi độ dài vector làm thứ hạng truy xuất thay đổi, hãy học phép tính điểm. Nếu tập đánh giá nhỏ không có lỗi, hãy học xem mẫu ấy hỗ trợ kết luận nào. Nếu cập nhật làm hàm mất mát tăng, hãy học quy tắc bước đi. Mỗi câu hỏi cho khái niệm trừu tượng một chỗ bám cụ thể.
Tôi dùng cách này khi lập kế hoạch chuyển sang kỹ thuật AI: ghi quan sát, tạo ví dụ số nhỏ nhất tái hiện nó rồi xác định khái niệm còn thiếu. Bài này giả định bạn biết đại số cơ bản và phép tính Python. Các ví dụ là phép tính được dựng để học, không phải mô hình đã huấn luyện, benchmark embedding hay đánh giá trên hệ thống vận hành thật.
Hỏi vì sao điểm tương tự thay đổi
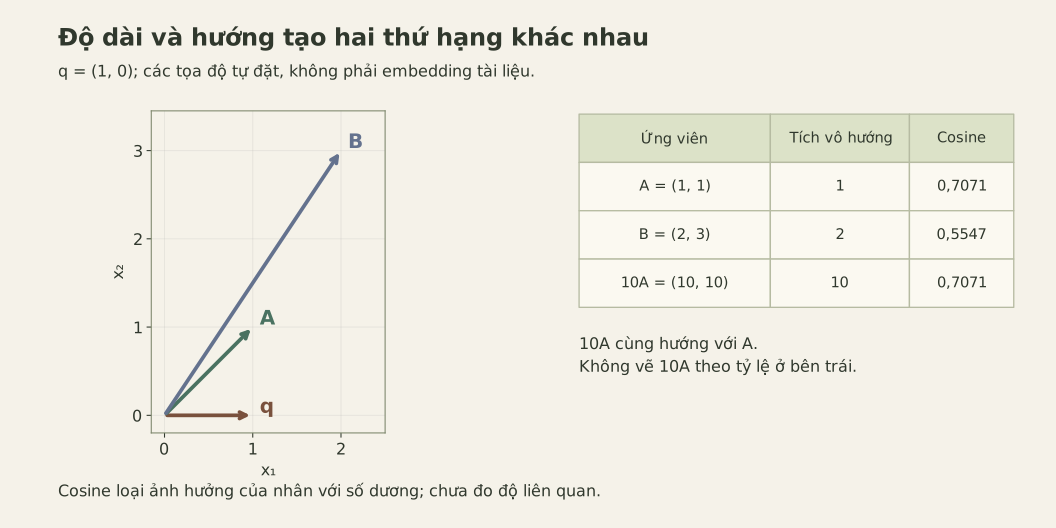
Giả sử truy vấn được biểu diễn bằng vector hai chiều q = (1, 0). So ứng viên A, (1, 1), với B, (2, 3). Các tọa độ được tự đặt. Chúng không được trích từ tài liệu, nên phép tính không cho biết người đọc sẽ thấy tài liệu nào liên quan hơn.
Tích vô hướng nhân các tọa độ tương ứng rồi cộng kết quả. Với truy vấn này, A được một điểm còn B được hai. Xếp hạng bằng tích vô hướng chưa chuẩn hóa đặt B trước. Kết quả phụ thuộc cả hướng lẫn độ dài vector.
Độ tương tự cosine lấy tích vô hướng chia cho tích hai độ dài Euclid. Truy vấn có độ dài một. A dài căn bậc hai của hai; B dài căn bậc hai của mười ba. Điểm cosine tương ứng xấp xỉ 0,7071 và 0,5547. Cosine đặt A trước vì hướng của A gần hướng truy vấn hơn.
Phần tích vô hướng trong giáo trình truy xuất thông tin của Stanford giải thích chuẩn hóa độ dài trong mô hình vector trọng số từ. Cùng phép toán vector ấy giải thích ví dụ nhỏ này. Nó chưa xác lập mọi hệ embedding đều nên chuẩn hóa, vì biểu diễn và quy tắc tính điểm dự kiến quyết định độ lớn có chứa thông tin hữu ích không.
from math import sqrt

q = (1, 0)
candidates = {"A": (1, 1), "B": (2, 3), "10A": (10, 10)}
for name, (x, y) in candidates.items():
    dot = q[0] * x + q[1] * y
    cosine = dot / sqrt(x * x + y * y)  # q has length 1
    print(name, dot, f"{cosine:.4f}")
Nhân A với mười tăng điểm tích vô hướng từ một lên mười nhưng giữ nguyên điểm cosine. Nhân với số dương giữ hướng, không giữ tích vô hướng chưa chuẩn hóa. Vector có mọi tọa độ bằng 0 không có hướng và làm mẫu số cosine bằng không, nên triển khai cần chính sách rõ ràng cho trường hợp ấy.
Chủ đề học tiếp là vector, tích vô hướng, chuẩn và chuẩn hóa. Điểm dừng hữu ích cho buổi học là dự đoán được ảnh hưởng của phép nhân với số dương và giải thích được trường hợp vector có độ dài bằng 0. Sau đó bạn có thể xem hợp đồng tính điểm của hệ truy xuất thật. Giá trị cosine không tự là xác suất đã hiệu chuẩn rằng kết quả đúng.
Hỏi không quan sát thấy lỗi nghĩa là gì
Hình dung hai mươi trường hợp đánh giá không có lỗi được quan sát. Tỷ lệ lỗi trong mẫu bằng không. Điều đó không suy ra hệ thống có xác suất lỗi bằng không trong công việc tương lai, nhất là khi các trường hợp được chọn vì dễ hoặc được sao từ cùng một mẫu.
Với bài tập xác suất nhỏ, giả định hai mươi phép thử độc lập, cùng xác suất lỗi giả định p. Xác suất không thấy lỗi là (1 - p)^20: mọi phép thử đều phải thành công. Tài liệu phân phối nhị thức của NIST cho hàm khối xác suất với xác suất mỗi phép thử cố định; thay số lỗi đếm được bằng không tạo biểu thức này.
from fractions import Fraction

for p in (Fraction(1, 100), Fraction(1, 10), Fraction(1, 5)):
    no_errors = (1 - p) ** 20
    print(f"p={float(p):.2f}: P(no errors in 20)={float(no_errors):.6f}")
Ngay cả khi tỷ lệ lỗi giả định là mười phần trăm, hai mươi quan sát không lỗi vẫn có xác suất khoảng 0,1216 theo các giả định ấy. Phép tính cho thấy kết quả đã quan sát vẫn có thể xảy ra ngay cả khi tỷ lệ lỗi là mười phần trăm. Nó không nói xác suất tỷ lệ thật bằng mười phần trăm là 12,16 phần trăm. Hai xác suất có điều kiện đi theo hai hướng khác nhau.
Chủ đề tiếp theo là biến ngẫu nhiên, tính độc lập, lấy mẫu và ước lượng khoảng. Nếu muốn xác suất hậu nghiệm về tỷ lệ lỗi, bạn cần mô hình suy luận cung cấp các giả định còn thiếu; phép tính nhị thức theo chiều thuận chưa làm điều đó. Nếu muốn khoảng tin cậy, hãy chọn và giải thích một phương pháp lập khoảng, thay vì coi tỷ lệ trong mẫu là điều chắc chắn.
Cũng cần xem các trường hợp được lấy như thế nào. Hai mươi bản viết lại hơi khác của cùng ví dụ có thể không giống hai mươi phép thử độc lập. Lặp đầu ra cho một đầu vào cố định trả lời câu hỏi khác với hiệu năng trên các nhiệm vụ người dùng đa dạng. Công thức thống kê tốt không sửa được mẫu đại diện cho quần thể khác với quần thể sản phẩm cần phục vụ.
Trong bài tập trước mắt, đổi số phép thử nhưng giữ tỷ lệ giả định. Giải thích vì sao xác suất không có lỗi giảm khi tích lũy thêm cơ hội độc lập để lỗi xảy ra. Sau đó liệt kê giả định về độc lập và lấy mẫu cần kiểm tra trước khi áp dụng lập luận vào đánh giá của bạn.
Hỏi vì sao cập nhật xuống dốc lại tăng mất mát
Xét hàm mất mát một tham số L(w) = (w - 3)^2. Nó đạt cực tiểu tại w = 3, có đạo hàm 2(w - 3). Gradient descent cập nhật tham số bằng cách trừ đạo hàm nhân với tốc độ học eta:
w_next = w - eta * 2 * (w - 3).
Tại w = 0, đạo hàm âm nên cập nhật đi sang phải về phía cực tiểu. Hướng ấy không làm mọi kích thước bước đều an toàn. Bước đủ lớn vượt qua cực tiểu và rơi xa hơn ở phía bên kia.
Bài gradient descent của 3Blue1Brown, tháng 10 năm 2017 giải thích hàm chi phí, hướng gradient âm và vai trò tốc độ học. Bài giảng của Grant Sanderson có bản chuyển thể văn bản do Josh Pullen viết. Tôi dùng hàm bậc hai một biến riêng ở đây để kiểm tra chính xác hành vi bước cập nhật; không huấn luyện mạng neural nào trong bài giảng.
from fractions import Fraction

for eta in (Fraction(1, 4), Fraction(1), Fraction(11, 10)):
    w = Fraction(0)
    states = []
    for step in range(6):
        states.append((w, (w - 3) ** 2))
        w = w - eta * 2 * (w - 3)
    print("eta =", eta)
    print("w:", [float(value) for value, loss in states])
    print("loss:", [float(loss) for value, loss in states])
Với tốc độ học một phần tư, khoảng cách tới ba giảm một nửa sau mỗi bước. Với tốc độ một, tham số luân phiên giữa không và sáu, còn mất mát luôn bằng chín. Với tốc độ 1,1, tham số liên tục vượt cực tiểu trong khi khoảng cách tăng gấp 1,2 sau mỗi bước. Cả ba trường hợp đều dùng đạo hàm đúng.
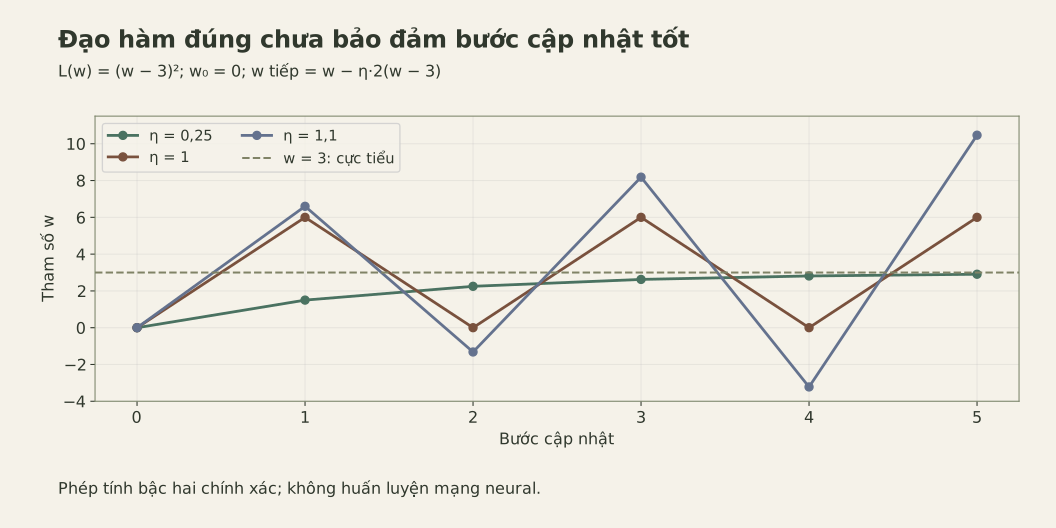
Bạn có thể suy ra ranh giới thay vì đoán. Gọi sai lệch là e = w - 3. Quy tắc cập nhật cho e_next = (1 - 2*eta) * e. Với sai lệch ban đầu khác không, độ lớn giảm khi abs(1 - 2*eta) < 1, ở đây tương đương 0 < eta < 1. Khoảng ấy thuộc hàm bậc hai và quy tắc đang xét. Nó không phải khoảng tốc độ học được khuyến nghị cho mọi mạng neural.
Chủ đề tiếp theo là đạo hàm, gradient, thay đổi cục bộ và tính ổn định của bước cập nhật. Hàm mất mát nhiều biến thêm các hướng có độ cong khác nhau; ước lượng ngẫu nhiên thêm biến động. Mất mát huấn luyện trung bình thấp hơn cũng chưa chứng minh từng ví dụ đều tốt hơn hoặc hiệu năng trên đầu vào chưa thấy đã tốt hơn. Giữ mục tiêu tối ưu tách khỏi kết quả sản phẩm mà cuối cùng bạn quan tâm.
Biến phép tính thành quyết định học
Ba ví dụ này cần bước tiếp khác nhau. Thứ hạng tương tự đổi đòi kiểm tra biểu diễn và chuẩn hóa. Kết luận quá chắc từ mẫu nhỏ đòi hiểu lấy mẫu và bất định. Cập nhật tham số không ổn định đòi hiểu hàm mất mát và động lực cập nhật. Bắt đầu ngẫu nhiên một chương trình toán đầy đủ có thể khiến các khác biệt ấy khó thấy hơn.
Viết câu hỏi học theo cách kỹ sư khác kiểm tra được: “Nhân vector này với hằng số dương có giữ điểm này không?” hữu ích hơn “học đại số tuyến tính”. Giữ ví dụ số và câu trả lời dự kiến. Khi giải thích được kết quả cùng các giả định để nó đúng, hãy chuyển tới trở ngại tiếp theo mà hệ thống thật bộc lộ.
Cách này không làm nền tảng rộng trở nên không cần thiết. Nó cho buổi học tiếp mục đích và điều kiện dừng. Đầu ra nên là lời giải thích kỹ thuật tốt hơn, gồm cả chỗ phép tính không còn đủ hỗ trợ kết luận.