Cache hai đường thay đổi một mẫu xung đột ra sao
Mô phỏng LRU và FIFO với ba khối mảng, so sánh cache cùng dung lượng và xem vì sao thêm đường vẫn có thể còn xung đột hoặc gộp tập.
Nếu tổng số byte của ba mảng nhỏ hơn dung lượng cache, các truy cập vẫn có thể liên tục miss không? Có. Cache gán mỗi khối bộ nhớ vào một tập, và mỗi tập chỉ có một số dòng ứng viên nhất định. Số đường liên kết thay đổi ràng buộc về vị trí ấy, nhưng thứ tự truy cập và chính sách thay thế vẫn quyết định khối nào được giữ lại.
Ta sẽ so sánh ba phiên bản của một cache giả định: ánh xạ trực tiếp, liên kết hai đường và liên kết bốn đường. Mỗi phiên bản lưu 1.024 byte dữ liệu trong các dòng mười sáu byte, nhận địa chỉ byte rộng mười sáu bit. Mọi ví dụ đều mô phỏng phép đọc từ cache rỗng và nạp toàn dòng ngay khi miss. Không có phép ghi, tìm nạp trước, lưu lượng duy trì nhất quán hay số đo thời gian. Bạn cần biết phép chia nguyên và phân biệt khối bộ nhớ với tập cache mà khối đó có thể nằm trong.
Giữ nguyên dung lượng khi đổi số đường liên kết
Cả ba phiên bản đều có sáu mươi tư dòng vì 1.024 chia mười sáu bằng sáu mươi tư. Ánh xạ trực tiếp tạo sáu mươi tư tập, mỗi tập một dòng. Liên kết hai đường tạo ba mươi hai tập, mỗi tập hai dòng. Liên kết bốn đường tạo mười sáu tập, mỗi tập bốn dòng. Nếu tăng số đường mà không giảm số tập, ta đã tăng dung lượng và đang trả lời một câu hỏi khác.
Với quy tắc chọn tập bằng các bit thấp trong bài, lấy địa chỉ byte chia nguyên cho mười sáu để được số hiệu khối bộ nhớ. Chỉ số tập là phần dư khi chia số hiệu khối cho số tập. Mọi đường trong tập được chọn đều là ứng viên; địa chỉ không chọn trước một đường cụ thể. Cache hit xảy ra khi một ứng viên đã chứa khối được yêu cầu.
Bài giảng Computation Structures của Chris Terman giải thích liên kết theo tập như việc tìm trong nhiều dòng ứng viên tại cùng một chỉ số tập. Chính sách lập chỉ số của gem5 tại phiên bản đã cố định cũng trả về các dòng ứng viên thuộc tập được chọn. Các nguồn này giải thích quy tắc bố trí; kích thước và chuỗi truy cập dưới đây là ví dụ riêng của bài.
Dùng byte đầu tiên của ba mảng giả định: A tại 0x0000, B tại 0x0400 và C tại 0x0800. Số hiệu khối tương ứng là 0, sáu mươi tư và 128. Cả ba đều chọn tập 0 trong từng phiên bản cache đang xét. Ta chỉ truy cập những khối đầu này, chưa nạp toàn bộ nội dung các mảng. Các khối đang dùng chứa bốn mươi tám byte, ít hơn nhiều so với tổng dung lượng cache.
Cho khối thường được dùng lại cơ hội ở trong cache
Xét sáu yêu cầu A B A C A B. Cache ánh xạ trực tiếp miss cả sáu vì mỗi yêu cầu thay dòng duy nhất ở tập 0 bằng một khối khác. Cache hai đường có thể giữ hai khối trong tập đó, nên cần quy tắc chọn khối bị thay khi cả hai dòng ứng viên đều đã có dữ liệu.
Ta dùng chính sách thay khối lâu nhất chưa được truy cập, gọi là least recently used hay LRU. Trong mỗi tập, sắp các khối đang giữ theo lần sử dụng từ cũ nhất đến mới nhất. Một cache hit đưa khối vừa được truy cập đến cuối mới nhất. Một cache miss dùng chỗ trống nếu còn; nếu không, nó loại khối cũ nhất rồi thêm khối được yêu cầu vào cuối mới nhất. Thứ tự gần đây được cập nhật khi hit lẫn khi nạp khối.
Sau khi A và B chiếm hai chỗ, thứ tự là A rồi B. Yêu cầu thứ ba hit A và đổi thứ tự thành B rồi A. Tiếp theo C miss và loại B, để lại A rồi C. Yêu cầu A kế tiếp hit và đổi thứ tự thành C rồi A. Cuối cùng B miss và loại C. Kết quả là hai hit, bốn miss; A vẫn ở trong cache qua cả hai lần nạp xen giữa.
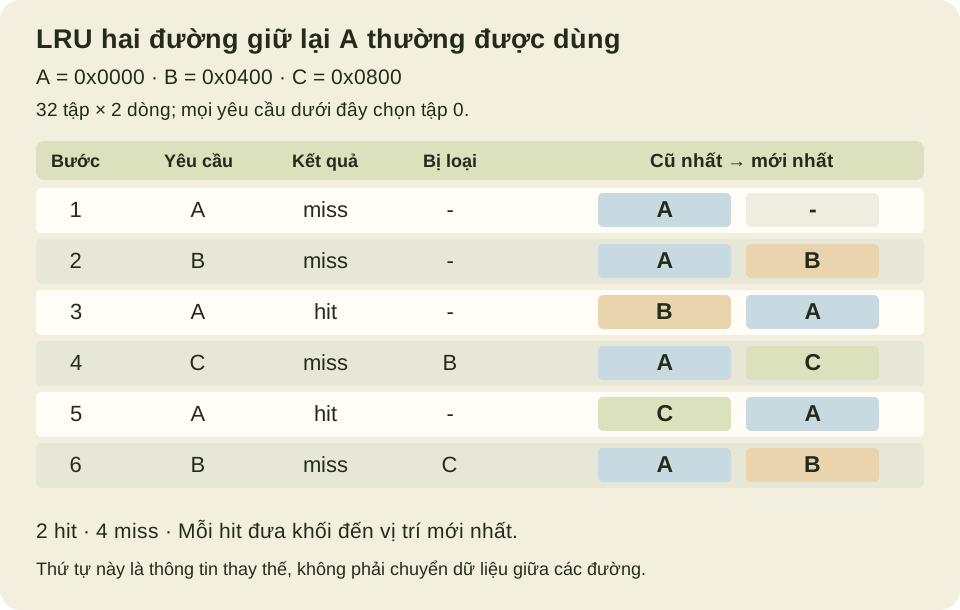
Thứ tự này là thông tin phục vụ thay thế, không có nghĩa các byte dữ liệu vật lý được chuyển giữa các đường sau mỗi hit. Phần cứng có thể cập nhật thông tin về dòng nào cũ hơn mà giữ nguyên dữ liệu tại chỗ. Triển khai LRU của gem5 tại phiên bản đã cố định ghi tick của lần truy cập gần nhất và chọn ứng viên có tick cũ nhất. Danh sách trong bài gán cho mỗi truy cập tuần tự một vị trí rõ ràng trong thứ tự gần đây; nó không tái hiện các trường hợp cùng tick của bộ mô phỏng và không chạy gem5.
Chạy cùng yêu cầu với chính sách được nêu rõ
Mô hình Python dưới đây chấp nhận ba số đường liên kết đã khai báo. Nó lưu đầy đủ số hiệu khối bộ nhớ để dễ đọc diễn tiến; tag của cache thật có thể bỏ các bit đã được xác định bởi tập được chọn. Trường order trả về các địa chỉ đầu khối đã căn chỉnh, theo thứ tự từ cũ nhất đến mới nhất. Trường evicted bằng None khi không có khối đang giữ nào bị loại.
def simulate(addresses, ways, policy="lru"):
    if type(ways) is not int or ways not in (1, 2, 4):
        raise ValueError("this experiment supports 1, 2 or 4 ways")
    if policy not in ("lru", "fifo"):
        raise ValueError("policy must be lru or fifo")
    sets = 64 // ways
    residents = [[] for _ in range(sets)]
    rows = []
    for address in addresses:
        if type(address) is not int or not 0 <= address < 65536:
            raise ValueError("address must be a built-in 16-bit unsigned integer")
        block = address // 16
        index = block % sets
        order = residents[index]
        hit = block in order
        evicted = None
        if hit:
            if policy == "lru":
                order.remove(block)
                order.append(block)
        else:
            if len(order) == ways:
                evicted = order.pop(0) * 16
            order.append(block)
        rows.append({"address": address, "set": index, "hit": hit,
                     "evicted": evicted,
                     "order": tuple(item * 16 for item in order)})
    return rows


def misses(rows):
    return sum(not row["hit"] for row in rows)


A, B, C = 0x0000, 0x0400, 0x0800
hot = [A, B, A, C, A, B]
assert [misses(simulate(hot, ways)) for ways in (1, 2, 4)] == [6, 4, 3]
assert misses(simulate(hot, 2, "fifo")) == 5
assert [row["evicted"] for row in simulate(hot, 2)] == [None, None, None, B, None, C]
print(*simulate(hot, 2), sep="\n")
Chính sách vào trước ra trước, hay FIFO, giữ thứ tự nạp ban đầu khi có hit. Trong chuỗi này, truy cập A ở yêu cầu thứ ba không bảo vệ A. C loại A ở yêu cầu thứ tư, nên yêu cầu thứ năm giờ bị miss. FIFO có một hit và năm miss. Quên cập nhật thứ tự sử dụng khi hit sẽ âm thầm đổi thuật toán, dù mã và tài liệu vẫn gọi nó là LRU.
Cả hai chính sách đều không biết truy cập tương lai. Ví dụ chỉ cho thấy lợi ích của việc giữ A trong chuỗi đã cho, không chứng minh LRU thắng với mọi workload. Bài giảng về cache thảo luận cả hai chính sách và chi phí giữ thứ tự gần đây một cách chính xác. Bộ xử lý thật có thể dùng phép xấp xỉ hoặc chính sách chèn khối khác; biết số đường liên kết chưa đủ để xác định thuật toán chọn khối bị thay.
Ba khối luân phiên vẫn vượt quá hai dòng ứng viên
Bây giờ lặp A B C ba lần. Với LRU hai đường, C loại A, yêu cầu A kế tiếp loại B, rồi yêu cầu B kế tiếp loại C. Mọi yêu cầu đều miss. Ánh xạ trực tiếp cũng miss mọi lần. Bốn đường đủ chứa cả ba khối trong tập 0: ba yêu cầu đầu miss, sáu yêu cầu sau hit.
Thất bại này liên quan đến số chỗ trong một tập, không phải tổng kích thước bốn mươi tám byte của dữ liệu đang dùng. Theo quy tắc bố trí đã chọn, tập này không thể mượn dòng trống từ các tập khác. Điều đó cũng cho thấy liên kết hai đường không có nghĩa “hai truy cập mỗi chu kỳ”. Các đường mô tả vị trí lưu trữ ứng viên; số cổng, cách chia bank và thiết kế pipeline mới quyết định thông lượng truy cập.
Chạy khối mã dưới đây sau khối đầu tiên. Nó còn kiểm tra một cách bố trí khác, trong đó cache nhiều đường hơn có nhiều miss hơn dù tổng dung lượng bằng nhau.
rotating = [A, B, C] * 3
assert [misses(simulate(rotating, ways)) for ways in (1, 2, 4)] == [9, 9, 3]

C_other = 0x0200
merged = [A, B, C_other] * 3
assert [misses(simulate(merged, ways)) for ways in (1, 2, 4)] == [7, 9, 3]
assert [row["set"] for row in simulate([A, B, C_other], 1)] == [0, 0, 32]
assert [row["set"] for row in simulate([A, B, C_other], 2)] == [0, 0, 0]
print([misses(simulate(merged, ways)) for ways in (1, 2, 4)])
Tăng số đường cũng có thể gộp những tập vốn tách biệt
Chỉ chuyển khối C được yêu cầu sang 0x0200, có số hiệu khối ba mươi hai. Ánh xạ trực tiếp đưa nó vào tập ba mươi hai, trong khi A và B vẫn tranh tập 0. Sau lần miss đầu của C, hai yêu cầu C sau đều hit vì A và B không thể loại nó. Tổng cộng có bảy miss trong chín yêu cầu.
Cache hai đường có ba mươi hai tập, nên số hiệu khối ba mươi hai quay về chỉ số tập 0. Cả ba khối giờ cạnh tranh hai dòng, và truy cập luân phiên gây chín miss. Số đường tăng nhưng số tập giảm, làm thay đổi cách bố trí. Khẳng định rằng tăng số đường không bao giờ gây bất lợi cần những giả định mà phép so sánh giữ nguyên dung lượng này không đáp ứng.
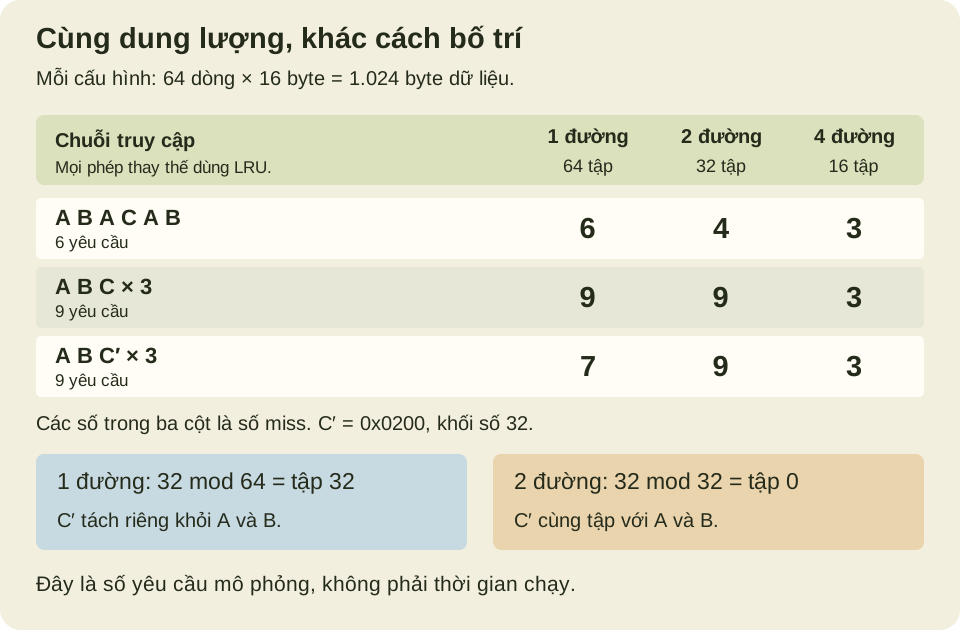
Bảng chỉ báo cáo số yêu cầu. Ít miss hơn không nhất thiết làm thời gian chạy giảm theo cùng tỷ lệ: mô hình chưa có độ trễ hit, các miss chồng lấn, hành vi của cấp nhớ tiếp theo hay phần còn lại của chương trình. So sánh nhiều tag ứng viên hơn, logic chọn dữ liệu và trạng thái thay thế cũng có thể thay đổi chi phí triển khai. Mô hình này không cung cấp số nano giây, diện tích hay năng lượng.
Để luyện tập, hãy giữ thứ tự luân phiên nhưng chuyển C đến 0x0010, tức khối số một. Nó sẽ chọn tập một trong cả ba phiên bản. Dự đoán số miss trước khi chạy: ánh xạ trực tiếp vẫn có bảy, còn hai đường và bốn đường đều có ba. A và B chỉ cùng nằm được trong một tập ở hai phiên bản có nhiều đường, trong khi C vẫn tách riêng. Thay đổi nhỏ này giúp tách ảnh hưởng của vị trí khỏi thứ tự truy cập; nó không phải khuyến nghị chung về chèn khoảng đệm vào mảng thật khi chưa kiểm tra cách lập chỉ số cache và chuyển đổi địa chỉ của bộ xử lý.