Vì sao LB và LBU tạo giá trị thanh ghi khác nhau
Theo dõi mở rộng byte E2 trên RV32 và RV64, kiểm tra biên chỉ số và ghép byte bằng kiểu không dấu đủ rộng trước khi dịch.
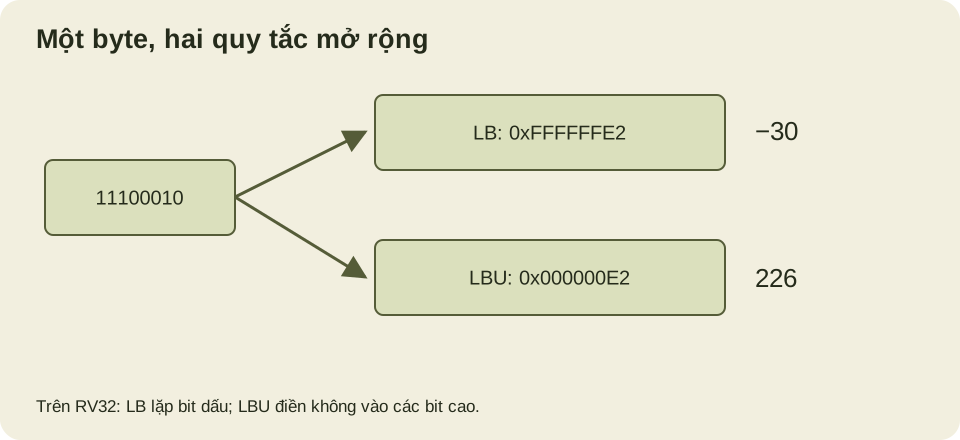
Hai lệnh RISC-V LB và LBU đọc cùng một byte nhưng mở rộng khác nhau khi đặt vào thanh ghi rộng hơn. LB mở rộng dấu; LBU thêm các bit không. Nếu bạn đang gỡ lỗi bộ phân tích hoặc phép đổi số nguyên, khác biệt đó giải thích vì sao byte nhớ 0xE2 có thể trở thành âm 30 hoặc dương 226.
Phép tính đầu dùng RV32I. Thanh ghi nguyên rộng 32 bit, còn lệnh tải đọc tám bit từ bộ nhớ. Giả sử địa chỉ hiệu dụng truy cập được và việc đọc thành công. Đặc tả tải và lưu RV32I định nghĩa quy tắc mở rộng độc lập với ý nghĩa ứng dụng gán cho byte.
Mở rộng một byte theo hai cách
Byte 0xE2 là nhị phân 11100010. Đọc như số nguyên tám bit không dấu được 226. Đọc theo bù hai có dấu được 226 - 256, tức âm 30. Bit cao nhất quyết định cách mở rộng nào giữ nguyên từng diễn giải.
LBU điền không vào 24 bit thanh ghi phía trên, cho mẫu 0x000000E2. LB sao chép bit dấu của byte, ở đây là một, vào các vị trí đó. Kết quả là 0xFFFFFFE2, biểu diễn âm 30 khi diễn giải bù hai có dấu 32 bit.
| Byte trong bộ nhớ | Kết quả LB trên RV32 | Kết quả LBU trên RV32 |
|---|---|---|
| 0x00 | 0x00000000 | 0x00000000 |
| 0x7F | 0x0000007F | 0x0000007F |
| 0x80 | 0xFFFFFF80 | 0x00000080 |
| 0xE2 | 0xFFFFFFE2 | 0x000000E2 |
| 0xFF | 0xFFFFFFFF | 0x000000FF |
Hai lệnh cho cùng kết quả khi bit cao của byte bằng không. Vì vậy, bộ kiểm tra chỉ dùng ASCII khó phát hiện việc dùng nhầm lệnh tải có dấu. Bộ phân tích có thể trông đúng cho tới khi nhận byte từ 0x80 trở lên.
Giữ giá trị khi đổi độ rộng
Mở rộng dấu hoạt động vì thêm các bit một ở đầu giữ nguyên giá trị âm bù hai. Với mẫu tám bit b có bit cao được bật, giá trị toán học là b - 256. Biểu diễn cùng số đó theo modulo hai mũ 32 cho mẫu 32 bit do LB tạo ra.
Mở rộng bằng không giữ trực tiếp giá trị không dấu. Nó đưa byte vào trường rộng hơn mà không bật bit cao nào. Mô hình Python sau kiểm tra mọi byte, đồng thời tách số toán học có dấu khỏi mẫu bit lưu trong thanh ghi.
for byte in range(256):
    signed_value = byte if byte < 128 else byte - 256
    lb_bits = signed_value & 0xffffffff
    lbu_bits = byte
    decoded_lb = lb_bits if lb_bits < 0x80000000 else lb_bits - 2**32
    assert decoded_lb == signed_value
    assert 0 <= lbu_bits <= 255
assert ((0xe2 - 256) & 0xffffffff) == 0xffffffe2
print("256 extension cases passed")
Đây là mô hình số học của hành vi lệnh đã đặc tả. Nó không giả lập lỗi trang, truy cập thiết bị hoặc định thời bộ xử lý. Những chi tiết đó thuộc môi trường lệnh tải chạy trong đó, còn mô hình chỉ xét độ rộng và diễn giải kết quả.
Tính địa chỉ không quyết định dấu của dữ liệu
Cả hai lệnh tính địa chỉ hiệu dụng từ thanh ghi cơ sở và độ lệch tức thời đã mở rộng dấu. Phép tính địa chỉ này tách khỏi việc mở rộng dấu của byte đọc về. Độ lệch âm không ngầm yêu cầu tải dữ liệu có dấu; độ lệch dương cũng không ngầm yêu cầu tải không dấu.
Chẳng hạn, lb x5, -1(x10) và lbu x5, -1(x10) cùng trỏ một địa chỉ, ngay trước giá trị trong x10 một byte. Tên lệnh khác nhau quyết định cách byte lấp đầy x5. Giữ số học địa chỉ riêng khỏi diễn giải dữ liệu giúp tránh một lỗi đọc assembly dễ gặp.
Thứ tự byte không đổi kết quả tải một byte vì chỉ có một byte để sắp xếp. Nó có ý nghĩa khi nhiều byte tạo thành giá trị lớn hơn. Bộ phân tích đọc từng byte có thể chọn dấu tường minh rồi ghép số nguyên lớn theo thứ tự byte của giao thức.
Theo dõi kiểu của ngôn ngữ lập trình
Trong C, char thông thường có thể có dấu hoặc không dấu tùy cách hiện thực. Byte đọc qua char vì thế có thể được nâng kiểu khác nhau trên các đích. Nếu giao thức quy định octet, cách biểu diễn byte không dấu tường minh làm miền không tới 255 hiện rõ. Dữ liệu cảm biến có dấu tám bit cần diễn giải có dấu tương ứng.
Khác biệt quan trọng khi dùng byte làm chỉ số mảng hoặc mở rộng trước khi dịch. Nâng 0xE2 thành âm 30 rồi dùng làm chỉ số khác với dùng 226. Ép kiểu sau phép tính chỉ số sai trước đó không sửa được truy cập. Hãy chọn kiểu ngay nơi byte bên ngoài bắt đầu mang ý nghĩa.
Trình biên dịch có thể dùng LB, LBU hoặc lệnh tải rộng hơn rồi dịch và che bit, tùy tối ưu cùng ngữ cảnh. Ngữ nghĩa nguồn đúng không đòi một chuỗi lệnh duy nhất. Khi câu hỏi là lựa chọn lệnh, hãy xem mã sinh ra; nhưng trước khi coi chuỗi khác là lỗi trình biên dịch, cần xác minh hợp đồng kiểu ở mức nguồn.
Theo dõi kiểm tra biên sau lệnh tải
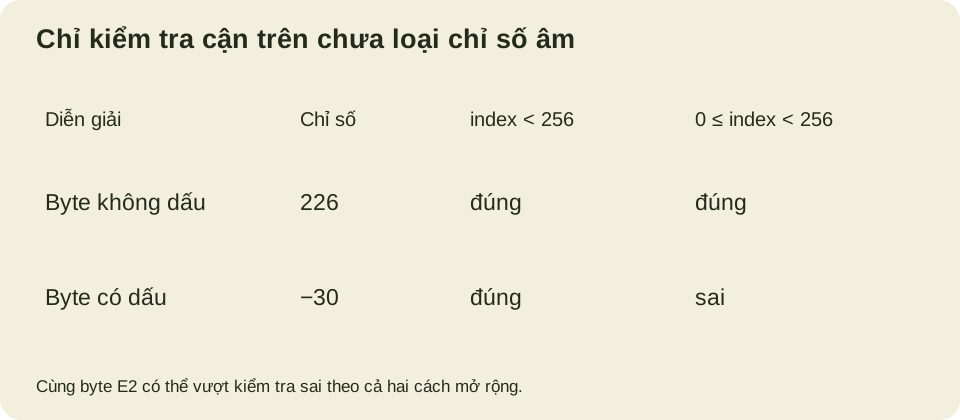
Giả sử byte chọn một phần tử trong bảng phân loại 256 phần tử. Với diễn giải không dấu, 0xE2 là chỉ số 226 và nằm trong bảng. Với diễn giải có dấu, nó là âm 30. Kiểm tra chỉ hỏi chỉ số nhỏ hơn 256 sẽ chấp nhận cả giá trị âm đó. Miền dự định cần cả cận dưới lẫn cận trên, trừ khi kiểu đã loại giá trị âm.
Đây còn là câu hỏi ngôn ngữ nguồn, không chỉ lệnh máy. Trong C, chỉ số âm ngoài miền có thể vi phạm biên mảng. Python chủ đích cho phép chỉ số âm, nên kiểm tra nhìn tương tự có thể chọn từ cuối thay vì thất bại. Với bảng đúng 256 phần tử, âm 30 thậm chí chọn cùng vị trí với 226, che lỗi biểu diễn cho tới khi kích thước bảng hoặc thao tác khác làm nó lộ ra. Một lần tra bảng thành công chưa chứng minh hợp đồng không dấu dự định được tuân thủ.
unsigned_index = 0xe2
signed_index = unsigned_index - 256
assert unsigned_index < 256 and signed_index < 256
assert 0 <= unsigned_index < 256
assert not 0 <= signed_index < 256
assert list(range(256))[signed_index] == unsigned_index

missed_lower_bounds = 0
for byte in range(256):
    value = byte if byte < 128 else byte - 256
    if value < 256 and not (0 <= value < 256):
        missed_lower_bounds += 1
assert missed_lower_bounds == 128
print("128 signed-byte cases pass an upper-only check incorrectly")
Số đếm mô tả hợp đồng chỉ số đã chọn, không phải 128 lỗi phần cứng. Cả 256 lần tải byte có thể chạy đúng trong khi phần mềm diễn giải nửa số kết quả ở miền sai. Kiểu byte không dấu tường minh biểu đạt miền đó sớm; mặt nạ thêm muộn không nên thay việc hiểu đầu vào vốn là số đo cảm biến có dấu hay octet giao thức không dấu.
Mở rộng đúng kiểu trước khi ghép trường
Xét hai byte giao thức E2 01 theo big-endian. Giá trị trường không dấu bằng 226 nhân 256 cộng một, tức 57.857. Bước mở rộng từng byte phải giữ giá trị không dấu từ không tới 255 trước khi bộ phân tích dịch nó vào trường rộng hơn. Lựa chọn này độc lập với thứ tự byte của máy chạy chương trình.
Các quy tắc nâng kiểu số nguyên và dịch bit của C11, mục 6.3.1.1 và 6.5.7, có ý nghĩa ở đây: số nguyên không dấu nhỏ vẫn có thể bị nâng kiểu trước phép dịch. Với trường bốn byte, dịch byte đã nâng tới bit 31 có thể vượt miền int có dấu dù kiểu byte ban đầu không dấu. Hãy ép sang kiểu kết quả không dấu đủ rộng trước khi dịch. Các kiểu C có độ rộng chính xác chỉ tồn tại khi cách hiện thực cung cấp biểu diễn tương ứng; bài tập sau giả định có uint8_t và uint32_t.
#include <assert.h>
#include <stdint.h>

static uint32_t assemble_be16(uint8_t high, uint8_t low) {
    return ((uint32_t)high << 8) | (uint32_t)low;
}

int main(void) {
    for (unsigned high = 0; high < 256; ++high) {
        for (unsigned low = 0; low < 256; ++low) {
            assert(assemble_be16((uint8_t)high, (uint8_t)low)
                   == high * 256u + low);
        }
    }
    assert(assemble_be16(0xe2, 0x01) == 57857u);
    assert(((uint32_t)0xe2 << 24) == UINT32_C(0xe2000000));
    return 0;
}
Kiểm tra vét cạn phép ghép hai byte này không thực thi LB hoặc LBU. Nó xác minh diễn giải ở mức mã nguồn trên cách hiện thực C đã chọn, song song với mô hình số học ISA trước đó. Hãy mở rộng thành bốn byte với độ dịch 24, 16, tám và không, giữ phép ép kiểu trước phép dịch. Sau đó kiểm tra vùng đệm byte truy cập được có các giá trị đi qua biên 0x7F sang 0x80, để lựa chọn tải và nâng kiểu do trình biên dịch tạo có ranh giới ý nghĩa cần giữ.
Lặp phép tính trên RV64
Trên RV64, thanh ghi đích rộng 64 bit. LB với 0xE2 tạo 0xFFFFFFFFFFFFFFE2; LBU tạo 0x00000000000000E2. Đặc tả RV64I mô tả mô hình thanh ghi rộng hơn và hành vi tải bổ sung.
Số bit được mở rộng thay đổi, nhưng giá trị toán học có dấu vẫn là âm 30. Đầu ra kiểm tra nhạy với độ rộng nên in đủ chữ số hex để lộ phần mở rộng đó. Trình gỡ lỗi chỉ hiển thị byte thấp sẽ làm hai kết quả trông giống nhau.
Tập hồi quy gọn gồm 0x00, 0x7F, 0x80 và 0xFF, rồi bổ sung byte từ giao thức thực. Các giá trị biên này thử hai phía của chuyển dấu. Khi trường đã giải mã bất ngờ âm, hãy xem đường tải và nâng kiểu trước khi nghi thứ tự byte hay nguồn dữ liệu.