Chia theo người khi cần dự đoán cho người chưa gặp
So sánh lỗi tra cứu khi chia theo bản ghi và theo người, rồi xây dựng các khối liên thông để đồng thời tách người nói và thiết bị.
Hãy chia dữ liệu theo người nếu kết luận cần áp dụng cho những người chưa xuất hiện trong tập huấn luyện. Chia theo bản ghi âm có thể trả lời một câu hỏi khác vẫn hữu ích: hệ thống xử lý bản ghi mới của một người đã biết tốt đến đâu. Cần xác định lần gặp nào trong tương lai là mục tiêu trước khi xem điểm đánh giá.
Người đọc cần phân biệt được tập huấn luyện với tập kiểm tra và đọc được một hàm Python ngắn. Một bộ phân loại đơn giản có chủ ý sẽ làm rõ ranh giới thông tin. Ví dụ thứ hai cho thấy việc đồng thời tách người nói và thiết bị có thể đòi hỏi các khối lớn hơn nhóm của từng mã định danh riêng lẻ. Cả hai ví dụ đều không đo chất lượng mô hình tiếng nói hay dịch vụ đang vận hành.
Tám bản ghi giống nhau, hai câu hỏi khác nhau
Giả sử bốn người nói giả lập, mỗi người có hai bản ghi. Nhãn nhị phân cố định theo người: A có nhãn 0, B có nhãn 1, C có nhãn 1 và D có nhãn 0. Quy tắc tra cứu được phép nhận mã người nói, ghi nhớ nhãn của những người trong tập huấn luyện và dự đoán 0 cho người chưa gặp. Giá trị mặc định này được chọn trước khi mở bất kỳ tập kiểm tra nào.
Quy tắc cố tình đơn giản hóa thực tế để tách riêng một cơ chế. Mô hình thực có thể nhận ra một phần danh tính từ giọng nói hoặc điều kiện thu âm dù đầu vào không chứa mã người nói trực tiếp. Khả năng đó cần được khảo sát trên bài toán cụ thể; ví dụ này không chứng minh một cách biểu diễn dữ liệu nào đó nhận diện được con người.
Khi chia theo bản ghi, ta huấn luyện trên A1, B1, C1, D1 rồi kiểm tra trên bản ghi thứ hai của họ. Khi chia theo người nói, ta huấn luyện trên cả hai bản ghi của A và B, rồi kiểm tra trên cả hai bản ghi của C và D. Cả hai cách đều có bốn hàng huấn luyện và bốn hàng kiểm tra. Thông tin mà quy tắc được tiếp cận khác nhau.
from fractions import Fraction

labels = {"A": 0, "B": 1, "C": 1, "D": 0}
recordings = [(f"{s}{i}", s, y)
              for s, y in labels.items() for i in (1, 2)]

def fit_lookup(train):
    known = {}
    for _, speaker, label in train:
        if speaker in known and known[speaker] != label:
            raise ValueError("this example requires a stable speaker label")
        known[speaker] = label
    return known

def error_rate(train, test):
    if not test:
        raise ValueError("an empty test set has no error rate")
    known = fit_lookup(train)
    wrong = sum(known.get(speaker, 0) != label
                for _, speaker, label in test)
    return Fraction(wrong, len(test))

row_train = [r for r in recordings if r[0].endswith("1")]
row_test = [r for r in recordings if r[0].endswith("2")]
group_train = [r for r in recordings if r[1] in {"A", "B"}]
group_test = [r for r in recordings if r[1] in {"C", "D"}]
print(error_rate(row_train, row_test))
print(error_rate(group_train, group_test))
assert {r[1] for r in group_train}.isdisjoint(
    {r[1] for r in group_test})
Hai kết quả lần lượt là 0 và 1/2. Với cách chia theo bản ghi, nhãn của mọi người trong tập kiểm tra đã được lưu. Với cách chia theo người, quy tắc dự đoán 0 cho C và D, nên sai ở hai bản ghi của C. Sai số lớn hơn không phải do số hàng huấn luyện ít hơn. Nó phản ánh việc chuyển từ nhận ra người đã có dữ liệu sang xử lý người chưa có dữ liệu.
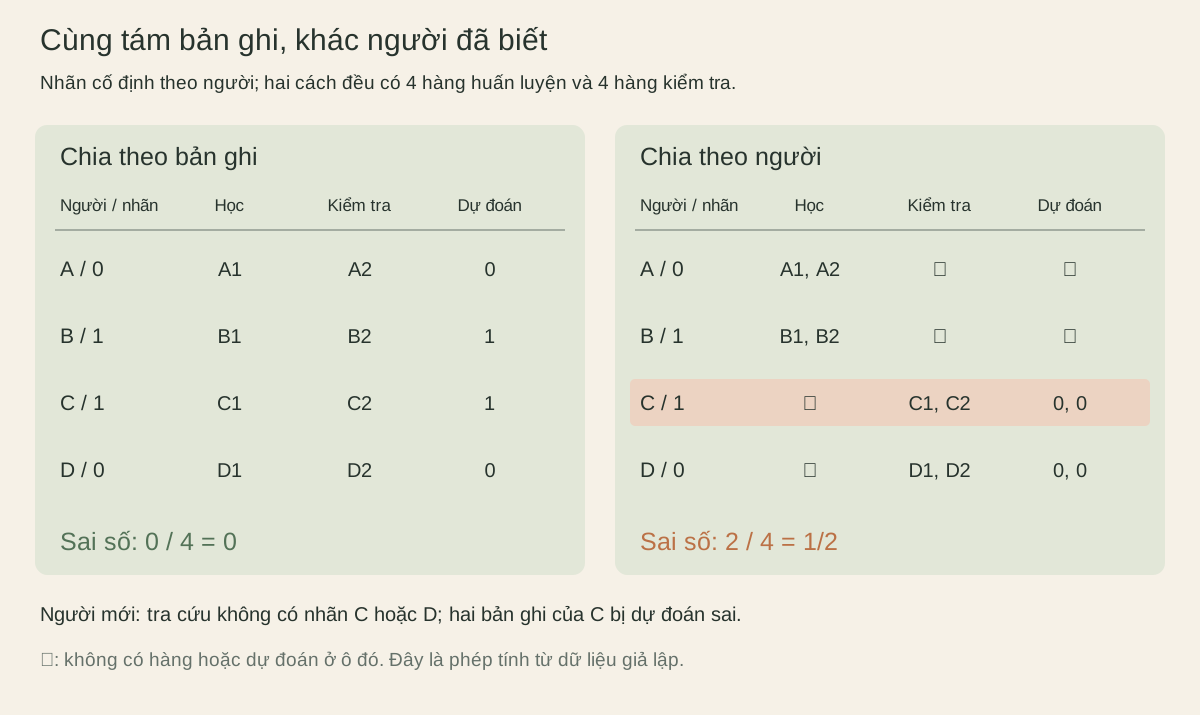
Hai cột dùng cùng bộ nhãn giả lập và cùng bốn hàng huấn luyện. Màu ô chỉ ra thông tin có sẵn trước lúc dự đoán; đây không phải độ chính xác đo được của một mô hình thực.
Hướng dẫn đánh giá theo nhóm của scikit-learn giải thích sự khác biệt này qua các quan sát phụ thuộc vào cùng một đối tượng. Bộ chia đảm bảo tách các mã nhóm được cung cấp. Nó không thể quyết định những mã ấy có mô tả đúng ranh giới triển khai hay không.
Phân biệt ví dụ chính xác với kết luận chất lượng tổng quát
Có thể đặt một mô hình xác suất nhỏ phía sau ví dụ. Gán cho mỗi người một nhãn nhị phân độc lập, hai giá trị có xác suất bằng nhau, rồi chép nhãn đó vào cả hai bản ghi. Giữ nguyên hai cách chia và quy tắc tra cứu. Trong 16 cách gán nhãn đồng xác suất, sai số kiểm tra theo bản ghi luôn bằng 0. Sai số kiểm tra theo người bằng 0, 1/2 hoặc 1 với xác suất tương ứng 1/4, 1/2 và 1/4, nên kỳ vọng bằng 1/2.
Nhãn của mỗi người chưa gặp độc lập với toàn bộ thông tin mà quy tắc đã học. Nhiều bản ghi của cùng người không tạo ra nhiều nhãn mới độc lập. Điều này giải thích chênh lệch kỳ vọng trong mô hình đã nêu; nó không phải định lý rằng chia theo hàng luôn cải thiện một điểm số cụ thể. Nếu tất cả người nói có nhãn 0, cả hai sai số đều bằng 0. Nếu nhãn thay đổi theo bản ghi, giả định nhãn ổn định của quy tắc tra cứu không còn đúng và mã sẽ từ chối các nhãn huấn luyện mâu thuẫn.
Đánh giá trên bản ghi mới có thể phù hợp với hệ thống cá nhân hóa có quy trình đăng ký người dùng rõ ràng. Nhưng đánh giá vẫn phải tuân theo thời điểm và quyền truy cập thông tin của quy trình đó. Một bản ghi thu trước khi đăng ký không được hưởng lợi từ nhãn chỉ có sau này. Vì thế, có thể cần thêm ràng buộc thời gian bên trong từng người đã biết, đồng thời đánh giá riêng những người mới.
Kiểm tra đúng danh tính mà kết luận đề cập
Lưu danh sách phân chia cùng phiên bản dữ liệu đầu vào. Kiểm tra hai tập mã nhóm không giao nhau sau các bước nối bảng, lọc và tạo đặc trưng. Một phép kiểm tra chuỗi tài khoản không trùng nhau chỉ xác nhận sự tách biệt của chuỗi tài khoản. Nếu A1 dùng tài khoản a_old còn A2 dùng a_new, phép kiểm tra đó vẫn có thể đạt dù cùng một người xuất hiện ở cả hai phía.
Khi nhiều mã đại diện cho một người, cần dùng ánh xạ có tài liệu mô tả và được kiểm soát truy cập. Thiếu danh tính không chứng minh đó là một người mới: gán mã tạm khác nhau cho từng hàng thiếu sẽ tạo ra vẻ độc lập giả. Loại các hàng chưa xác định làm thay đổi phạm vi quần thể được đánh giá; giữ chúng trong một khối chưa xác định có chi phí khác. Hãy nêu chính sách đã chọn và lượng dữ liệu chịu ảnh hưởng.
Cân bằng lớp cũng có giới hạn. Nếu mọi mẫu dương đều thuộc một người, ba tập kiểm tra không trùng người không thể cùng chứa một người dương. Phân tầng có thể tìm cách cân bằng mà vẫn giữ nguyên nhóm, nhưng không thể tạo ra các mẫu độc lập còn thiếu. Hướng dẫn cũng giải thích rằng cách chia nhóm phân tầng tham lam có thể mất cân bằng ngay cả khi tồn tại cách phân chia tốt hơn. Cần báo cáo số nhóm và số nhãn, thay vì xem tên bộ chia là bằng chứng bài toán có lời giải phù hợp.
Hai yêu cầu tách biệt tạo thành các khối liên thông
Bây giờ giả sử kết luận phải áp dụng đồng thời cho người nói mới và thiết bị mới. Xét sáu mã bản ghi với cặp người/thiết bị: r1 A/X, r2 A/Y, r3 B/Y, r4 C/Z, r5 D/Z và r6 D/W. Đây là bảng quan hệ thành viên riêng để minh họa, không phải quan sát bổ sung cho điểm tra cứu ở trên.
Nhóm theo bộ đôi (speaker, device) chưa đủ. Mọi bộ đôi trong bảng đều khác nhau, nhưng r1 và r2 cùng thuộc A, còn r2 và r3 cùng dùng Y. Nếu mỗi danh tính dùng chung phải nằm trọn ở một phía, yêu cầu đó sẽ truyền dọc theo chuỗi. Ba bản ghi đầu tạo thành một khối liên thông; ba bản ghi cuối tạo thành khối khác.
Hàm union-find ngắn dưới đây xây dựng các khối ấy bằng cách hợp nhất những tập có liên kết. Đầu vào là các bộ ba không rỗng chứa mã chuỗi đã chuẩn hóa, không để trống; mã bản ghi phải duy nhất. Khóa người nói và khóa thiết bị thuộc hai miền riêng, nên cùng cách viết trong hai miền không tạo ra liên kết giả. Hàm chỉ dùng quan hệ thành viên, không dùng nhãn hay điểm dự đoán.
def connected_blocks(rows):
    if not rows or any(len(r) != 3 or
            any(not isinstance(x, str) or not x for x in r) for r in rows):
        raise ValueError("expected nonempty recording/speaker/device IDs")
    if len({r[0] for r in rows}) != len(rows):
        raise ValueError("recording IDs must be unique")
    parent = list(range(len(rows)))
    def root(i):
        while parent[i] != i:
            parent[i] = parent[parent[i]]
            i = parent[i]
        return i
    owner = {}
    for i, (_, speaker, device) in enumerate(rows):
        for key in (("speaker", speaker), ("device", device)):
            if key in owner:
                parent[root(i)] = root(owner[key])
            else:
                owner[key] = i
    blocks = {}
    for i, (recording, _, _) in enumerate(rows):
        blocks.setdefault(root(i), []).append(recording)
    return sorted(tuple(sorted(ids)) for ids in blocks.values())

memberships = [("r1", "A", "X"), ("r2", "A", "Y"),
               ("r3", "B", "Y"), ("r4", "C", "Z"),
               ("r5", "D", "Z"), ("r6", "D", "W")]
print(connected_blocks(memberships))
print(connected_blocks(memberships + [("r7", "B", "Z")]))
Kết quả đầu là [('r1', 'r2', 'r3'), ('r4', 'r5', 'r6')]. Thêm r7 B/Z nối hai khối, nên kết quả thứ hai chỉ còn một bộ chứa r1 đến r7. Không có cách chia toàn bộ bảy hàng thành tập huấn luyện và tập kiểm tra đều không rỗng mà vẫn thỏa mãn cả hai yêu cầu tách biệt.
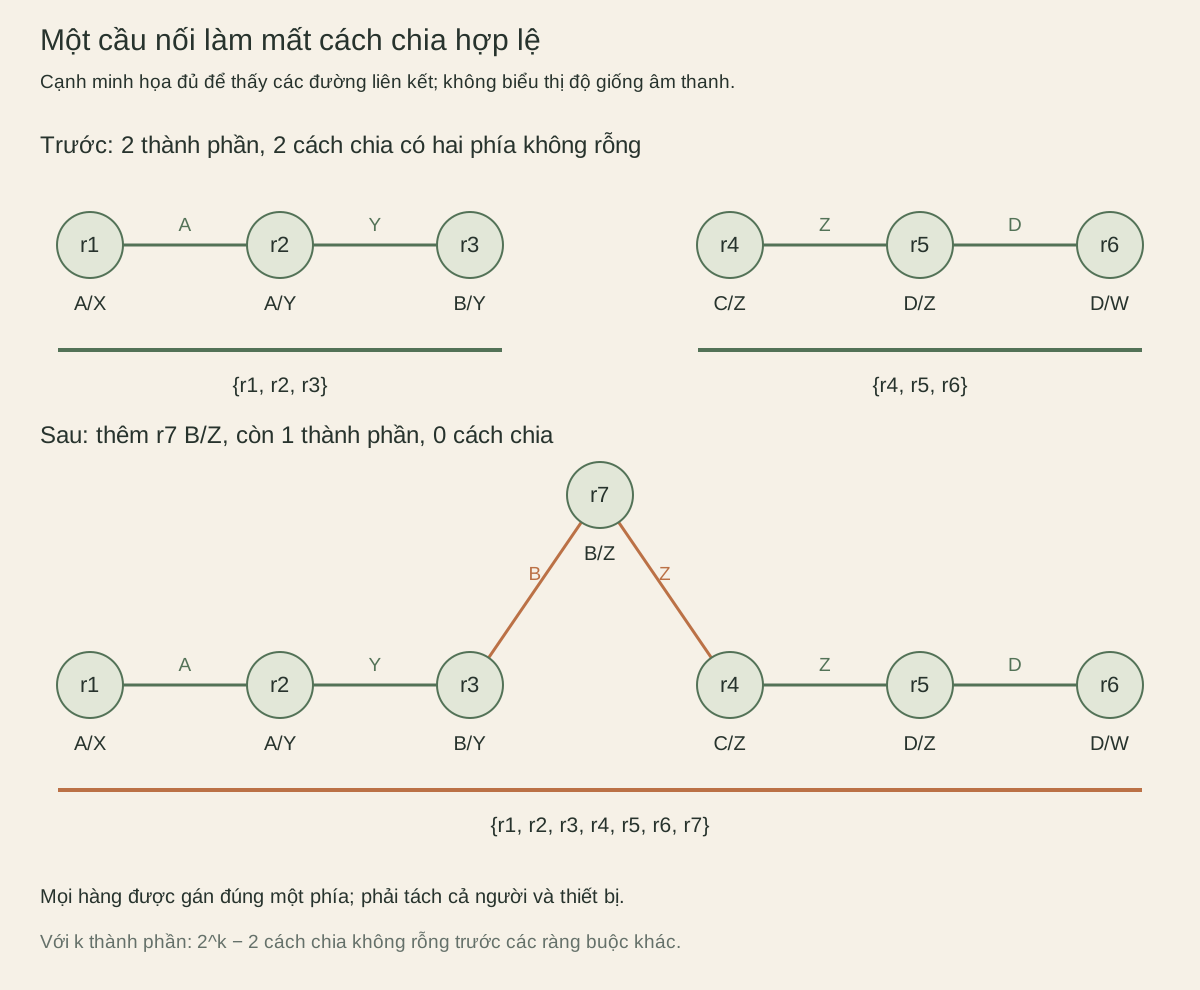
Mỗi cạnh ghi danh tính buộc hai bản ghi phải đi cùng nhau. Cầu nối làm mất một cách chia khả thi dù nó bổ sung thêm dữ liệu. Không cạnh nào biểu thị độ giống nhau suy ra từ âm thanh.
Lập luận là chính xác: mỗi cạnh nối hai bản ghi có chung danh tính buộc chúng cùng phía, nên cả đường đi cũng vậy. Ngược lại, gán nguyên từng thành phần liên thông về một phía sẽ giữ được cả hai yêu cầu tách biệt. Với k thành phần và mỗi hàng được gán đúng một trong hai phía có tên khác nhau, có 2^k−2 cách gán để cả hai phía đều không rỗng. Hai thành phần cho hai cách; một thành phần không cho cách nào. Thêm điều kiện về lớp, kích thước hoặc thời gian có thể làm số cách giảm tiếp.
Đây là kết quả về tính khả thi của cấu trúc. Các thành phần rời nhau vẫn có thể chia sẻ điều kiện chưa được ghi nhận; giữ lại một thiết bị không khiến nó đại diện cho mọi thiết bị tương lai. Nếu toàn bộ đồ thị liên thông, cần thu thập dữ liệu phục vụ phép kiểm tra dự định, thu hẹp kết luận hoặc xác định và công khai chính sách loại dữ liệu. Bỏ một cầu nối gây bất tiện sau khi xem điểm của nó sẽ tạo thêm quyết định lựa chọn dựa trên kết quả.
Giữ ranh giới trong cả lựa chọn mô hình và báo cáo
GroupKFold đưa mỗi nhóm được cung cấp vào đúng một tập kiểm tra và đòi hỏi số nhóm khác nhau ít nhất bằng số fold. Nếu đơn vị phù hợp là thành phần liên thông, hãy cung cấp mã thành phần thay vì bộ đôi người/thiết bị. Kích thước thành phần quá chênh lệch có thể khiến việc tạo các fold hữu ích trở nên bất khả thi dù đã đủ số nhóm.
GroupShuffleSplit tính kích thước tập kiểm tra theo số nhóm, không theo số hàng; các tập kiểm tra ở những lần chia khác nhau có thể giao nhau. Giữ lại một nửa của hai nhóm có 2 và 100 hàng vì thế có thể giữ lại 2 hoặc 100 hàng. Các điểm đánh giá lặp lại không tự động trở thành những phép đo độc lập trên các quần thể mới.
Giữ cùng ranh giới triển khai ở vòng lựa chọn mô hình bên trong và vòng đánh giá bên ngoài, đồng thời chỉ khớp phép tiền xử lý trên phần huấn luyện tương ứng. Bài giải thích năm 2018 của Raschka về kiểm định chéo lồng nhau tách rõ hai công việc này; cách nhóm dữ liệu xác định mỗi công việc được tiếp cận quan sát nào. Cần ghi rõ hàm mất mát cho mỗi người trọng số ngang nhau hay cho trọng số theo số bản ghi. Lấy mẫu lại từng bản ghi không tái tạo được biến thiên giữa những người mới độc lập.
Để thực hành có thể tái lập, hãy liệt kê 16 cách gán nhãn và tính lại kỳ vọng sai số tra cứu. Sau đó liệt kê toàn bộ 64 cách gán sáu hàng quan hệ vào huấn luyện hoặc kiểm tra, chỉ giữ cách có hai phía không rỗng và không giao nhau cả về người lẫn thiết bị: còn đúng hai cách. Thêm cầu nối rồi kiểm tra 128 cách gán: không cách nào đạt. Cuối cùng, cho một mã người trùng cách viết với mã thiết bị mà không tạo liên kết dùng chung nào trong từng miền riêng. Hai danh tính đó phải tiếp tục tách biệt. Những phép kiểm tra này xác nhận ranh giới đã khai báo; khả năng áp dụng ra ngoài dữ liệu vẫn phụ thuộc vào cách thu thập người tham gia và bản ghi.