Likelihood là hàm của tham số
Suy ra likelihood Bernoulli, so sánh cỡ mẫu và sự phụ thuộc theo chuỗi, rồi kiểm tra vì sao cùng số thành công chưa chắc cho cùng xác suất chuỗi.
Likelihood, thường gọi là hàm hợp lý, giữ các quan sát cố định và so sánh những giá trị tham số khác nhau giải thích chúng tốt đến đâu. Khi dùng mô hình xác suất theo chiều còn lại, ta giữ tham số đã cho và mô tả các quan sát có thể xuất hiện. Công thức số có thể giống nhau, nhưng ý nghĩa thay đổi theo đại lượng nào được phép biến thiên.
Nếu đang huấn luyện một bộ phân loại, bạn cần sự phân biệt này để hiểu vì sao cực đại hóa likelihood là một quy tắc khớp mô hình, và vì sao đường likelihood không tự trở thành phân phối xác suất trên trọng số. Ví dụ Bernoulli với mười phép thử làm rõ điều đó mà không cần bộ dữ liệu lớn.
Giữ nguyên dữ liệu quan sát
Giả sử mười phép thử nhị phân độc lập cho bảy thành công và ba thất bại. Mọi phép thử được giả định có cùng xác suất thành công chưa biết p. Nếu dữ liệu là đúng chuỗi đã quan sát, xác suất của chuỗi khi cho trước p là:
P(observed sequence | p) = p^7 × (1 - p)^3Với p = 0.5, giá trị là 0.5^10, khoảng 0,0009766. Với p = 0.7, nó khoảng 0,0022236. Với p = 0.9, nó khoảng 0,0004783. Chuỗi đã quan sát có xác suất cao hơn dưới tham số 0,7 so với hai lựa chọn còn lại.
Khi các quan sát được giữ cố định còn p thay đổi, ta gọi biểu thức ấy là likelihood L(p). Mỗi điểm trên đường biểu diễn đánh giá cùng dữ liệu với một tham số ứng viên khác. Độ cao của đường không có nghĩa rằng xác suất p bằng 0,7 là 0,22%.
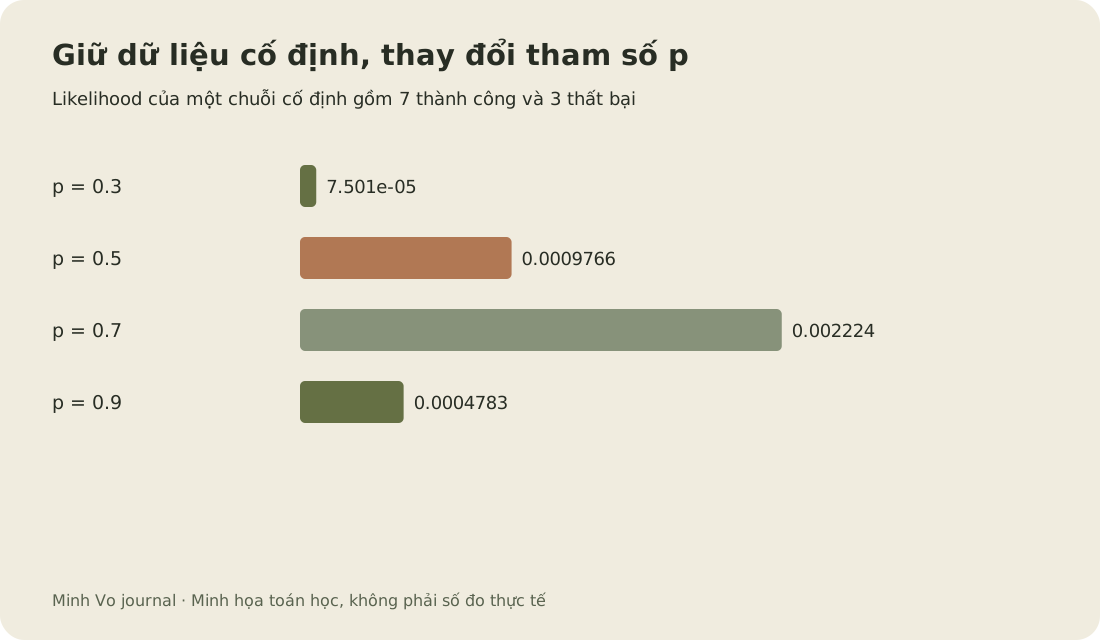
Likelihood nhỏ là điều bình thường khi dữ liệu gồm một chuỗi cụ thể. Có rất nhiều chuỗi có thể xảy ra và từng chuỗi đều có thể có xác suất nhỏ. Điều quan trọng với ước lượng hợp lý cực đại là likelihood thay đổi thế nào giữa các giá trị tham số trên cùng quan sát.
Có thể so sánh trực tiếp những ứng viên cho chuỗi cố định này:
| Xác suất thành công ứng viên | Likelihood của chuỗi | So với p = 0,5 |
|---|---|---|
| 0,5 | 0,0009765625 | 1,000 |
| 0,7 | 0,0022235661 | 2,277 |
| 0,9 | 0,0004782969 | 0,490 |
Chỉ quan sát số thành công làm đổi một hằng số
Nếu dữ liệu chỉ là tổng số thành công, xác suất nhị thức có thêm số chuỗi đạt tổng ấy:
P(K = 7 | p) = choose(10, 7) × p^7 × (1 - p)^3
            = 120 × p^7 × (1 - p)^3
Hằng số 120 nhân likelihood tại mọi ứng viên p. Nó làm đổi xác suất số học của sự kiện quan sát, nhưng không đổi tham số đạt cực đại. Tỷ số likelihood giữa hai tham số cũng không thay đổi.
Phải phân biệt chuỗi với số đếm khi báo cáo một xác suất thực sự. Trong mã tối ưu, sự khác biệt thường biến mất vì có thể bỏ hằng số không phụ thuộc tham số. Hàm mất mát đã bỏ hằng số vẫn có thể chọn cùng mô hình, nhưng giá trị của nó không còn bằng đầy đủ âm log xác suất của sự kiện được mô tả.
Tìm cực đại bằng đạo hàm
Tích của nhiều xác suất có thể nhỏ đến mức gây hụt số trong tính toán dấu phẩy động. Lấy log biến tích thành tổng và giữ nguyên thứ tự vì hàm log tăng. Bỏ hằng số nhị thức, log likelihood là:
ell(p) = 7 log(p) + 3 log(1 - p)
ell'(p) = 7 / p - 3 / (1 - p)
Cho đạo hàm bằng không được 7(1 - p) = 3p, suy ra p = 0.7. Đạo hàm bậc hai là -7 / p² - 3 / (1 - p)², luôn âm trong khoảng (0, 1). Điểm dừng này vì thế là cực đại duy nhất trong khoảng. Kết quả tổng quát là tỷ lệ thành công quan sát k / n.
Nếu mẫu toàn thành công hoặc toàn thất bại, cực đại nằm ở biên. Ước lượng có thể cho xác suất đúng bằng một hoặc không, dẫn đến log loss vô hạn nếu quan sát tiếp theo trái với ước lượng. Phân phối tiên nghiệm hoặc quy tắc chính quy hóa có thể làm mềm biên, nhưng chúng thay đổi thủ tục ước lượng và cần được nêu rõ.
Tỷ số likelihood cũng có cách diễn giải cụ thể. Ở đây, L(0.7) / L(0.5) khoảng 2,277. Xác suất của chuỗi quan sát dưới ứng viên thứ nhất gấp khoảng 2,277 lần ứng viên thứ hai. Đó là bằng chứng so sánh hai ứng viên đã chỉ định; nó không cung cấp odds tiên nghiệm của chúng và không tự điều chỉnh cho việc chọn ứng viên sau khi xem dữ liệu.
Cùng ước lượng nhưng hình dạng likelihood khác nhau
So sánh bảy thành công trong mười phép thử ban đầu với một mẫu giả lập thứ hai gồm bảy mươi thành công trong một trăm phép thử. Cả hai có ước lượng hợp lý cực đại bằng 0,7. Tuy nhiên, chúng không cung cấp cùng mức bằng chứng khi so với mọi tham số thay thế.
Để đặt hai hình dạng trên cùng biểu đồ, chia likelihood của mỗi mẫu cho cực đại của chính nó. Likelihood tương đối có chiều cao một tại 0,7 trong cả hai trường hợp. Với mẫu mười phép thử, giá trị tương đối tại 0,5 khoảng 0,4392. Với mẫu một trăm phép thử, nó bằng số đó mũ mười, khoảng 0,000267. Theo cùng mô hình độc lập với xác suất không đổi, mẫu thứ hai phân biệt 0,5 với 0,7 rõ hơn.
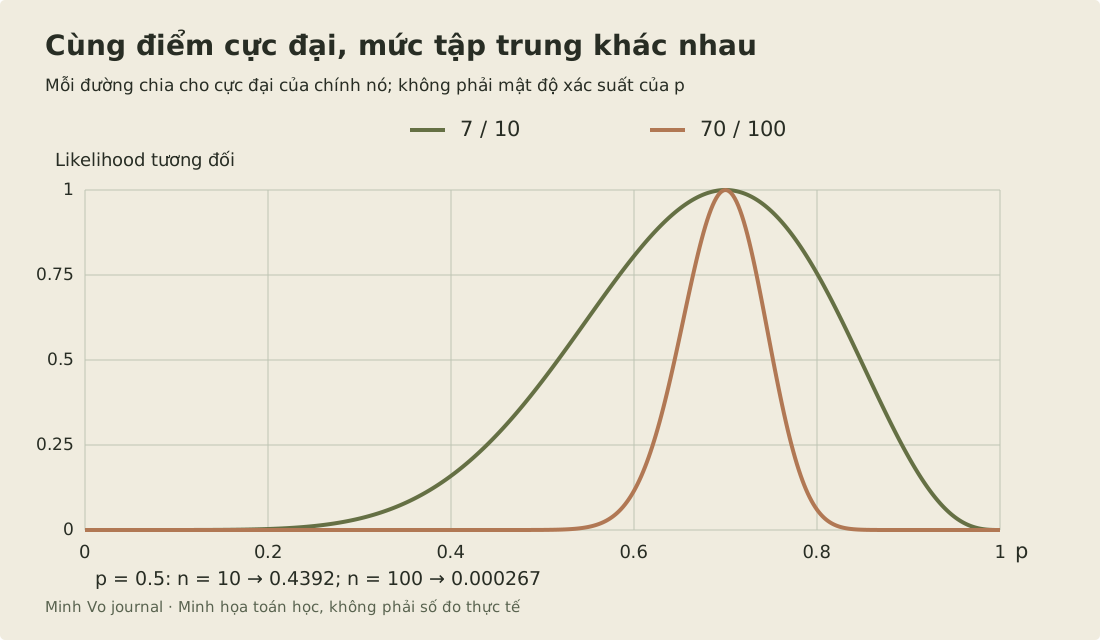
Đưa chiều cao cực đại về một không biến đường biểu diễn thành mật độ xác suất. Diện tích chưa được chuẩn hóa và trục ngang vẫn chỉ một tham số ứng viên. Hai đường mô tả mức khớp tương đối với hai bộ dữ liệu khác nhau. Không nên so trực tiếp độ cao likelihood chưa chuẩn hóa để kết luận bộ dữ liệu nào tốt hơn: nhân thêm nhiều xác suất thường làm xác suất của một chuỗi nhỏ đi.
So sánh này còn giả định những quan sát thêm vào là các phép thử mới có thông tin. Sao chép mỗi dòng trong mười dòng ban đầu thành mười bản sẽ tạo cùng biểu thức tích nếu chương trình mặc nhiên coi mọi dòng độc lập. Nhưng thao tác ấy không tạo ra một trăm quan sát độc lập. Đường tập trung mạnh khi đó phản ánh một mô hình lấy mẫu sai, giống việc ước lượng độ bất định mà coi bản ghi lặp là bằng chứng mới.
Vì vậy, ước lượng điểm không đổi chưa đủ kết luận một đánh giá đã tiến bộ hay chưa. Cần xem quá trình lấy mẫu và toàn bộ hình dạng likelihood. Nếu cần khoảng tin cậy hoặc xác suất hậu nghiệm, hãy dùng một phương pháp suy luận riêng. Riêng biểu đồ likelihood tương đối không cung cấp đối tượng nào trong hai loại đó.
Có thể bỏ thứ tự hay không phụ thuộc vào mô hình
Rút dữ liệu xuống số thành công là hợp lệ ở trên vì các phép thử được giả định độc lập và có chung xác suất thành công. Mọi thứ tự gồm bảy thành công khi đó có cùng xác suất. Mô hình có phụ thuộc nối tiếp có thể phân biệt các thứ tự ấy, nên một số đếm có thể bỏ mất thông tin cần để đánh giá mô hình.
Xét hai chuỗi cố định SSSSSSSFFF và SFSFSFSSSS. Mỗi chuỗi chứa bảy thành công và ba thất bại. Trong mô hình Bernoulli ban đầu tại tham số 0,7, cả hai có xác suất khoảng 0,0022236.
Bây giờ định nghĩa một mô hình chuỗi giả lập khác. Ký hiệu đầu tiên là S hoặc F với xác suất bằng nhau. Mỗi ký hiệu sau lặp ký hiệu ngay trước với xác suất 0,9 và đổi sang ký hiệu còn lại với xác suất 0,1. Các quy tắc này xác định xác suất có điều kiện của ký hiệu tiếp theo; chúng không phải mô hình đã được ước lượng từ luồng sự kiện thực tế.
Chuỗi thứ nhất có tám chuyển tiếp giữ nguyên ký hiệu và một lần đổi. Xác suất của nó là 0.5 × 0.9^8 × 0.1, khoảng 0,0215234. Chuỗi thứ hai có ba lần giữ nguyên và sáu lần đổi. Xác suất là 0.5 × 0.9^3 × 0.1^6, tức 0,0000003645. Cùng số thành công không còn đồng nghĩa với cùng xác suất chuỗi.
Quy tắc nhân xác suất vẫn đúng: nhân xác suất ký hiệu đầu với xác suất có điều kiện của từng ký hiệu tiếp theo khi biết lịch sử liên quan. Điều không còn đúng là cách rút gọn dựa trên các phép thử độc lập. Với luồng sự kiện lặp, hãy giữ thứ tự và thông tin nhóm cho đến khi giả định mô hình cho phép bỏ chúng. Bộ xử lý chỉ giữ một số thành công cho mỗi phiên có thể khiến bạn không còn đủ dữ liệu để khớp một số mô hình phụ thuộc về sau.
Bài giảng ước lượng hợp lý cực đại của Marco Taboga định nghĩa likelihood qua phân phối đồng thời của mẫu quan sát. Định nghĩa ấy bao phủ cả hai ví dụ. Tích các thành phần Bernoulli cùng tham số chỉ là một mô hình đồng thời cụ thể, không phải định nghĩa của likelihood.
Tự tái lập phép so sánh mà không cần thư viện huấn luyện
Viết một phép tính ngắn đếm thành công và thất bại trong mỗi chuỗi cố định. Tính tích Bernoulli tại 0,5, 0,7 và 0,9 rồi so sánh hai chuỗi. Likelihood phải giống nhau ở từng ứng viên vì số đếm giống nhau. Tiếp theo, đếm các cặp ký hiệu liền nhau giống và khác nhau, rồi tính theo mô hình có điều kiện ở trên. Xác suất hai chuỗi lúc này phải khác nhau.
Để tạo biểu đồ theo cỡ mẫu, tính log likelihood trừ log likelihood tại cực đại, rồi lấy hàm mũ của hiệu. Cách này tránh chia trực tiếp hai tích rất nhỏ. Kiểm tra mỗi đường đạt một tại 0,7 và giá trị tương đối của mẫu một trăm tại 0,5 bằng giá trị của mẫu mười mũ mười. Từ chối tham số nằm ngoài khoảng từ không đến một. Ở biên, xử lý quan sát sao cho không phải tính một số đếm bằng không nhân log của không.
Bài tập kiểm tra dữ liệu nào được dùng, quan sát nào bị giả định độc lập và hằng số nào có thể bỏ. Nó không chứng minh mô hình Bernoulli hay mô hình chuỗi phù hợp với một ứng dụng. Điều đó cần bằng chứng về quá trình sinh dữ liệu và đánh giá dự đoán trên những chuỗi được giữ riêng theo thiết kế thích hợp.
Muốn xác suất trên tham số cần thêm một thành phần
Suy luận Bayes kết hợp likelihood với phân phối tiên nghiệm trên tham số. Hậu nghiệm tỷ lệ với L(p) × prior(p), rồi được chuẩn hóa trên các giá trị tham số. Tiên nghiệm và cách biểu diễn tham số là một phần của phép xây dựng này. Chỉ vẽ đường likelihood không cung cấp chúng.
Có một trường hợp cần hiểu kỹ: trên không gian tham số một chiều bị chặn, một likelihood thích hợp có thể được chuẩn hóa thành mật độ theo một độ đo đã chọn. Việc ấy tương ứng với một lựa chọn tiên nghiệm cụ thể, chẳng hạn mật độ đều trong tọa độ đó. Mật độ đều theo p không đều theo log odds của p. Vì vậy, “chuẩn hóa likelihood” không thay thế việc chỉ định tiên nghiệm theo cách độc lập với hệ tọa độ.
Chương xác suất của Deep Learning cung cấp các quy tắc xác suất cho mô hình, còn chương nền tảng học máy phát triển ước lượng hợp lý cực đại. Khi đọc hàm mất mát của một mô hình, hãy xác định các quan sát, tham số và hằng số đã bị bỏ. Ba chi tiết ấy giải thích chính xác điều bộ tối ưu đang cực đại hóa.