Phân tích bản ghi CSV chứa ký tự xuống dòng
Phân biệt dòng vật lý với bản ghi CSV, kiểm tra dấu nháy và lược đồ, rồi chẩn đoán phần tệp lỗi bằng các ví dụ Python tái lập được.
Một bản ghi CSV có thể chứa ký tự xuống dòng bên trong trường được đặt trong dấu nháy. Vì vậy, đếm dòng vật lý hay tách theo dấu xuống dòng không đếm bản ghi đáng tin cậy. Hãy dùng bộ phân tích CSV hiểu quy tắc dấu nháy, rồi kiểm tra số lượng và ý nghĩa trường trong từng bản ghi đã tách.
Nếu bạn nhập địa chỉ, bình luận hoặc mô tả, đây là dạng đầu vào bình thường. Địa chỉ bưu điện hai dòng vẫn là một trường thuộc một bản ghi khách hàng. Coi dòng thứ hai của địa chỉ là bản ghi mới sẽ làm lệch cột và có thể tạo lỗi khó hiểu ở xa ranh giới ban đầu.
Đọc hai địa chỉ từ bốn dòng vật lý
Tệp giả lập này có tiêu đề và hai bản ghi địa chỉ. Địa chỉ đầu chứa một dấu xuống dòng. Địa chỉ thứ hai chứa cả dấu phẩy lẫn dấu nháy.
import csv
import io

payload = (
    'id,address\r\n'
    '1,"12 River Road\r\nUnit 3"\r\n'
    '2,"5 Hill St, ""East"""\r\n'
)

rows = list(csv.reader(io.StringIO(payload, newline=""), strict=True))
assert rows == [
    ["id", "address"],
    ["1", "12 River Road\r\nUnit 3"],
    ["2", '5 Hill St, "East"'],
]
print("physical lines:", len(payload.splitlines()))
print("data records:", len(rows) - 1)
Kết quả là bốn dòng vật lý và hai bản ghi dữ liệu. Bộ phân tích giữ dấu xuống dòng của địa chỉ trong giá trị trường đầu. Nó đổi các cặp dấu nháy kép trong địa chỉ thứ hai thành dấu nháy có trong nội dung.
RFC 4180 mô tả việc đặt dấu nháy quanh trường chứa dấu phẩy, xuống dòng hoặc dấu nháy kép, đồng thời dùng thêm một dấu nháy để biểu diễn dấu nháy bên trong. CSV thực tế có thể dùng các biến thể khác, nên cần xác nhận dấu phân cách và quy ước trích dẫn của bên tạo tệp thay vì cho rằng mọi tệp đều theo một dạng.
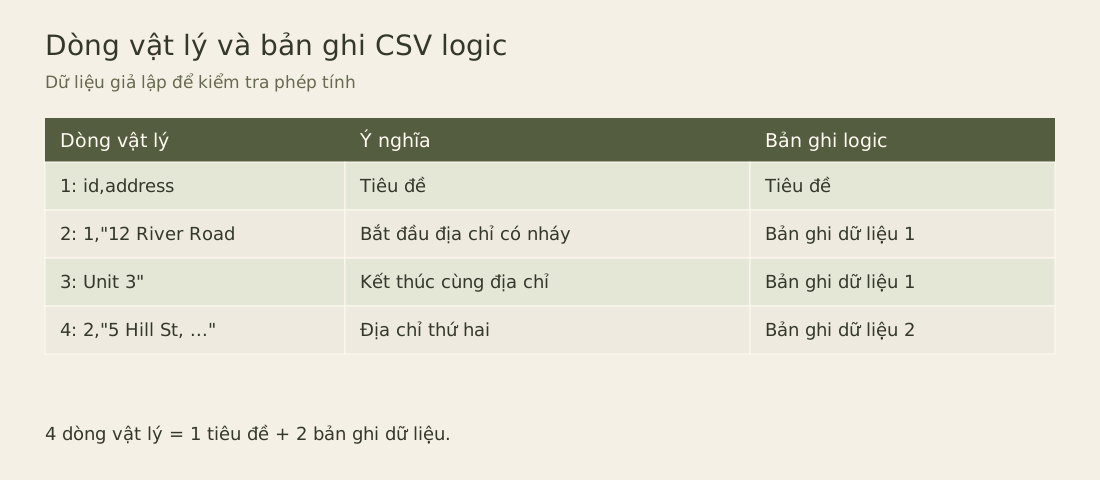
Dấu nháy mở trước địa chỉ đầu là lý do dấu xuống dòng của nó không kết thúc bản ghi. Bộ phân tích phải giữ trạng thái xuyên qua ranh giới dòng đó.
Giữ cách xử lý xuống dòng đúng ở ranh giới tệp
Với tệp thật trong Python, mở bằng mã hóa mong muốn và newline="", rồi truyền đối tượng tệp cho bộ đọc CSV. Cách này để mô-đun CSV tự xử lý quy ước xuống dòng. Đối tượng StringIO ở trên dùng cùng thiết lập để ví dụ giữ nguyên cặp ký tự carriage return và line feed bên trong trường.
Tài liệu CSV của Python ghi rõ quy ước mở tệp đó. Dấu phân cách, ký tự nháy và cách thoát ký tự là thiết lập của bộ phân tích cần lưu cùng cấu hình nhập. Đoán biến thể từ mẫu ngắn có thể hữu ích khi khám phá, nhưng phải xác nhận trước khi tự động xử lý nguồn định kỳ.
Giải mã byte thành văn bản là bước riêng. Tệp UTF-8 có dấu đánh dấu thứ tự byte có thể cần cách giải mã phù hợp để tiêu đề đầu không nhận ký tự vô hình. Tệp dùng bảng mã cũ cần được xác định bảng mã; bộ phân tích CSV không khôi phục được văn bản đã bị giải mã sai trước khi tới nó.
Giữ byte gốc hoặc bản chụp nguồn được phép lưu khi khả năng tái lập quá trình nhập là quan trọng. Trình soạn thảo có thể chuẩn hóa ký tự kết thúc dòng khi lưu, làm đổi biểu diễn byte dù địa chỉ nhìn không đổi. Giá trị băm tệp thô định danh đầu vào thực, còn định danh bản ghi đã tách mô tả nội dung logic.
Kiểm tra lược đồ sau khi phân tích
Phân tích thành công không bảo đảm bảng hợp lệ. Bản ghi có thể thừa hoặc thiếu trường, tiêu đề ngoài dự kiến hay tên cột trùng. Kiểm tra các tính chất ấy trước khi ánh xạ giá trị vào lược đồ đích.
header, *data_rows = rows
if header != ["id", "address"]:
    raise ValueError("unexpected header")
for record_number, row in enumerate(data_rows, 1):
    if len(row) != len(header):
        raise ValueError(f"record {record_number}: wrong field count")
Ở đây, số bản ghi trong thông báo đếm bản ghi dữ liệu và không tính tiêu đề. Nó chủ ý khác số dòng vật lý. Với tệp có trường nhiều dòng, thông báo lỗi cần nói rõ đang dùng loại số nào. Nếu chỉ ghi “dòng ba”, người sửa phải đoán đó là bản ghi thứ ba trong bảng tính hay dòng văn bản thứ ba.
Chế độ phân tích nghiêm ngặt giúp nhận ra dấu nháy sai, nhưng vẫn cần kiểm tra lược đồ và nghiệp vụ. Trường địa chỉ rỗng có thể đúng cú pháp nhưng vi phạm quy tắc địa chỉ bắt buộc. Giữ các lỗi này riêng để người vận hành biết cần sửa định dạng tệp hay giá trị nguồn.
Ghi rồi đọc lại bằng cùng quy tắc CSV
Dùng bộ ghi CSV khi xuất các bản ghi đã phân tích. Nó có thể đặt nháy ở trường cần thiết và thoát dấu nháy bên trong một cách nhất quán. Tự bọc mọi giá trị trong dấu nháy sẽ thất bại khi giá trị đã chứa dấu nháy nếu không áp dụng quy tắc thoát tương ứng.
Một phép thử hữu ích là ghi các dòng đã tách vào luồng CSV trong bộ nhớ rồi phân tích đầu ra lần nữa. So sánh giá trị trường sau lượt đi về. Không yêu cầu byte giống hệt trừ khi ứng dụng cam kết một cách tuần tự hóa chuẩn duy nhất, vì nhiều cách đặt dấu nháy hợp lệ có thể mô tả cùng giá trị.
Hành vi bảng tính là một ranh giới khác. Trường văn bản đúng cú pháp có thể bị ứng dụng bảng tính hiểu thành công thức khi mở. Nếu xuất để dùng trong bảng tính, áp dụng cách xử lý đã được sản phẩm quy định cho giá trị không đáng tin cậy trông giống công thức. Dấu nháy CSV kiểm soát ranh giới trường; nó không chỉ dẫn bảng tính coi mọi trường là văn bản thuần.
Chỉ chia đầu vào lớn ở ranh giới bản ghi hợp lệ
Nhập song song không thể an toàn cắt một khoảng byte tùy ý tại dấu xuống dòng kế tiếp khi trường có dấu nháy có thể kéo dài nhiều dòng. Worker bắt đầu giữa một địa chỉ được trích dẫn không biết trạng thái dấu nháy đã hình thành trước đó. Dùng bộ chia hiểu CSV, định dạng có khối đọc độc lập hoặc hệ thống nhập mà bộ đọc CSV xử lý được ranh giới bản ghi qua các phân vùng.
Để kiểm tra lần đầu, giữ ví dụ hai địa chỉ và thêm trường rỗng có dấu nháy, dấu nháy được thoát và dấu nháy đóng sai. Những trường hợp này kiểm tra trực tiếp quy tắc định dạng. Tệp chỉ có tên ngắn không đặt nháy có thể khiến bộ tách theo dòng trông đáng tin cậy cho đến khi địa chỉ thật đầu tiên chứa dấu xuống dòng xuất hiện.
Báo cả bản ghi logic lẫn dòng vật lý đã đọc
Python cung cấp số dòng vật lý mà bộ đọc đã tiêu thụ qua line_num. Nó không phải số bản ghi được trả về. Bộ nhập phục vụ chẩn đoán có thể giữ cả hai tọa độ, đồng thời tách lỗi cú pháp khỏi lỗi lược đồ ở cấp bản ghi. Ví dụ thứ hai sau đây chủ ý gồm địa chỉ nhiều dòng, một dòng thừa trường, địa chỉ rỗng và dấu nháy chưa đóng.
broken_payload = (
    'id,address\r\n'
    '1,"12 River Road\r\nUnit 3"\r\n'
    '2,5 Hill St,East\r\n'
    '3,\r\n'
    '4,"unfinished\r\n'
)

def inspect_addresses(text):
    reader = csv.reader(io.StringIO(text, newline=""), strict=True)
    if next(reader, None) != ["id", "address"]:
        raise ValueError("unexpected header")
    outcomes = []
    record_number = 0
    while True:
        starts_on = reader.line_num + 1
        try:
            row = next(reader)
        except StopIteration:
            return outcomes, None
        except csv.Error as error:
            return outcomes, {
                "candidate_record": record_number + 1,
                "starts_on": starts_on,
                "ends_on": reader.line_num,
                "error": str(error),
            }
        record_number += 1
        if len(row) != 2:
            state = "wrong-field-count"
        elif not row[1]:
            state = "missing-address"
        else:
            state = "accepted"
        outcomes.append({
            "record": record_number, "starts_on": starts_on,
            "ends_on": reader.line_num, "state": state, "fields": row,
        })

outcomes, syntax_error = inspect_addresses(broken_payload)
for result in outcomes:
    print(result["record"], result["starts_on"],
          result["ends_on"], result["state"])
print(syntax_error)
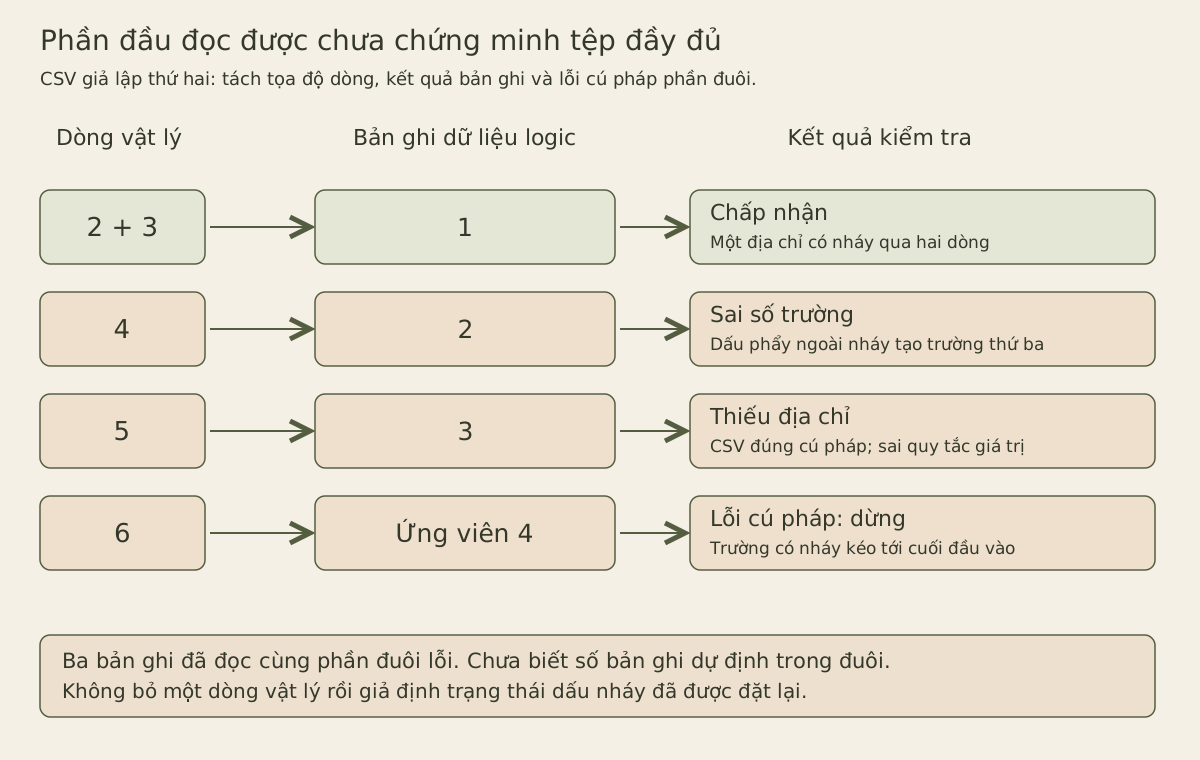
Bản ghi logic đầu được chấp nhận và trải qua dòng vật lý hai và ba. Bản ghi thứ hai ở dòng bốn, thất bại khi kiểm tra số trường. Bản ghi thứ ba ở dòng năm và thiếu địa chỉ. Ứng viên bản ghi thứ tư bắt đầu tại dòng sáu, nhưng bộ phân tích tới cuối tệp khi vẫn ở bên trong trường có dấu nháy. Trong môi trường Python đã kiểm tra, thông báo là unexpected end of data; thông tin chẩn đoán ghi ứng viên bản ghi bốn, từ dòng sáu đến dòng sáu.
Tài liệu bộ đọc CSV định nghĩa bộ đếm dòng đã đọc. Giữ khác biệt đó trong thông báo cho người vận hành: “ứng viên bản ghi dữ liệu 4, bắt đầu tại dòng vật lý 6” hữu ích hơn “dòng 4” không giải thích. Câu chữ chính xác của ngoại lệ là thông tin chẩn đoán của cách triển khai, nên tích hợp cần mã lỗi nội bộ ổn định thay vì đòi câu tiếng Anh đó giữ nguyên qua mọi phiên bản.
Hàm hỗ trợ giả định có một tiêu đề, không có dòng vật lý trống giữa các bản ghi và lược đồ cố định hai cột. Quy tắc địa chỉ chỉ kiểm tra trường có rỗng hay không. Nó không xác thực khả năng phát thư, tính duy nhất của mã hay việc địa chỉ chỉ chứa khoảng trắng có chấp nhận được không. Giá trị rỗng đặt trong dấu nháy vẫn là CSV đúng cú pháp nhưng thất bại theo quy tắc nghiệp vụ đã chọn. Nêu các giới hạn này giúp tránh nhầm phân tích thành công với xác thực hoàn chỉnh dữ liệu khách hàng.
Lỗi cú pháp còn đòi hỏi quyết định ở cấp lô
Ba kết quả được trả về chỉ mô tả phần đầu đã phân tích. Chúng không chứng minh phần nguồn còn lại không có bản ghi nào. Sau dấu nháy chưa khớp, dấu xuống dòng phía sau vẫn có thể thuộc cùng trường; bỏ qua một dòng vật lý không phải cách đáng tin cậy để tìm bản ghi logic tiếp theo. Dừng lần nhập này, giữ định danh nguồn và yêu cầu tệp sửa, trừ khi bên tạo tệp cung cấp một cơ chế đóng khung độc lập đáng tin cậy.
Với bản xem trước, hiển thị phần đã chấp nhận kèm trạng thái tệp chưa hoàn chỉnh rõ ràng có thể giúp tìm lỗi. Lô phân tích định kỳ có thể yêu cầu chỉ công bố khi toàn bộ lô đạt. Dù chọn cách nào, giữ lỗi cú pháp ngoài số đếm từ chối bản ghi thông thường: một phần đuôi không phân tích được có thể che giấu số bản ghi dự định chưa biết. Báo “ba bị từ chối trên bốn” sẽ khẳng định quá mức về tập bản ghi logic của tệp.
Thử ba thay đổi độc lập trên ví dụ thứ hai. Đóng trường có dấu nháy cuối bằng cách nối thêm một dấu nháy rồi CRLF. Bộ phân tích lúc này trả bốn kết quả và không còn lỗi cú pháp; địa chỉ cuối chứa cả CRLF bên trong. Tiếp theo, khôi phục ví dụ gốc và đặt dấu nháy quanh địa chỉ có dấu phẩy ở dòng bốn. Bản ghi hai trở thành hợp lệ, nhưng trường cuối chưa đóng vẫn ngăn lần nhập hoàn chỉnh. Cuối cùng, ghi rows hợp lệ ban đầu bằng csv.writer vào luồng mở với newline="", rồi đọc lại. Các trường đã phân tích phải khớp chính xác dù bộ ghi có thể chọn cách đặt dấu nháy hợp lệ khác cho trường đơn giản hơn. Các bài tập kiểm tra riêng đóng khung, hình dạng trường và bảo toàn giá trị qua lượt ghi đọc.