Hiểu cardinality qua mã hóa từ điển Parquet
So mã quốc gia lặp với mã yêu cầu duy nhất trong tệp Parquet thật; kiểm tra số byte, dictionary page và ý nghĩa cục bộ của chỉ số.
Cột chỉ có ba mã quốc gia và cột chứa hàng nghìn mã yêu cầu duy nhất có thể hưởng lợi rất khác nhau từ mã hóa từ điển. Quyết định liên quan đến giá trị lặp trong một column chunk cụ thể. Không thể kết luận chỉ từ số hàng của bảng, hoặc bật một tùy chọn cho cả tệp rồi cho rằng cột nào cũng nhỏ hơn.
Bài này dành cho người đọc đã biết cột và row group trong Parquet. Chúng ta sẽ tự giải mã một từ điển nhỏ, ghi ba biến thể Parquet thật và so dung lượng lưu trữ trong khi kiểm tra mọi giá trị đọc lại. Ví dụ dùng Python 3.12.3, PyArrow 23.0.1 và dữ liệu giả lập. Các phép đo chỉ xác định độ dài tệp và column chunk, không đo độ trễ truy vấn hay bộ nhớ tiến trình.
Bắt đầu từ giá trị, vị trí và từ điển cục bộ
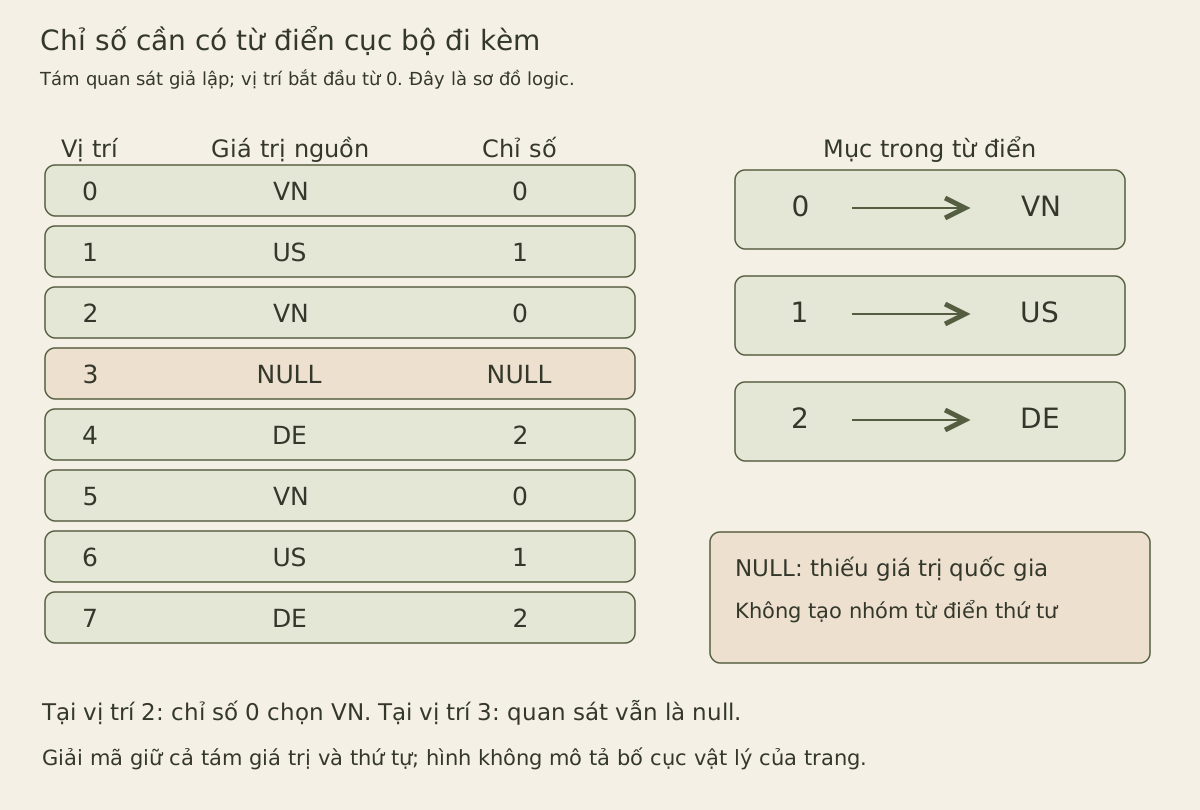
Dictionary array của Arrow chứa các giá trị từ điển và chỉ số dùng để chọn chúng. Tám quan sát dưới đây có ba nhãn quốc gia khác nhau không phải null. Quan sát null vẫn là null; nó không biến thành quốc gia thứ tư hoặc chuỗi "NULL".
import pyarrow as pa
import pyarrow.parquet as pq

values = pa.array(['VN', 'US', 'VN', None, 'DE', 'VN', 'US', 'DE'])
encoded = values.dictionary_encode()
print(encoded.dictionary.to_pylist())
print(encoded.indices.to_pylist())
assert encoded.dictionary_decode().equals(values)
Từ điển được in là ['VN', 'US', 'DE'], còn các chỉ số là [0, 1, 0, None, 2, 0, 1, 2]. Đánh số vị trí từ 0, tại vị trí hai, chỉ số 0 trỏ về VN. Ở vị trí ba, quan sát bị thiếu. Phép kiểm tra bằng nhau xác nhận đủ tám giá trị sau giải mã, kể cả thứ tự và vị trí null.
Tài liệu DictionaryArray của Arrow mô tả biểu diễn này trong bộ nhớ. Hình dưới thể hiện quan hệ logic, không phải bố cục byte của trang Parquet hay bitmap đánh dấu giá trị hợp lệ trong Arrow. Một cột số nguyên thông thường chứa cùng những số ấy sẽ không giải thích được ý nghĩa của chúng nếu thiếu từ điển đi kèm.
Đếm giá trị phân biệt trong đúng phạm vi mã hóa
Cardinality ở đây là số giá trị khác nhau không phải null trong dữ liệu của cột được chọn. Giá trị lặp có thể được lưu một lần trong từ điển, còn nhiều hàng dùng chỉ số ngắn hơn. Nếu gần như mọi giá trị đều duy nhất, từ điển phải giữ gần hết dữ liệu gốc, trong khi tệp còn cần thêm luồng chỉ số.
Đặc tả mã hóa Parquet đặt từ điển trong một dictionary page của column chunk. Data page tham chiếu mục từ điển bằng mã hóa độ dài chuỗi lặp và đóng gói bit. Các chunk khác nhau có thể có từ điển khác nhau. Vì vậy, số khách hàng phân biệt trên toàn bảng chưa mô tả đầy đủ chi phí từ điển trong từng row group.
Độ dài giá trị cũng quan trọng. Tránh lưu lặp chuỗi dài có thể bù được nhiều chi phí từ điển hơn so với chuỗi ngắn. Thứ tự cũng ảnh hưởng vì một dãy dài cùng chỉ số có thể được biểu diễn khác với các chỉ số luân phiên. Cardinality là đầu vào hữu ích cho quyết định, không phải công thức dung lượng đầy đủ.
Trong thí nghiệm này, giữ nguyên thứ tự. Cột quốc gia lặp lần lượt VN, US, DE; cột yêu cầu có một chuỗi ASCII dài mười byte khác nhau trên mỗi hàng. Tất cả giá trị đều có mặt. Ví dụ tám hàng có null phía trên giải thích ý nghĩa dữ liệu, còn bộ thử thứ hai giúp phép so sánh dung lượng đơn giản hơn.
Ghi cùng bảng bằng ba thiết lập rõ ràng
Tùy chọn writer của Arrow cho phép tắt dictionary, bật cho những cột được chọn hoặc bật chung. Ở đây ta dùng một row group chứa 4.096 hàng, không dùng codec nén, bật statistics và chỉ định giới hạn dictionary page là một mebibyte. Mỗi biến thể đều bắt đầu từ cùng bảng chuỗi thông thường.
row_count = 4096
table = pa.table({
    'country': [['VN', 'US', 'DE'][i % 3] for i in range(row_count)],
    'request_id': [f'req-{i:06d}' for i in range(row_count)],
})
settings = {'plain': False, 'country_only': ['country'], 'both': True}
payloads = {}
for label, dictionary_setting in settings.items():
    output = pa.BufferOutputStream()
    pq.write_table(table, output, compression='NONE',
                   row_group_size=row_count,
                   use_dictionary=dictionary_setting,
                   dictionary_pagesize_limit=1024 * 1024,
                   write_statistics=True)
    payload = output.getvalue()
    payloads[label] = payload
    assert pq.read_table(pa.BufferReader(payload)).equals(table)
    group = pq.ParquetFile(pa.BufferReader(payload)).metadata.row_group(0)
    print(label, len(payload),
          group.column(0).total_compressed_size,
          group.column(1).total_compressed_size)
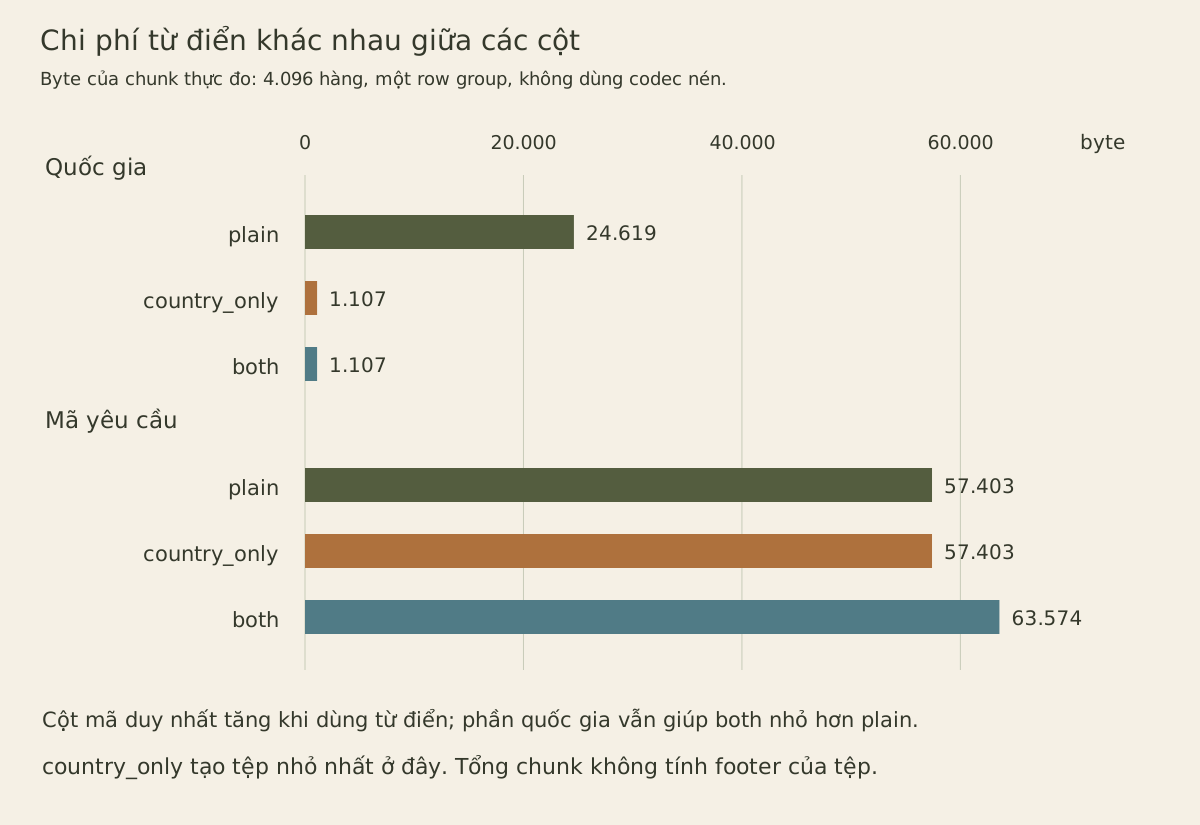
Bốn trường được in lần lượt là tên thiết lập, số byte toàn tệp, số byte chunk quốc gia và số byte chunk mã yêu cầu. Đây là độ dài thực đo trong môi trường đã ghi nhận:
| Thiết lập | Toàn tệp | Chunk quốc gia | Chunk mã yêu cầu |
|---|---|---|---|
| plain | 82.567 | 24.619 | 57.403 |
| country_only | 59.062 | 1.107 | 57.403 |
| both | 65.245 | 1.107 | 63.574 |
Bật từ điển cho quốc gia làm chunk ấy nhỏ đi đáng kể. Bật từ điển cho mã yêu cầu duy nhất làm chunk tương ứng tăng từ 57.403 lên 63.574 byte. Tệp both vẫn nhỏ hơn plain vì phần tiết kiệm ở quốc gia lớn hơn phần tăng ở mã yêu cầu. Tuy nhiên, nó lớn hơn country_only. Nếu chỉ so toàn tệp, ta sẽ bỏ qua thay đổi bất lợi trong một cột.
Thuộc tính metadata mang tên total_compressed_size dù các tệp này dùng compression='NONE'. Ở đây nó báo kích thước chunk đã lưu mà không qua codec nén. Mã hóa từ điển vẫn hoạt động ở các cột đã chọn. Độ dài tệp còn gồm footer và thành phần bao ngoài khác, nên cộng độ dài hai chunk không tái tạo được kích thước toàn tệp.
Phép kiểm tra so toàn bộ bảng sau mỗi lần ghi. Tiết kiệm dung lượng không có ích nếu nó làm đổi định danh, gán quốc gia sang hàng khác hoặc bỏ mất quan sát. Giữ cách dựng nguồn, phiên bản môi trường và hash dữ liệu tuần tự hóa cùng kết quả; writer phiên bản sau có thể tạo byte khác mà vẫn giữ đúng giá trị.
Giải thích hướng thay đổi mà không dự đoán từng byte
Với những chuỗi ASCII này, biểu diễn PLAIN lưu bốn byte độ dài rồi đến các byte của chuỗi. Bỏ qua thành phần bao trang và chi tiết định dạng khác, lưu trực tiếp giá trị quốc gia lặp lại cần 4096 × (4 + 2) = 24.576 byte. Từ điển ba mục lưu 18 byte giá trị. Luồng lý tưởng có 4.096 chỉ số, mỗi chỉ số hai bit, thêm 1.024 byte.
Tổng đơn giản hóa 1.042 byte giải thích cơ hội tiết kiệm; nó không dự đoán chính xác chunk 1.107 byte đã đo. Định dạng thật có header, cách mã hóa chỉ số và thông tin mức riêng. Đừng trình bày số bit lý tưởng như dung lượng tệp đã quan sát.
Với mã yêu cầu, riêng giá trị cần 4096 × (4 + 10) = 57.344 byte. Từ điển có 4.096 mục phân biệt vẫn cần những giá trị ấy, trong khi chỉ số lý tưởng mười hai bit cho mỗi hàng thêm 6.144 byte. Cách tính đơn giản giải thích vì sao cột duy nhất có thể phình ra. Nó không phải quy tắc phổ quát rằng mã hóa từ điển luôn bất lợi trên một ngưỡng cardinality cụ thể, nhất là khi phép so sánh có thêm codec, chuỗi dài hơn hoặc ranh giới row group khác.
Đọc metadata mà không tự suy ra bằng chứng ở cấp trang
Kiểm tra column chunk nào có vị trí dictionary page và metadata liệt kê những kiểu mã hóa nào:
for label, payload in payloads.items():
    group = pq.ParquetFile(pa.BufferReader(payload)).metadata.row_group(0)
    print(label, [group.column(i).dictionary_page_offset is not None
                  for i in range(2)])
    print(label, [group.column(i).encodings for i in range(2)])
Sự hiện diện của dictionary page lần lượt là [False, False], [True, False] và [True, True] với ba thiết lập. Cột được chọn liệt kê PLAIN, RLE, RLE_DICTIONARY. Điều này xác nhận các tệp có dictionary page ở nơi đã yêu cầu. Nó không đếm được bao nhiêu data page dùng từng kiểu mã hóa.
Đặc biệt, thấy PLAIN trong danh sách không chứng minh writer đã chuyển sang cách ghi không dùng từ điển: chính đặc tả dùng PLAIN cho các mục trong dictionary page. Định dạng cho phép chuyển sang PLAIN khi từ điển quá lớn. Giới hạn kích thước cấu hình ở writer liên quan tới hành vi đó, nhưng bài này không giải mã header của từng trang hoặc tuyên bố đã tìm được ranh giới chuyển đổi. Kết luận ở cấp trang cần bằng chứng ở cấp trang.
Tách biểu diễn khi đọc khỏi mã hóa đã lưu
Bộ đọc có thể dựng dictionary array của Arrow ngay cả từ cột Parquet được lưu không dùng mã hóa từ điển. Tài liệu đọc của Arrow cung cấp read_dictionary cho lựa chọn này trên các cột được hỗ trợ. Đọc cột quốc gia từ tệp plain theo cách ấy:
read_back = pq.read_table(pa.BufferReader(payloads['plain']),
                          read_dictionary=['country'])
country = read_back.column('country').combine_chunks()
print(pa.types.is_dictionary(country.type), len(country.dictionary))
assert country.dictionary_decode().equals(table.column('country').combine_chunks())

other = pa.array(['US', 'VN', 'US']).dictionary_encode()
print(encoded.indices[0].as_py(), encoded.dictionary[0].as_py())
print(other.indices[0].as_py(), other.dictionary[0].as_py())
Đầu ra đầu tiên là True 3: mảng quốc gia được trả về có kiểu từ điển với ba mục. Metadata phía trước vẫn cho biết tệp gốc không có dictionary page cho cột ấy. Vì vậy, từ điển trong bộ nhớ không phải bằng chứng writer đã dùng từ điển trên đĩa.
Hai dòng cuối in 0 VN và 0 US. Mỗi chỉ số 0 đều đúng trong mảng riêng của nó. So những chỉ số thô ấy giữa các lô sẽ gán nhầm hai quốc gia khác nhau thành cùng một giá trị. Hãy giải mã nhãn hoặc dùng định danh ổn định được định nghĩa riêng trước khi nối bản ghi phân tích. Chỉ số từ điển cục bộ là chi tiết triển khai, không phải khóa nghiệp vụ.
Bài Arrow ngày 5 tháng 9 năm 2019 của Wes McKinney giải thích khác biệt giữa mã hóa Parquet và dictionary array của Arrow, gồm từ điển thay đổi giữa các chunk và xử lý phần chuyển sang PLAIN. Các phép đo hiệu năng trong bài ấy so những phiên bản Arrow trước đây. Chúng không phải thời gian của bộ thử này hay lời hứa cho tải công việc hiện tại.
Đổi một giả định rồi kiểm tra lại kết quả
Bài tập thứ nhất là làm mọi mã yêu cầu bằng req-shared, dựng lại đủ ba biến thể và kiểm tra toàn bộ dữ liệu đọc lại. Dự đoán hướng thay đổi kích thước cột yêu cầu trước khi đọc metadata. Giá trị lặp giờ tạo cơ hội dùng từ điển mà các định danh duy nhất không có.
Sau đó khôi phục yêu cầu duy nhất và chia bảng gốc thành row group nhỏ hơn. Đếm dictionary page thực tế bằng cách kiểm tra vị trí của trang ấy trong từng chunk, rồi xem các kích thước thu được. Chunk bổ sung tạo từ điển và phần bao định dạng riêng. Giữ thí nghiệm ấy tách khỏi mốc một nhóm, thay vì giải thích mọi thay đổi chỉ bằng cardinality.
Chọn thiết lập từ những cột và bên sử dụng thực sự có trong hệ thống. Tệp nhỏ nhất của ví dụ dùng từ điển có chọn lọc. Quyết định thực tế còn cần kiểm tra các bộ đọc được hỗ trợ và, nếu cần, đo riêng thời gian đọc, thời gian ghi cùng bộ nhớ. Kết luận hữu ích ở đây hẹp hơn: cùng những hàng ấy giữ nguyên ý nghĩa dưới cả ba thiết lập, nhưng các cột có chi phí lưu trữ thực đo khác nhau.