Hiểu row group của Parquet qua một phép quét nhỏ
Ghi hai tệp có cùng mười hai chuyến, đọc khoảng ngày trong metadata và kiểm tra chọn cột, bỏ nhóm, thiếu statistics cùng giới hạn của số đo.
Truy vấn Parquet có thể bỏ qua phần lớn bảng mà không phải nạp mọi hàng vào dataframe trước. Hai quyết định riêng tạo ra khả năng đó: truy vấn cần cột nào, và nhóm hàng nào có thể chứa kết quả phù hợp. Nếu gộp hai quyết định này, ta dễ nhầm kết quả ít hàng với lượng dữ liệu quét ít.
Bài này dành cho người đọc đã quen phép tổng hợp SQL có điều kiện lọc. Chúng ta sẽ ghi mười hai chuyến đi giả định, đọc metadata thực tế rồi chạy cùng phép tính trên hai thứ tự lưu trữ. Môi trường cục bộ là Python 3.12.3, PyArrow 23.0.1 và DuckDB 1.4.4. Thí nghiệm xác nhận số hàng trả về và hoạt động của bộ đọc do ta viết rõ, không đo độ trễ lưu trữ hay số byte hệ điều hành đọc.
Một row group chứa các cột của cùng tập hàng
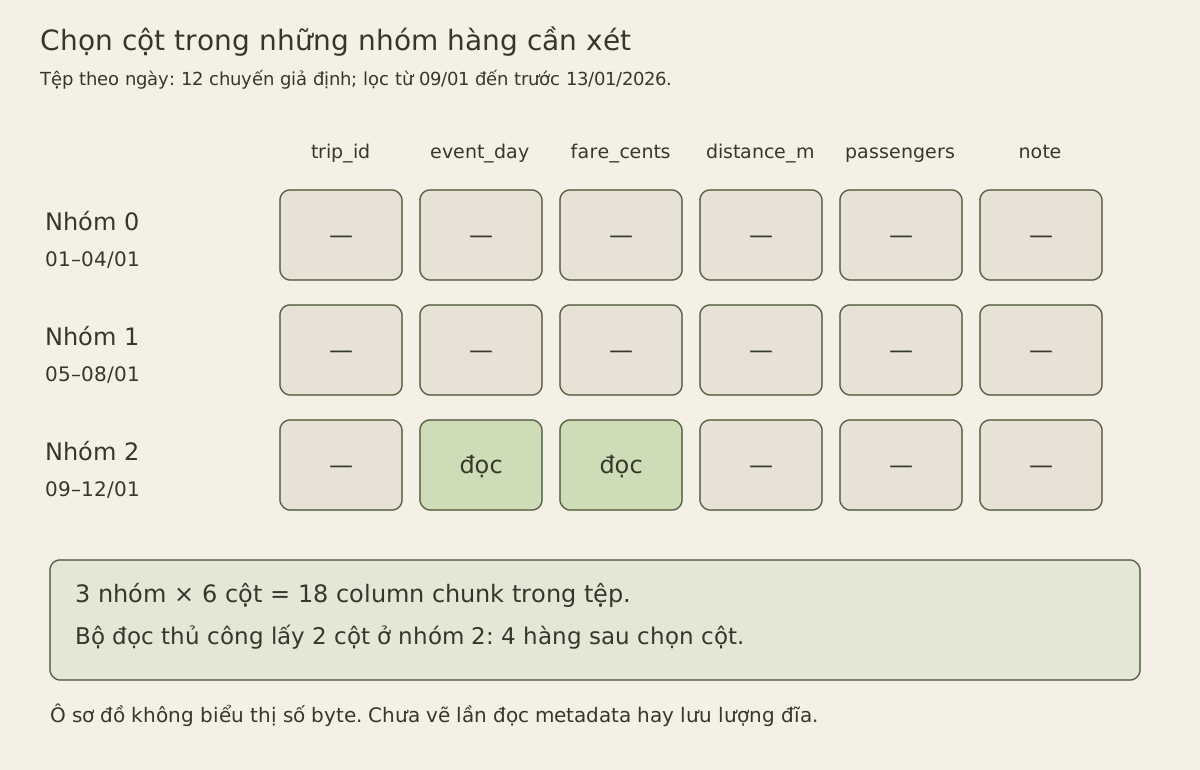
Row group là một lát cắt ngang theo hàng của bảng. Bên trong nó, mỗi cột có một column chunk; chunk lại chứa các trang đã mã hóa. Trong ví dụ sáu cột phẳng này, mỗi nhóm có sáu chunk. Chunk fare_cents mô tả cùng bốn chuyến với chunk event_day bên cạnh, dù các giá trị được lưu riêng. Tài liệu thuật ngữ Parquet phân biệt các cấp đó và bảo đảm một column chunk nằm liên tục trong tệp, chứ không bảo đảm cấu trúc vật lý cụ thể cho toàn bộ row group.
Mô tả định dạng tệp đặt metadata của tệp sau phần dữ liệu và lưu vị trí của các chunk. Bộ đọc thường lấy metadata trước khi quyết định chunk nào cần thiết. Vì thế, “bỏ qua một nhóm hàng” không đồng nghĩa với “không đọc gì trong tệp”. Bản thân metadata cũng có chi phí.
Truy vấn của ta đếm chuyến và cộng tiền từ ngày 9 tháng 1, tính cả ngày đó, đến trước ngày 13 tháng 1. Nó cần event_day để lọc và fare_cents để tính tổng. Ghi chú hóa đơn, số hành khách, quãng đường và định danh chuyến đều không cần. Kết quả có hai trường, nhưng hai trường đầu ra không phải danh sách nguyên xi các cột nguồn: count(*) là phép tổng hợp, còn cột ngày vẫn cần dù không xuất hiện trong kết quả.
Ghi cùng bảng logic theo hai thứ tự
Cả mười hai hàng đều được tạo để minh họa, mỗi ngày một chuyến trong tháng 1 năm 2026. Chuyến i có tiền cước 100*i cent. Ngày đã là ngày báo cáo đáng tin cậy; bộ thử không suy ra nó từ timestamp địa phương. Cent dùng số nguyên chính xác và mọi tổng đều nằm trong giới hạn biểu diễn đã chọn.
Tệp đầu giữ thứ tự thời gian. Tệp thứ hai hoán vị đúng các hàng ấy. Cả hai dùng bốn hàng mỗi nhóm, bật statistics rõ ràng, tắt mã hóa dictionary và không nén. Các thiết lập giúp quan sát ví dụ, không phải mặc định khuyến nghị cho vận hành. Tài liệu writer theo phiên bản của Arrow định nghĩa row_group_size là số hàng tối đa, không phải kích thước byte.
from datetime import date
from pathlib import Path
from tempfile import TemporaryDirectory
import pyarrow as pa
import pyarrow.compute as pc
import pyarrow.parquet as pq
import duckdb

schema = pa.schema([
    ('trip_id', pa.int64()), ('event_day', pa.date32()),
    ('fare_cents', pa.int64()), ('distance_m', pa.int32()),
    ('passengers', pa.int16()), ('note', pa.string()),
])
rows = [dict(trip_id=i, event_day=date(2026, 1, i),
             fare_cents=100*i, distance_m=500*i,
             passengers=1+i%3, note='Synthetic receipt ' + str(i))
        for i in range(1, 13)]
original = pa.Table.from_pylist(rows, schema=schema)
scrambled = original.take(pa.array([0, 4, 8, 1, 5, 9, 2, 6, 10, 3, 7, 11]))
work = TemporaryDirectory()
root = Path(work.name)
for name, table in [('sorted', original), ('scrambled', scrambled)]:
    pq.write_table(table, root / f'{name}.parquet', row_group_size=4,
                   compression='NONE', use_dictionary=False,
                   write_statistics=True)

def describe(path):
    metadata = pq.ParquetFile(path).metadata
    day_column = schema.get_field_index('event_day')
    return [(g, metadata.row_group(g).num_rows,
             metadata.row_group(g).column(day_column).statistics.min,
             metadata.row_group(g).column(day_column).statistics.max)
            for g in range(metadata.num_row_groups)]

for name in ('sorted', 'scrambled'):
    print(name, describe(root / f'{name}.parquet'))
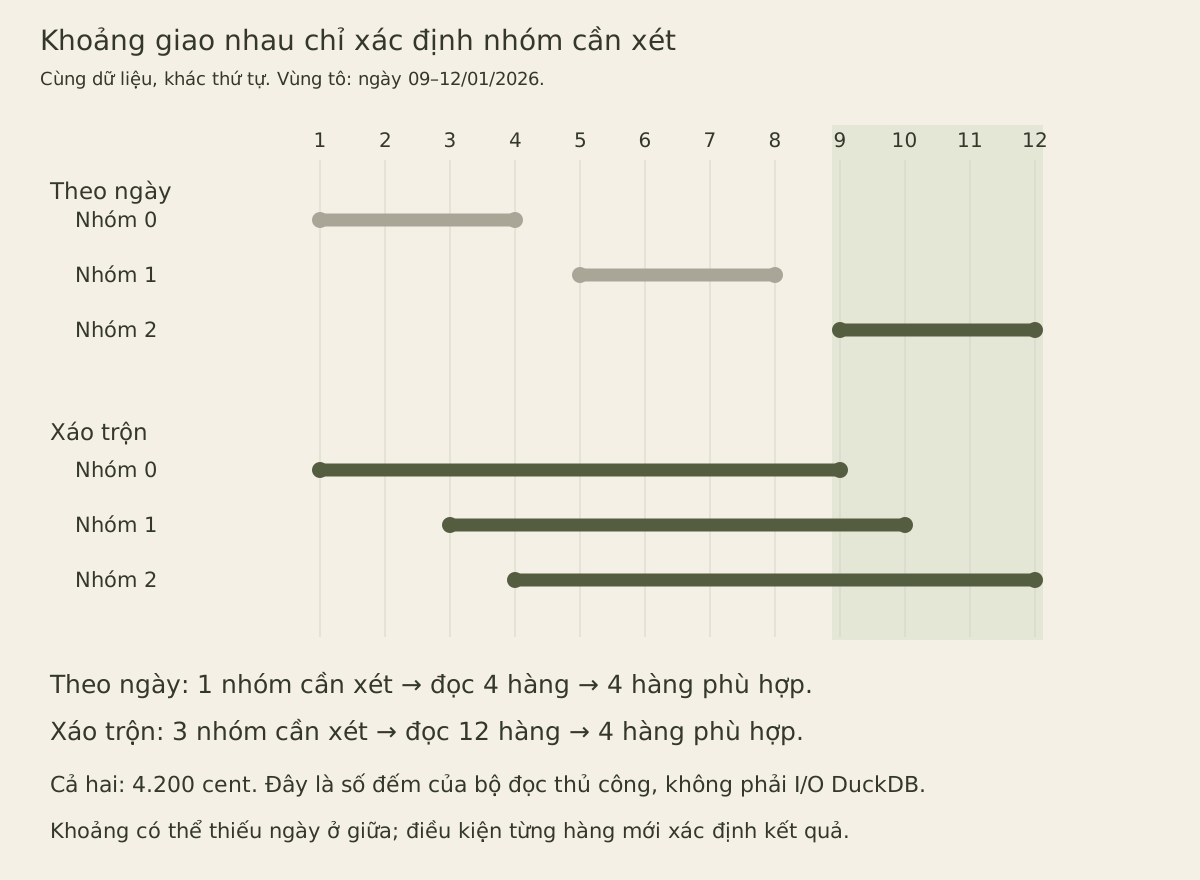
Chạy các khối sau trong cùng tiến trình Python để dùng chung thư mục tạm. Mỗi tệp có mười hai hàng và ba nhóm. Các khoảng ngày đọc được từ metadata là:
| Nhóm | Tệp theo thứ tự ngày | Tệp xáo trộn |
|---|---|---|
| 0 | Ngày 1–4 tháng 1 | Ngày 1–9 tháng 1 |
| 1 | Ngày 5–8 tháng 1 | Ngày 3–10 tháng 1 |
| 2 | Ngày 9–12 tháng 1 | Ngày 4–12 tháng 1 |
Đó là thông tin tóm tắt, không phải danh sách đầy đủ những ngày có mặt. Nhóm 0 của tệp xáo trộn chứa ngày 1, 5, 9 và 2. Giá trị nhỏ nhất và lớn nhất không chứng minh các ngày 3, 4, 6, 7 hoặc 8 xuất hiện trong nhóm.
Loại nhóm không thể phù hợp rồi lọc từng hàng thực tế
Với khoảng ngày nửa mở [lower, upper), một nhóm không thể đóng góp khi giá trị lớn nhất nhỏ hơn lower, hoặc giá trị nhỏ nhất lớn hơn hay bằng upper. Trường hợp còn lại có khoảng chồng lấn nên nhóm vẫn là ứng viên cần xét. Chồng lấn cho phép kiểm tra tiếp, không chứng minh rằng có hàng thực sự phù hợp.
Hàm tiếp theo cố ý chỉ xử lý cột date32 phẳng này và phép so sánh khoảng ngày thông thường. Nó tin metadata đã được ghi đúng. Khi thiếu statistics, hàm giữ lại nhóm theo hướng thận trọng. Đây không phải bộ tối ưu Parquet tổng quát cho cột lồng nhau, biểu thức tùy ý, metadata sai hoặc ngữ nghĩa so sánh khác.
def possible_groups(path, lower, upper):
    parquet = pq.ParquetFile(path)
    day_column = parquet.schema_arrow.get_field_index('event_day')
    selected = []
    for g in range(parquet.metadata.num_row_groups):
        stats = parquet.metadata.row_group(g).column(day_column).statistics
        if stats is None or not stats.has_min_max:
            selected.append(g)
        elif not (stats.max < lower or stats.min >= upper):
            selected.append(g)
    return selected


def manual_summary(path, lower, upper):
    groups = possible_groups(path, lower, upper)
    table = pq.ParquetFile(path).read_row_groups(
        groups, columns=['event_day', 'fare_cents'])
    mask = pc.and_(pc.greater_equal(table['event_day'], pa.scalar(lower)),
                   pc.less(table['event_day'], pa.scalar(upper)))
    matches = table.filter(mask)
    return groups, table.num_rows, matches.num_rows, pc.sum(matches['fare_cents']).as_py()

for name in ('sorted', 'scrambled'):
    print(name, manual_summary(root / f'{name}.parquet',
                               date(2026, 1, 9), date(2026, 1, 13)))
Đầu ra chính xác là sorted ([2], 4, 4, 4200) và scrambled ([0, 1, 2], 12, 4, 4200). Mỗi tuple lần lượt cho biết chỉ số nhóm ứng viên, số hàng bộ đọc thủ công đưa vào bộ nhớ, số hàng phù hợp và tổng cent. Hai đáp án đều là bốn chuyến và 4.200 cent: 900 + 1.000 + 1.100 + 1.200.
Thứ tự ngày cho phép phép kiểm tra metadata loại nhóm 0 và 1. Thứ tự xáo trộn phân tán ngày muộn trong cả ba khoảng, nên bộ đọc đưa mười hai hàng của các cột được chọn vào bộ nhớ trước khi lọc. Bộ đọc thủ công yêu cầu Arrow lấy cả hai cột đã chọn trong mỗi nhóm được giữ; nó không dựa vào giả định chưa được chứng minh rằng Arrow tự áp dụng đúng cùng quy tắc loại nhóm.
Đổi khoảng thành từ ngày 6 tháng 1, tính cả ngày đó, đến trước ngày 7 tháng 1. Mọi khoảng của tệp xáo trộn vẫn chồng lấn, nhưng chỉ một chuyến thực sự phù hợp. Đây là phản ví dụ hữu ích cho việc coi chồng lấn min/max như số hàng. Thứ tự ngày tạo cơ hội bỏ qua nhóm, còn điều kiện trên từng hàng mới xác lập đáp án.
Chạy SQL và giữ đúng phạm vi điều đã đo
Tài liệu Parquet của DuckDB mô tả projection pushdown và filter pushdown. Cơ chế đầu giới hạn các cột cần yêu cầu; cơ chế sau có thể dùng statistics sẵn có để tránh phần dữ liệu không liên quan. Truy vấn sau thực sự chạy trên cả hai tệp:
with duckdb.connect() as connection:
    for name in ('sorted', 'scrambled'):
        answer = connection.execute('''
            SELECT count(*), sum(fare_cents)
            FROM read_parquet(?)
            WHERE event_day >= DATE '2026-01-09'
              AND event_day < DATE '2026-01-13'
        ''', [str(root / f'{name}.parquet')]).fetchone()
        print(name, answer)
        assert answer == (4, 4200)
Nó trả (4, 4200) hai lần. Điều đó chứng minh kết quả khớp nhau trên bộ thử này. Nó không chứng minh DuckDB thực hiện đúng các lần đọc như triển khai Arrow thủ công của ta. Bộ đọc có thể dùng thêm metadata, bộ đệm, tác vụ song song hoặc tối ưu khác. Muốn báo mức cải thiện lưu lượng lưu trữ hay thời gian chạy, hãy đo chính lần thực thi đó và nêu hệ thống tệp, trạng thái cache, phiên bản cùng tải công việc.
Bài kỹ thuật ngày 25 tháng 6 năm 2021 của Hannes Mühleisen và Mark Raasveldt giải thích chọn cột và bỏ qua khoảng ngày bằng dữ liệu taxi. Ta dùng cơ chế ấy ở đây, không dùng số đo thời gian lịch sử hay so sánh của bài với các bộ đọc dataframe khác. Mười hai hàng đủ để quan sát tính đúng; chúng không xác lập hệ số tăng tốc hữu ích trong vận hành.
Bỏ statistics để xem cách xử lý dự phòng
Sự có mặt của metadata là một phần thí nghiệm. Ghi lại bảng theo thứ tự ngày nhưng tắt statistics, rồi chạy bộ đọc thủ công. Đồng thời hỏi tệp ban đầu về một khoảng nằm hoàn toàn sau các ngày đã có:
without_stats = root / 'without-stats.parquet'
pq.write_table(original, without_stats, row_group_size=4,
               compression='NONE', use_dictionary=False, write_statistics=False)
print('no stats', manual_summary(without_stats, date(2026, 1, 9), date(2026, 1, 13)))
print('outside', manual_summary(root / 'sorted.parquet', date(2026, 1, 20), date(2026, 1, 21)))
Kết quả thứ nhất là ([0, 1, 2], 12, 4, 4200): đáp án không đổi, nhưng hàm này không thể loại nhóm nào. Khoảng nằm ngoài dữ liệu cho ([], 0, 0, None). Không có tiền cước phù hợp, nên tổng là null thay vì một tổng đã quan sát có giá trị bằng không. SUM trong SQL cũng giữ sự phân biệt đầu vào rỗng ấy trong ví dụ này.
Hãy xem đây là phép kiểm tra các giả định cụ thể. Nhóm có toàn ngày null cũng không có cặp min/max hữu ích; giữ lại nhóm là an toàn, rồi điều kiện ngày phía sau loại các hàng null. Đừng tự đặt giá trị nhỏ nhất bằng không hay cho rằng thiếu statistics nghĩa là không có hàng phù hợp. Xác thực khi nhập, tính đầy đủ của nguồn và đơn vị đúng vẫn là trách nhiệm riêng, không được giải quyết bằng cách loại nhóm trong tệp.
Chọn ranh giới theo tải công việc
Nhóm bốn hàng phục vụ việc học. Nhóm nhỏ hơn có thể mô tả khoảng hẹp hơn và tạo thêm phần việc độc lập, nhưng cũng tăng metadata và chi phí xử lý. Nhóm lớn hơn giảm số ranh giới, đồng thời có thể buộc nhiều hàng không liên quan đi qua bước quét. Sắp xếp cũng có chi phí ghi và chỉ giúp các bộ lọc liên quan tới thứ tự đã chọn. Tệp sắp theo ngày không tự tạo khoảng hẹp cho mọi giá trị số hành khách hoặc tiền cước.
Phân biệt những lựa chọn này với phân vùng thư mục và số lượng tệp. Chia dữ liệu thành hàng nghìn tệp rất nhỏ làm đổi chi phí liệt kê, mở và đọc metadata; việc đó không tương đương đổi kích thước row group trong một tệp. Chọn cột cũng là quyết định về hiệu quả, không phải ranh giới kiểm soát truy cập: bên được phép đọc cả tệp có thể yêu cầu các cột khác.
Bài tập cuối là ghi lại bảng theo thứ tự ngày với sáu hàng mỗi nhóm. Dự đoán nhóm nào giao khoảng ngày 9 đến ngày 12 tháng 1 rồi đọc metadata và chạy bộ đọc thủ công. Nó phải giữ một nhóm có sáu hàng, trả bốn hàng phù hợp và bảo toàn 4.200 cent. Sau đó truy vấn từ ngày 8 tháng 1, tính cả ngày đó, đến trước ngày 10 tháng 1 trên cách chia bốn hàng ban đầu: hai nhóm là ứng viên, tám hàng được đưa vào bộ nhớ và hai khoản cước cộng thành 1.700 cent. Tạo lại bộ dữ liệu trước khi lặp các thay đổi và gọi work.cleanup() khi làm xong. Kết quả hữu ích là lời giải thích có căn cứ từ metadata và các hàng phù hợp: phần nào có thể bỏ qua, và vì sao.