Đếm giá trị thiếu mà không làm đổi mẫu số
Đếm đúng số người, biểu mẫu và điểm quan sát bằng SQL, với danh sách mời riêng, nhóm rỗng và quy tắc rõ ràng cho giá trị thiếu.
COUNT(*) đếm số dòng. COUNT(rating) chỉ đếm những dòng có rating khác NULL. Khác biệt này quyết định một người bỏ qua câu hỏi có còn nằm trong mẫu số của tỷ lệ phản hồi hay không. Điểm 0 vẫn là một câu trả lời hợp lệ trên thang điểm đã quy định; giá trị chưa biết chỉ được tính vào số người tham gia.
Nếu đang học SQL để phân tích dữ liệu, bạn nên xác định tập đối tượng cần đo trước khi viết phép tổng hợp. “Điểm trung bình” thường là trung bình của những người đã cho điểm. “Tỷ lệ trả lời câu hỏi” lại hỏi bao nhiêu người đủ điều kiện đã cho điểm. Hai chỉ số có thể đọc cùng một bảng nhưng dùng hai mẫu số khác nhau. Các ví dụ dưới đây chỉ cần kiến thức cơ bản về SELECT, hàm tổng hợp và LEFT JOIN.
Bốn người tham gia, ba câu trả lời
Khảo sát giả lập này có bốn người đã được ghi nhận. Thang điểm chạy từ không đến năm. Người 103 bỏ qua câu hỏi nên cơ sở dữ liệu lưu NULL. Người 104 chủ động chọn điểm 0.
CREATE TEMP TABLE survey (
  participant_id INTEGER PRIMARY KEY,
  rating INTEGER
);
INSERT INTO survey VALUES (101, 5), (102, 4), (103, NULL), (104, 0);

SELECT
  COUNT(*) AS participants,
  COUNT(rating) AS answered,
  COUNT(*) - COUNT(rating) AS unanswered,
  AVG(rating) AS mean_answered,
  1.0 * COUNT(rating) / NULLIF(COUNT(*), 0) AS response_rate
FROM survey;
Kết quả có bốn người tham gia, ba câu trả lời, một giá trị thiếu, điểm trung bình 3,0 và tỷ lệ trả lời 0,75. Các truy vấn trong bài đã được chạy bằng SQLite 3.45.1. Tài liệu hàm tổng hợp của PostgreSQL cũng phân biệt việc đếm dòng với đếm biểu thức khác NULL theo cách này.
Nhân với 1.0 khiến SQLite thực hiện phép chia có phần thập phân. Nếu chia hai số nguyên, bạn có thể làm mất phần lẻ của tỷ lệ. NULLIF bảo vệ mẫu số và thể hiện một quyết định rõ ràng: khi không có ai tham gia, tỷ lệ không xác định. Giao diện có thể hiển thị “không có người đủ điều kiện”. Hiển thị số không trong trường hợp ấy sẽ ngụ ý rằng có một tập người tham gia nhưng không ai trả lời.
Điểm trung bình là chín chia ba. Phải giữ điểm 0 vì nó thuộc thang điểm hợp lệ. Nếu thay NULL bằng không trước khi tính trung bình, kết quả sẽ thành chín chia bốn, tức 2,25. Phép thay thế đó đã tự thêm một câu trả lời mà người tham gia chưa từng cung cấp.
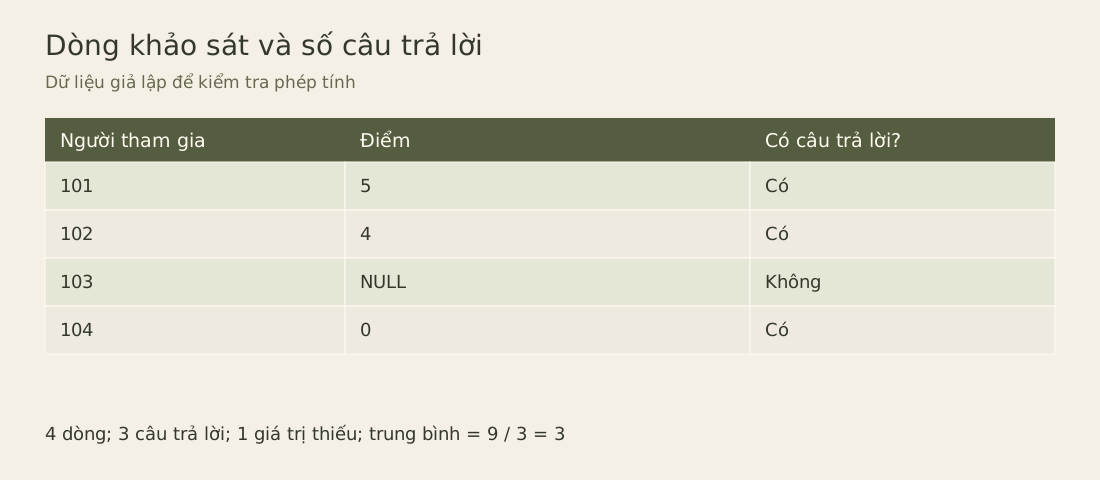
Hai phép đếm nhận cùng tập dòng đầu vào. Chỉ có quy tắc đưa điểm vào phép đếm là khác nhau. Khi hiển thị điểm trung bình, nên đặt số câu trả lời bên cạnh để người đọc biết có bao nhiêu quan sát thực sự hỗ trợ con số đó.
Điều kiện lọc có thể đổi tập đối tượng
Giả sử bạn chuyển điều kiện loại giá trị thiếu vào WHERE:
SELECT COUNT(*) AS remaining_rows, AVG(rating) AS mean_answered
FROM survey
WHERE rating IS NOT NULL;
Kết quả còn ba dòng, trong khi điểm trung bình vẫn là 3,0. Trung bình không đổi vì bản thân AVG đã bỏ qua các điểm NULL. Số dòng thì đã đổi. Nếu lấy số người trả lời chia cho số dòng còn lại sau bước lọc, mọi dòng được giữ đều đã có câu trả lời, nên tỷ lệ trở thành 100%.
Bước lọc này phù hợp nếu tập cần phân tích là những người đã trả lời câu hỏi. Nó không phù hợp khi mẫu số phải bao gồm mọi người đủ điều kiện. Hãy đọc tên chỉ số trước khi chấp nhận truy vấn: “tỷ lệ người tham gia đã cho điểm” và “tỷ lệ bản ghi điểm có giá trị” mô tả hai phép tính khác nhau, dù SQL chỉ lệch một điều kiện.
Dữ liệu sự kiện trong ứng dụng cũng có vấn đề tương tự. Một bảng chỉ chứa sự kiện đã được gửi lên không thể đếm những người có thiết bị không gửi được sự kiện. Nếu chỉ số nói đến mọi người được mời hoặc mọi người dùng đang hoạt động, mẫu số cần một nguồn xác định điều kiện tham gia độc lập. Thiếu cả dòng và có dòng nhưng thiếu một trường là hai tình huống khác nhau.
Đếm theo điều kiện mà vẫn giữ các dòng còn lại
Bạn có thể đếm nhiều nhóm câu trả lời trong một phép tổng hợp mà không thay đổi tập người tham gia ban đầu:
SELECT
  SUM(CASE WHEN rating >= 4 THEN 1 ELSE 0 END) AS high_ratings,
  SUM(CASE WHEN rating = 0 THEN 1 ELSE 0 END) AS zero_ratings,
  SUM(CASE WHEN rating IS NULL THEN 1 ELSE 0 END) AS missing_ratings
FROM survey;
Kết quả là hai điểm cao, một điểm 0 và một giá trị thiếu. Biểu thức CASE trả về không cho dòng không thuộc nhóm đang đếm, nên quy tắc khá dễ kiểm tra. Cần tránh COUNT(CASE WHEN condition THEN 1 ELSE 0 END) khi muốn đếm dòng thỏa điều kiện: cả một lẫn không đều khác NULL, nên biểu thức ấy đếm tất cả các dòng.
Nếu bảng không có dòng nào, những phép SUM này trả về NULL trong SQLite. Nếu quy ước báo cáo yêu cầu số lượng của nhóm rỗng bằng không, hãy áp dụng giá trị mặc định cho kết quả tổng hợp. Gán mặc định cho từng giá trị đo trước khi tổng hợp mang ý nghĩa khác, như phép trung bình bị đổi thành 2,25 ở trên.
Bắt đầu từ danh sách mời nếu có người không gửi biểu mẫu
Ví dụ bốn dòng giả định mỗi người đủ điều kiện đều đã có bản ghi. Nhiều hệ thống khảo sát chỉ lưu những biểu mẫu đã được gửi. Với thiết kế đó, COUNT(*) trên bảng gửi biểu mẫu không cho biết bao nhiêu người được mời chưa từng mở biểu mẫu. Bạn cần danh sách mời riêng, được xác định theo cùng thời điểm chốt báo cáo với dữ liệu trả lời.
Bộ dữ liệu tiếp theo phân biệt các tình huống: có điểm quan sát, có biểu mẫu nhưng thiếu điểm, không có biểu mẫu, và một nhóm không có ai được mời. Nó còn có một nhóm mà mọi điểm trong các biểu mẫu đã gửi đều là NULL. Tên nhóm chỉ là nhãn tùy chọn; tất cả người trong ví dụ đều đủ điều kiện trả lời câu hỏi. Đây là dữ liệu giả lập, không phải tỷ lệ phản hồi đo được từ một khảo sát thực tế.
CREATE TEMP TABLE cohorts (cohort TEXT PRIMARY KEY);
CREATE TEMP TABLE invitations (
  participant_id INTEGER PRIMARY KEY,
  cohort TEXT NOT NULL
);
CREATE TEMP TABLE submissions (
  participant_id INTEGER PRIMARY KEY,
  rating INTEGER CHECK (rating BETWEEN 0 AND 5)
);
INSERT INTO cohorts VALUES ('north'), ('south'), ('followup'), ('empty');
INSERT INTO invitations VALUES
  (101, 'north'), (102, 'north'),
  (103, 'south'), (104, 'south'), (105, 'south'),
  (106, 'followup'), (107, 'followup');
INSERT INTO submissions VALUES
  (101, 5), (102, 4), (103, NULL), (104, 0),
  (106, NULL), (107, NULL);

SELECT c.cohort,
  COUNT(i.participant_id) AS invited,
  COUNT(s.participant_id) AS submitted,
  COUNT(s.rating) AS rated,
  AVG(s.rating) AS mean_rating,
  1.0 * COUNT(s.rating)
    / NULLIF(COUNT(i.participant_id), 0) AS rating_coverage
FROM cohorts AS c
LEFT JOIN invitations AS i ON i.cohort = c.cohort
LEFT JOIN submissions AS s ON s.participant_id = i.participant_id
GROUP BY c.cohort
ORDER BY c.cohort;
Kết quả đã kiểm tra:
| Nhóm | Được mời | Đã gửi biểu mẫu | Có điểm | Điểm trung bình | Tỷ lệ có điểm |
|---|---|---|---|---|---|
| empty | 0 | 0 | 0 | NULL | NULL |
| followup | 2 | 2 | 0 | NULL | 0 |
| north | 2 | 2 | 2 | 4,5 | 1 |
| south | 3 | 2 | 1 | 0 | 1/3 |
Nhóm empty vẫn tạo ra một dòng với các trường phía phải là NULL, vì truy vấn bắt đầu từ bảng cohorts. Vì vậy, COUNT(*) sẽ trả về một dòng cho nhóm này, dù không có ai được mời. Đếm khóa chính khác NULL từ bảng invitations mới cho số không như mong muốn. Cũng theo cách đó, COUNT(s.participant_id) đếm biểu mẫu đã gửi, còn COUNT(s.rating) đếm điểm đã được cung cấp.
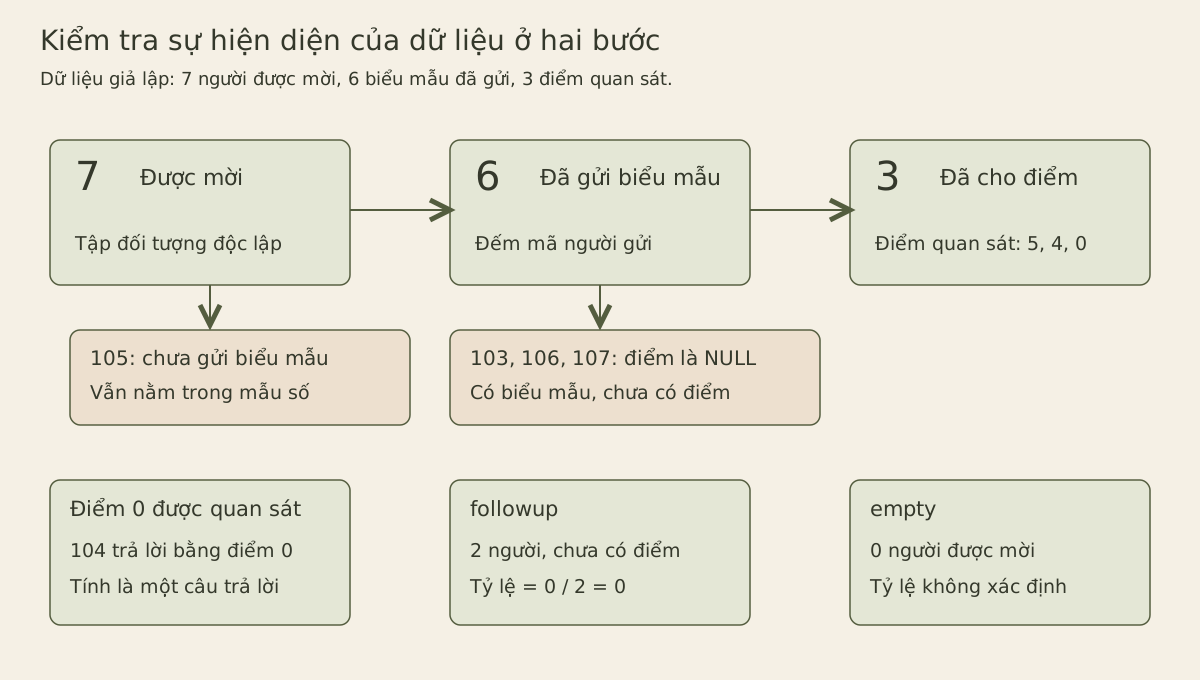
Hình thứ hai theo dõi sự hiện diện của dữ liệu ở hai bước. Không gửi biểu mẫu và gửi nhưng thiếu điểm đều làm giảm tỷ lệ có điểm, nhưng cần cách điều tra khác nhau. Trường hợp đầu có thể cần kiểm tra việc chuyển lời mời; trường hợp sau có thể cần xem thiết kế câu hỏi hoặc quy tắc nhập dữ liệu. SQL không tự chọn được nguyên nhân.
Khóa chính trên submissions.participant_id thực thi giả định mỗi người chỉ có một bản gửi. Nếu sản phẩm cho phép sửa câu trả lời, trước hết phải chọn một phiên bản hợp lệ cho mỗi người theo quy tắc rõ ràng về thời gian và trạng thái. Nếu không, một người gửi ba lần có thể làm cả hai phép đếm tăng lên, che khuất một người khác chưa gửi. Đếm mã lời mời bằng DISTINCT chỉ sửa được mẫu số đó; nó không tự sửa điểm trung bình vẫn đang chứa các câu trả lời lặp.
Với followup, tỷ lệ bằng không nghĩa là có người đủ điều kiện nhưng chưa quan sát được điểm nào. Với empty, tỷ lệ không xác định vì không có tập người đủ điều kiện. Với south, điểm trung bình bằng 0 là giá trị thật do người 104 cung cấp, không phải số mặc định trên giao diện. Hãy giữ nguyên ba ý nghĩa này khi chuyển kết quả sang biểu đồ hoặc API. Điểm 0 đi cùng một quan sát khác hẳn trung bình NULL đi cùng không quan sát.
Một lựa chọn triển khai hữu ích là cung cấp cả tử số và mẫu số bên cạnh tỷ lệ, thay vì chỉ lưu phần trăm đã làm tròn. Ứng dụng có thể hiển thị “1 trên 3” và chọn số chữ số thập phân phù hợp. Giá trị một phần ba trong kết quả truy vấn là số gần đúng dấu phẩy động; hiển thị 33,3% là quyết định trình bày, không làm phép đo chính xác hơn.
Bài viết của Lukas Eder về COUNT trên blog jOOQ cũng phân tích lỗi đếm sau phép nối ngoài. Các so sánh hiệu năng trong nguồn đó gắn với những hệ thống và phiên bản cụ thể. Điểm được áp dụng ở đây là khả năng nhận NULL của biểu thức; bài này không khẳng định một cách viết sẽ nhanh hơn trên dữ liệu của bạn.
Kiểm tra báo cáo bằng cách thay đổi tập dữ liệu
Thay đổi có kiểm soát một bộ dữ liệu nhỏ giúp kiểm tra ý nghĩa của chỉ số tốt hơn việc chỉ nhìn kết quả thuận lợi ban đầu. Thêm bản gửi (105, 2). Nhóm south vẫn phải có ba người được mời, nhưng số biểu mẫu tăng thành ba, số người có điểm thành hai, điểm trung bình thành một và tỷ lệ có điểm thành hai phần ba. Tiếp theo, đổi điểm của người 104 từ không sang NULL. Số lời mời vẫn phải là ba; điểm trung bình thành hai vì chỉ người 105 còn cung cấp điểm. Bắt đầu từ một bản dữ liệu gốc mới, thực hiện hai thay đổi liên tiếp theo thứ tự trên cùng bản đó, rồi tạo lại dữ liệu gốc trước khi làm lại bài tập.
Nếu những thay đổi này làm số người được mời thay đổi, truy vấn đang trộn điều kiện chọn tập đối tượng với sự có mặt của câu trả lời. Nếu số người có điểm lớn hơn số được mời, hãy kiểm tra bản gửi trùng hoặc phép nối xác định điều kiện tham gia trước khi giới hạn phần trăm trên giao diện. Chặn tỷ lệ ở 100% chỉ che một quan hệ sai, trong khi điểm trung bình và so sánh giữa các nhóm vẫn có thể sai.
Giá trị thiếu vẫn cần được giải thích
SQL có thể phát hiện NULL nhưng không giải thích được vì sao nó xuất hiện. Bỏ qua câu hỏi, lỗi phân tích dữ liệu, xóa theo yêu cầu riêng tư và trường chưa tồn tại trong phiên bản lược đồ cũ đều có thể trở thành NULL. Nếu lý do ảnh hưởng đến cách diễn giải, hãy giữ một cột lý do hoặc bản ghi kiểm tra quá trình nhập dữ liệu riêng.
Giới hạn này đặc biệt quan trọng khi so sánh các nhóm. Trung bình tính từ vài người sẵn lòng trả lời chưa chắc đại diện cho mọi người được mời. Đếm đúng số giá trị khác NULL xác định cỡ mẫu đã quan sát; nó không chứng minh tính đại diện của mẫu. Điền giá trị thiếu cần một lập luận thống kê riêng và phải được nhận diện rõ trong dữ liệu cũng như báo cáo.
Trước khi áp dụng cho khảo sát lớn hơn, hãy giữ cả nhóm toàn NULL lẫn nhóm rỗng trong bộ kiểm tra. Nhóm đầu có người tham gia nhưng chưa có điểm trung bình quan sát được; nhóm sau hoàn toàn không có người tham gia. Nhãn biểu đồ cần thể hiện sự khác biệt này để không biến một phép đo bị thiếu thành điểm 0, hoặc biến một tập đối tượng không tồn tại thành tỷ lệ phản hồi gây hiểu nhầm.