Quan sát Deployment thay Pod mà không đổi trạng thái mong muốn
Chạy thử nghiệm xóa Pod trong Kubernetes cục bộ, so sánh UID chủ sở hữu, replica mong muốn, Ready và minReadySeconds rồi dọn cụm thử nghiệm.
Xóa một Pod không thay đổi yêu cầu có ba replica của Deployment. Pod bị mất được thay thế vì controller vẫn còn công việc phải làm. Bản thay thế có danh tính mới, và việc nó đã tồn tại không có nghĩa nó đã sẵn sàng nhận lưu lượng.
Bài viết dành cho lập trình viên đang học vận hành workload trên Kubernetes. Bạn cần biết cơ bản về container và dòng lệnh. Ta chạy một cụm một node thực sự tại máy cục bộ, xóa một Pod do controller quản lý, kiểm tra bản thay thế rồi đổi số replica mong muốn. Thử nghiệm cố ý tách số replica đã tạo, ready và available bằng readiness probe kiểm tra một tệp. Đây là bài thực hành control plane, không phải kiểm thử tải ứng dụng hay phép đo độ sẵn sàng trên đám mây.
Theo dõi chuỗi chủ sở hữu
Deployment quản lý ReplicaSet. ReplicaSet tạo hoặc xóa Pod để tiến đến số lượng được yêu cầu, dựa trên selector và mẫu Pod. Kubelet trên node quản lý container bên trong từng Pod. Việc chia trách nhiệm như vậy giải thích vì sao xóa Pod và khởi động lại container là hai sự kiện khác nhau.
Hãy xem owner reference thực tế thay vì suy luận quyền sở hữu từ tên gần giống nhau. Pod được quản lý trỏ đến UID của ReplicaSet; ReplicaSet đó trỏ đến UID của Deployment. Thử nghiệm cục bộ kiểm tra cả hai liên kết. Nó cũng kiểm tra rằng UID của ReplicaSet không đổi sau khi xóa Pod. Không có mẫu ứng dụng mới được đưa vào, nên lần thay thế này không phải một rollout ứng dụng.
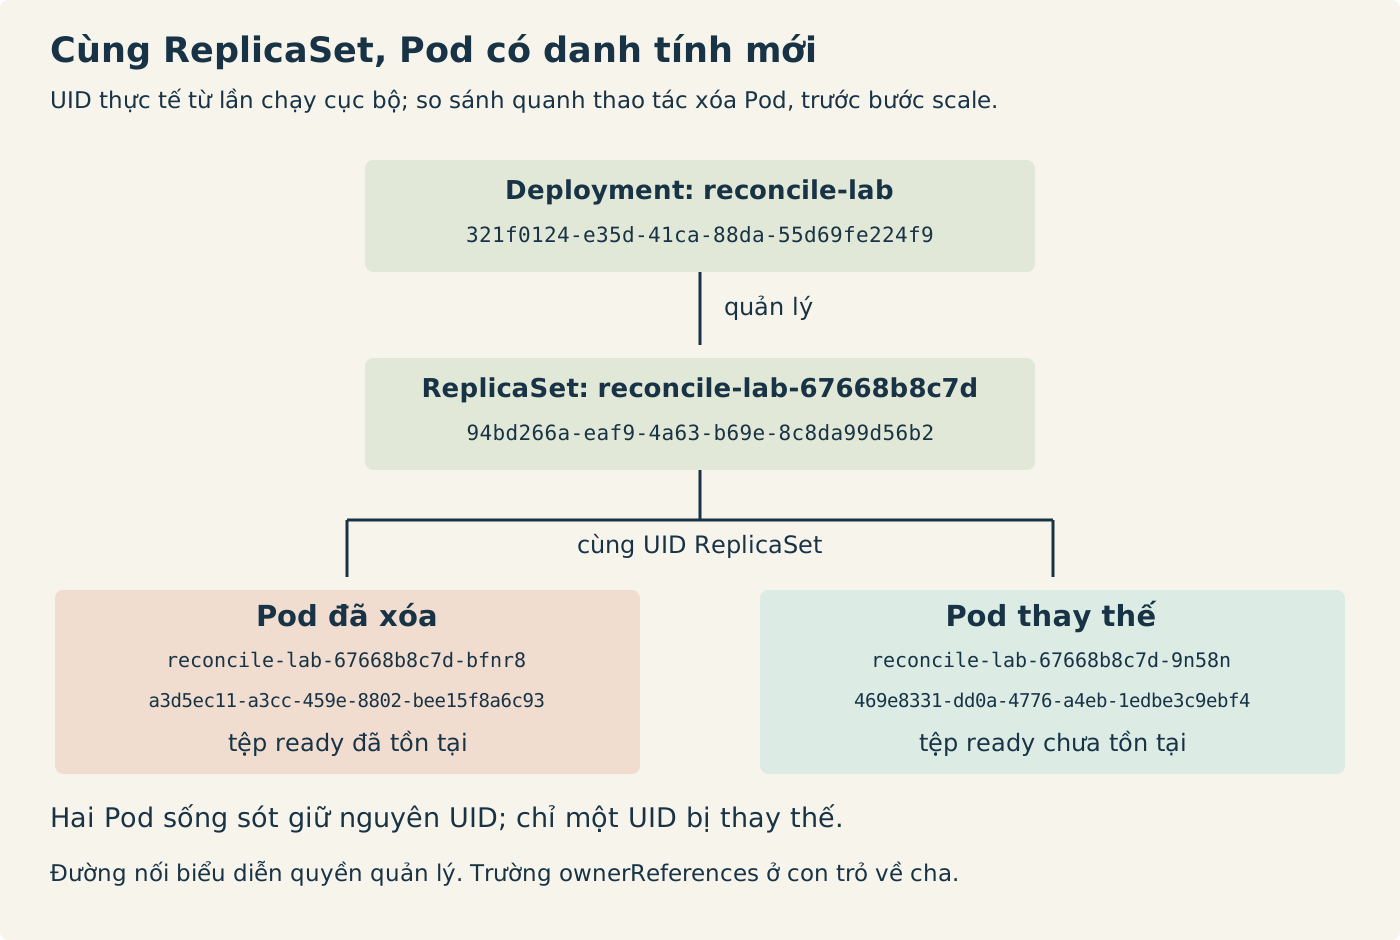
Kubernetes định nghĩa danh tính Pod bằng UID. Bản thay thế là Pod khác, ngay cả khi một workload có thể dùng lại tên. Trong ví dụ này tên cũng đổi, nhưng phép kiểm tra dùng UID. Hệ thống tệp của container thay thế không kế thừa tệp đánh dấu readiness đã ghi vào container bị xóa. Quan sát này chỉ nói về tệp tạm đó; nó không kết luận gì về khôi phục từ một persistent volume được cấp riêng.
Đặt bốn câu hỏi khác nhau
Số lượng mong muốn nằm trong đặc tả Deployment. Các số lượng còn lại là trạng thái do controller báo. Với API Kubernetes 1.34 được thử nghiệm, định nghĩa trường theo phiên bản phân biệt các Pod thuộc phạm vi quản lý chưa trong quá trình kết thúc, những Pod có điều kiện Ready, và những Pod đã ready đủ lâu để được tính là available.
Vì vậy, số replica hiện có không đồng nghĩa số worker ứng dụng khỏe mạnh. Pod có thể tồn tại khi còn đợi được xếp lịch hoặc khởi động. Thử nghiệm này chờ thêm để các Pod được chọn đạt phase Running, nhờ đó có thể điều khiển probe thực thi lệnh. Điều kiện bổ sung đó thuộc bài kiểm tra, không phải định nghĩa số replica của Deployment.
Ready và available khác nhau vì manifest đặt thời gian ready tối thiểu là mười lăm giây. Pod vừa ready phải đáp ứng khoảng thời gian đó mà không có container crash trước khi được tính là available. Mặc định là 0, nên một ví dụ ngắn có thể che mất sự khác biệt. Không số lượng nào chứng minh giao dịch nghiệp vụ thành công; probe này chỉ kiểm tra một tệp.
Tạo workload có thể điều khiển readiness
Lưu nội dung sau thành deployment.yaml. Nó yêu cầu ba container đang ngủ và đánh dấu từng container chưa ready cho đến khi /tmp/ready tồn tại. Không có liveness probe. Vì thế, readiness check thất bại không yêu cầu kubelet khởi động lại container. Giới hạn bộ nhớ và request nhỏ giúp giới hạn phạm vi ví dụ cục bộ; đây không phải lời khuyên cấp tài nguyên production.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: reconcile-lab
spec:
  replicas: 3
  minReadySeconds: 15
  selector:
    matchLabels:
      app: reconcile-lab
  template:
    metadata:
      labels:
        app: reconcile-lab
    spec:
      terminationGracePeriodSeconds: 1
      containers:
        - name: sleeper
          image: busybox:1.37.0
          imagePullPolicy: Never
          command: ["sleep", "3600"]
          readinessProbe:
            exec:
              command: ["test", "-f", "/tmp/ready"]
            periodSeconds: 1
            failureThreshold: 1
          resources:
            requests:
              cpu: 10m
              memory: 8Mi
            limits:
              memory: 32Mi
Nhãn trong selector khớp nhãn trong mẫu Pod. Giữ selector của thử nghiệm tách khỏi controller khác. Tài liệu Kubernetes cảnh báo selector chồng lấn giữa các controller có thể gây xung đột; chỉ có nhãn khớp không phải lý do để ghép một Pod không liên quan vào workload này.
Ví dụ dùng Docker, kind 0.30.0 và kubectl 1.34.1 trên Linux. Bản phát hành kind cung cấp node image Kubernetes 1.34.0 đã được ghim trong chương trình. Cài các công cụ đó, rồi chuẩn bị đúng image BusyBox và chạy thử nghiệm trong thư mục chứa hai tệp:
docker pull busybox:1.37.0@sha256:9db7b59979c38555a39def84a31fb98b5296952f9e3afd4f6f11f05b07adfab0
docker tag busybox@sha256:9db7b59979c38555a39def84a31fb98b5296952f9e3afd4f6f11f05b07adfab0 busybox:1.37.0
python3 -I experiment.py
Tag chỉ được dùng sau khi kiểm tra repository digest mong đợi. Workload đặt chính sách kéo image là Never vì chương trình chủ động nạp image vào node cục bộ. Nếu thiếu bước nạp, lỗi phải hiện rõ; không nên âm thầm tải một image khác trong lúc quan sát.
Chạy chuỗi thao tác có kiểm soát
Lưu nội dung sau thành experiment.py. Nó tạo cụm kind có tên riêng ngẫu nhiên và kubeconfig riêng. Mọi lệnh kubectl đều chỉ rõ tệp đó cùng context đã tạo. Bước dọn dẹp dùng cùng kubeconfig và xóa cụm do chương trình tạo ngay cả khi assertion thất bại. Tệp đầu ra cục bộ là observations.json, chứa các bản ghi trạng thái thô và danh tính.
import json
import os
from pathlib import Path
import subprocess
import tempfile
import time
import uuid

NODE = 'kindest/node:v1.34.0@sha256:7416a61b42b1662ca6ca89f02028ac133a309a2a30ba309614e8ec94d976dc5a'
BUSYBOX_DIGEST = 'busybox@sha256:9db7b59979c38555a39def84a31fb98b5296952f9e3afd4f6f11f05b07adfab0'
kind = os.environ.get('DEVOPS_KIND', 'kind')
cluster = 'reconcile-' + uuid.uuid4().hex[:10]
manifest = Path(__file__).with_name('deployment.yaml')
output = Path(__file__).with_name('observations.json')
records = []

def run(args, timeout=45):
    result = subprocess.run(args, text=True, capture_output=True, timeout=timeout)
    if result.returncode:
        raise RuntimeError(f'{args!r}\n{result.stdout}\n{result.stderr}')
    return result.stdout

image = json.loads(run(['docker', 'image', 'inspect', 'busybox:1.37.0']))[0]
assert BUSYBOX_DIGEST in image['RepoDigests'], 'Pull the stated BusyBox image first'
with tempfile.TemporaryDirectory(prefix='devops-reconcile-') as directory:
    kubeconfig = str(Path(directory) / 'config')
    base = ['kubectl', '--kubeconfig', kubeconfig, '--context', 'kind-' + cluster]
    def k(*args):
        return run(base + list(args))
    def get(*args):
        return json.loads(k('get', *args, '-o', 'json'))
    def wait_state(label, desired, ready, available):
        deadline = time.monotonic() + 120
        while time.monotonic() < deadline:
            d = get('deployment', 'reconcile-lab')
            pods = get('pods', '-l', 'app=reconcile-lab')
            active = [p for p in pods['items'] if not p['metadata'].get('deletionTimestamp')]
            s = d.get('status', {})
            observed = (d['spec']['replicas'], s.get('replicas', 0), s.get('readyReplicas', 0), s.get('availableReplicas', 0))
            running = all(p.get('status', {}).get('phase') == 'Running' for p in active)
            if (observed == (desired, desired, ready, available) and
                    len(active) == desired and running and
                    s.get('observedGeneration') == d['metadata']['generation']):
                row = {'label': label, 'elapsedSeconds': round(time.monotonic() - observe_start, 3),
                       'counts': observed, 'deployment': d,
                       'pods': pods, 'replicasets': get('replicasets', '-l', 'app=reconcile-lab')}
                records.append(row)
                print(label, 'desired/current/ready/available', *observed, flush=True)
                return row
            time.sleep(0.3)
        raise TimeoutError(f'{label}: expected state not observed')
    try:
        run([kind, 'create', 'cluster', '--name', cluster, '--kubeconfig', kubeconfig,
             '--image', NODE, '--wait', '120s'], timeout=210)
        run([kind, 'load', 'docker-image', 'busybox:1.37.0', '--name', cluster], timeout=90)
        versions = json.loads(k('version', '-o', 'json'))
        observe_start = time.monotonic()
        k('apply', '-f', str(manifest))
        blocked = wait_state('created-not-ready', 3, 0, 0)
        for p in blocked['pods']['items']:
            k('exec', p['metadata']['name'], '--', 'touch', '/tmp/ready')
        before = wait_state('baseline', 3, 3, 3)
        old = before['pods']['items']
        old_uids = {p['metadata']['uid'] for p in old}
        victim = sorted(old, key=lambda p: p['metadata']['name'])[0]
        k('delete', 'pod', victim['metadata']['name'], '--wait=true', '--timeout=45s')
        replaced = wait_state('replacement-not-ready', 3, 2, 2)
        new = [p for p in replaced['pods']['items'] if p['metadata']['uid'] not in old_uids]
        assert len(new) == 1
        replacement = new[0]
        assert victim['metadata']['uid'] not in {p['metadata']['uid'] for p in replaced['pods']['items']}
        old_rs = before['replicasets']['items'][0]
        new_rs = replaced['replicasets']['items'][0]
        assert len(before['replicasets']['items']) == len(replaced['replicasets']['items']) == 1
        assert old_rs['metadata']['uid'] == new_rs['metadata']['uid']
        assert replacement['metadata']['ownerReferences'][0]['uid'] == old_rs['metadata']['uid']
        assert old_rs['metadata']['ownerReferences'][0]['uid'] == before['deployment']['metadata']['uid']
        assert before['deployment']['metadata']['generation'] == replaced['deployment']['metadata']['generation']
        k('exec', replacement['metadata']['name'], '--', 'test', '!', '-e', '/tmp/ready')
        k('exec', replacement['metadata']['name'], '--', 'touch', '/tmp/ready')
        wait_state('ready-before-available', 3, 3, 2)
        wait_state('recovered', 3, 3, 3)
        k('scale', 'deployment/reconcile-lab', '--replicas=0')
        scaled = wait_state('desired-zero', 0, 0, 0)
        assert scaled['deployment']['metadata']['generation'] > before['deployment']['metadata']['generation']
        assert scaled['replicasets']['items'][0]['metadata']['uid'] == old_rs['metadata']['uid']
        evidence = {'scope': 'Actual single-node local kind control-plane experiment; no cloud deployment or service-traffic measurement.',
                    'versions': versions, 'kindVersion': run([kind, 'version']).strip(),
                    'nodeImage': NODE, 'busyboxImageId': image['Id'],
                    'victimUid': victim['metadata']['uid'], 'replacementUid': replacement['metadata']['uid'],
                    'replicaSetUid': old_rs['metadata']['uid'], 'replacementReadyFileMissing': True,
                    'records': records}
    finally:
        run([kind, 'delete', 'cluster', '--name', cluster, '--kubeconfig', kubeconfig], timeout=90)
        remaining = run(['docker', 'ps', '-a', '--filter', 'name=' + cluster, '--format', '{{.ID}}']).strip()
        assert not remaining, 'Owned kind node still exists'
    evidence['ownedClusterDeleted'] = True
    output.write_text(json.dumps(evidence, indent=2) + '\n')
    print('same ReplicaSet; different Pod UID; owned cluster deleted', flush=True)
Các giới hạn polling là thời hạn của bài kiểm tra, không phải bảo đảm của Kubernetes. Chương trình chờ những tổ hợp trạng thái cụ thể và kiểm tra controller đã quan sát generation hiện tại. Một hạn chế của phép quan sát là Deployment, Pod và ReplicaSet được đọc qua các lần gọi API riêng, nên bản ghi lưu lại không phải một snapshot nguyên tử trên nhiều tài nguyên. Các giai đoạn ổn định được điều khiển chủ động giúp kiểm tra dễ hơn, nhưng không khẳng định ghi lại mọi trạng thái trung gian.
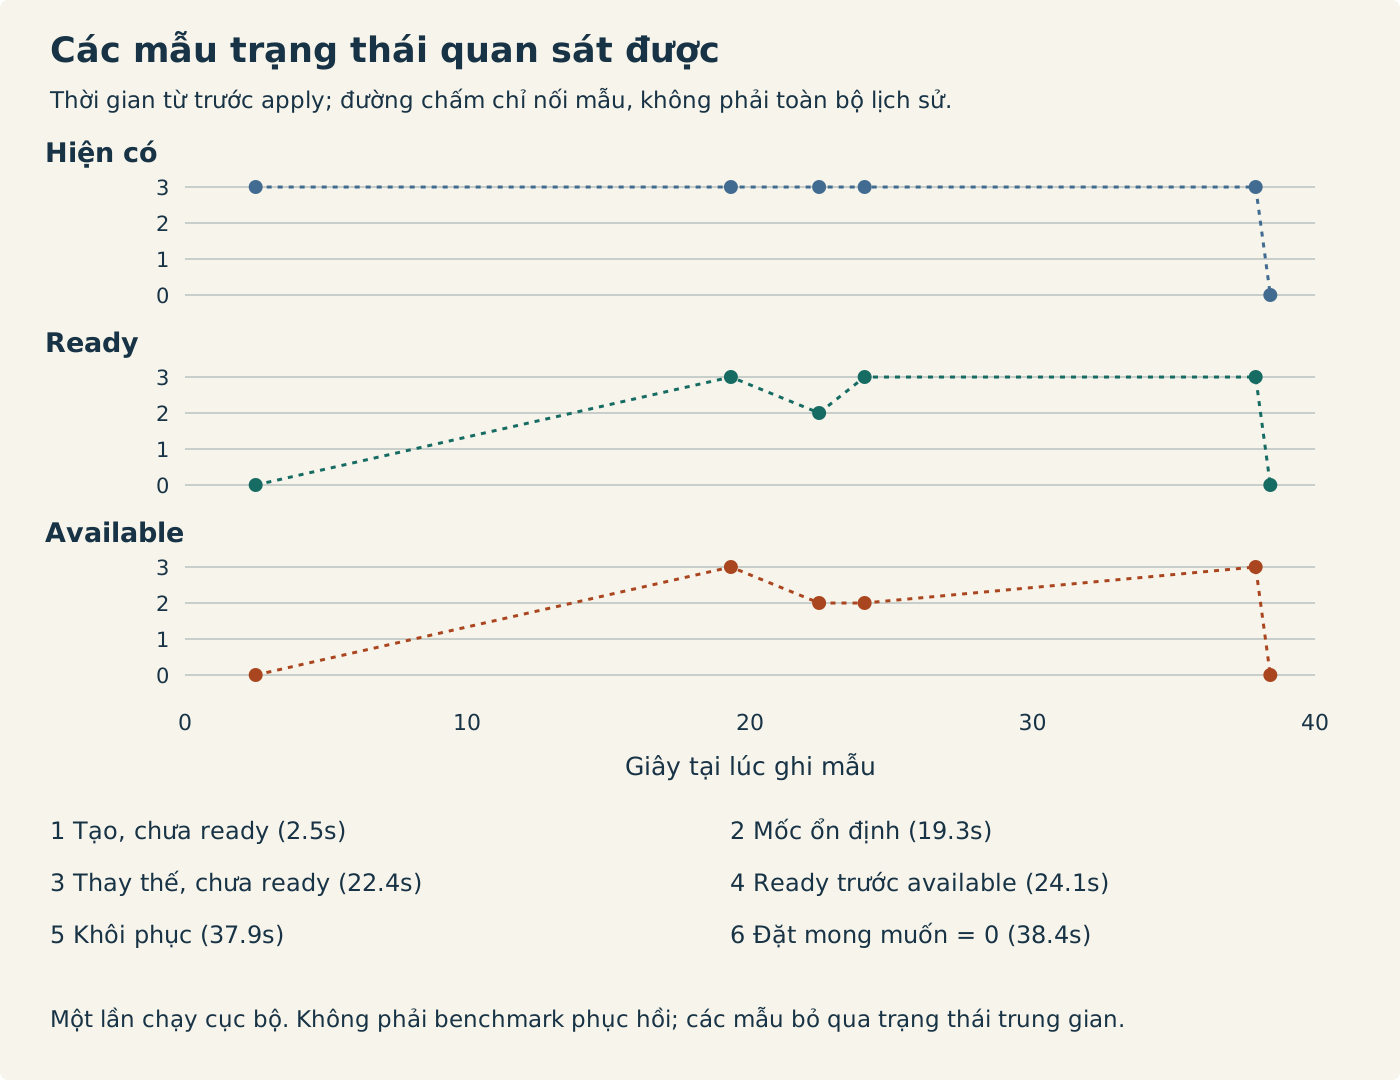
Sau khi tạo ban đầu, cả ba Pod đều tồn tại và chạy nhưng chưa Pod nào ready. Tạo từng tệp đánh dấu cho phép probe thành công; sau khoảng thời gian tối thiểu, cả ba trở thành available. Chương trình tiếp đó xóa đúng một Pod trong workload do nó quản lý. Nó không giảm số lượng mong muốn hay đổi mẫu Pod.
Tại giai đoạn được chọn tiếp theo, lại có ba Pod, nhưng chỉ hai Pod còn sống từ trước là ready và available. Controller có thể thay thế đối tượng nhanh đến mức polling không ghi được lúc số replica hiện có là hai. Thử nghiệm không tự thêm quan sát bị thiếu đó. Pod thay thế có UID mới và chưa có tệp đánh dấu, trong khi generation của Deployment và UID của ReplicaSet giữ nguyên.
Tạo tệp cho bản thay thế tạo ra giai đoạn có ba replica ready nhưng chỉ hai available. Giai đoạn sau trở về ba available. Thời điểm trên đồ thị bao gồm ảnh hưởng của khởi động cục bộ, probe và polling API; đó là quan sát của một lần chạy, không phải benchmark thời gian phục hồi hay lời hứa rằng máy khác đạt từng trạng thái ở cùng một giây.
Đổi trạng thái mong muốn khi cần kết quả ổn định khác
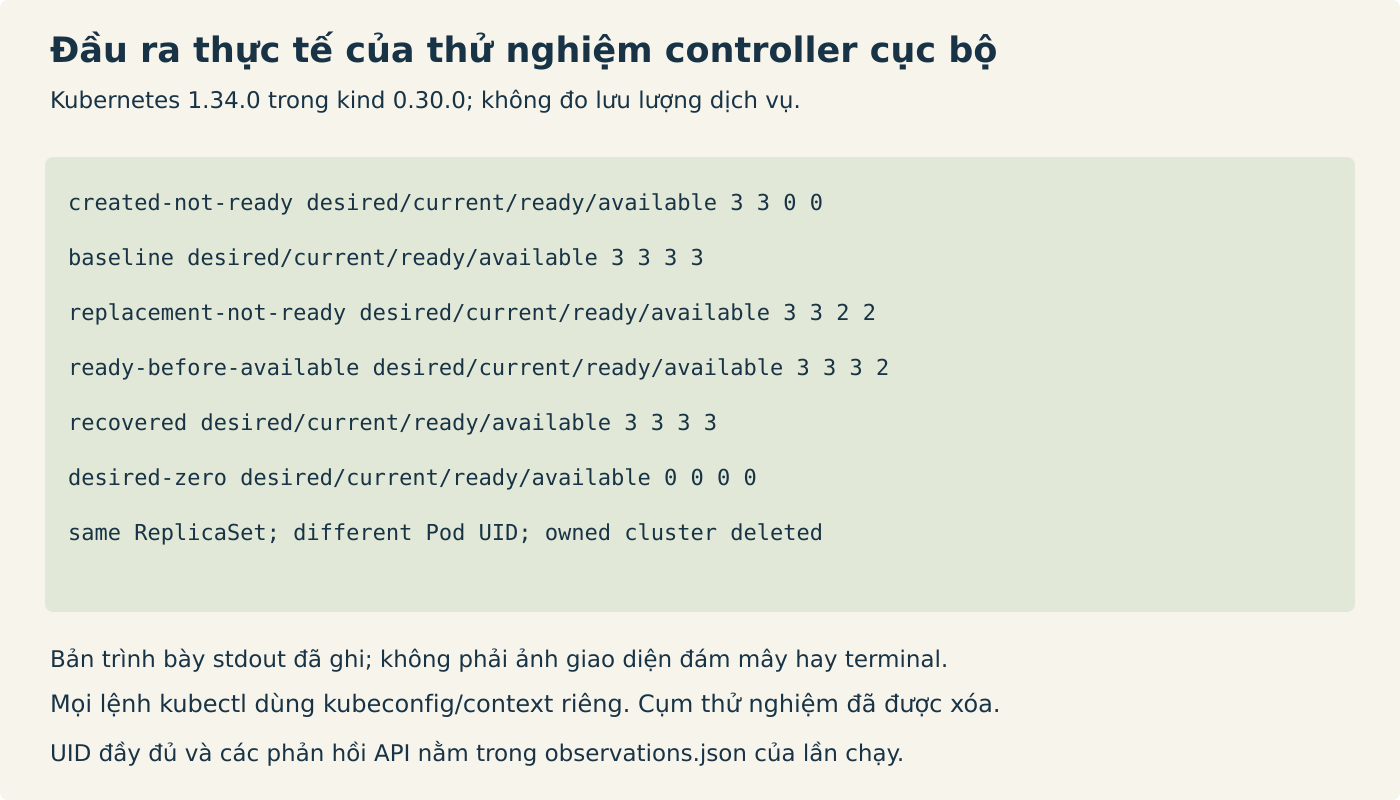
Xóa Pod do controller quản lý hữu ích trong thử nghiệm giới hạn này, nhưng không phải cách giảm số replica lâu dài. Lệnh cuối đổi đặc tả Deployment thành 0 replica. Controller khi đó tiến đến 0 thay vì tạo thêm bản thay thế. Generation tăng, còn cùng ReplicaSet được giữ lại trong ví dụ không đổi mẫu này. Trong cả hai lần chạy đã ghi, mẫu có số lượng bằng 0 vẫn liệt kê ba Pod có dấu thời gian xóa. Chúng đang kết thúc nên bị loại khỏi số hiện có. Trạng thái đếm bằng 0 không chứng minh mọi tiến trình cũ đã thoát.
Rollout có tác nhân khác: thay đổi mẫu Pod trong Deployment tạo rollout mới. Chỉ thay đổi số replica thì không. Ngược lại, rollout strategy được chọn cũng không phải khóa bảo đảm “tối đa ba tiến trình” khi tùy ý xóa Pod. Kubernetes nêu rõ Pod thay thế có thể bắt đầu khi Pod cũ còn đang kết thúc. Khoảng chờ kết thúc một giây và các mẫu được chọn của ví dụ không xác lập thứ tự phổ quát giữa việc tiến trình cũ thoát và tiến trình mới bắt đầu.
Quá trình đối soát trạng thái cũng cần điều kiện. Thiếu image, không đủ tài nguyên xếp lịch, thao tác API bị từ chối hoặc node không dùng được có thể khiến số hiện có, ready và available thấp hơn yêu cầu. Controller có thể thử lại mà không làm ứng dụng khỏe lên. Vì thế, số lượng mong muốn là mục tiêu để đối chiếu khi chẩn đoán, không phải bằng chứng rằng mọi replica đã tồn tại hoặc người dùng đang được phục vụ.
Để thử thêm trong phạm vi nhỏ, đổi minReadySeconds thành 0 và chạy một cụm cục bộ mới. Sửa chương trình để chờ ba ready và ba available cùng lúc, thay vì bắt buộc mẫu trung gian ba ready nhưng hai available; khi đặt 0, mẫu đó không còn là trạng thái bắt buộc. Giữ nguyên kiểm tra UID và owner reference. Bài tập thứ hai là bỏ thao tác tạo tệp đánh dấu, rồi quan sát readiness thất bại cho đến một thời hạn hữu hạn. Giải thích vì sao bản thân ba Pod chưa ready không yêu cầu tạo thêm ba replica. Dừng cụm do thử nghiệm tạo sau mỗi lần, như chương trình được cung cấp đã làm.