Thứ tự byte không đổi trọng số bit trong số nguyên
Đặt byte tại địa chỉ cụ thể, giải mã header trộn thứ tự và kiểm tra độ dài bằng vector độc lập với kiểm tra khứ hồi.
Endianness quy định thứ tự byte dùng để lưu giá trị nhiều byte. Nó không đảo trọng số các bit bên trong số nguyên. Nếu bạn đang đọc tệp nhị phân hoặc thông điệp mạng, câu hỏi hữu ích là byte nào nằm ở địa chỉ thấp nhất và bộ phân tích dựng lại giá trị như thế nào.
Lấy số nguyên không dấu 32 bit 0x12345678. Byte cao nhất là 0x12, còn byte thấp nhất là 0x78. Với little-endian, byte thấp đi trước khi địa chỉ tăng dần. Với big-endian, byte cao đi trước.
Đặt bốn byte tại địa chỉ cụ thể
Giả sử giá trị bắt đầu ở địa chỉ 0x1000. Địa chỉ này chỉ byte đầu, bất kể số nguyên dùng thứ tự byte nào.
| Địa chỉ | Byte little-endian | Byte big-endian |
|---|---|---|
| 0x1000 | 0x78 | 0x12 |
| 0x1001 | 0x56 | 0x34 |
| 0x1002 | 0x34 | 0x56 |
| 0x1003 | 0x12 | 0x78 |
Bản xem byte liệt kê các vị trí lưu trữ. Trình gỡ lỗi hiển thị giá trị có kiểu 32 bit có thể diễn giải các byte trước rồi mới in số. Hai cách xem vì vậy có thể trông đảo nhau dù cùng mô tả bộ nhớ đúng.
Đặc tả bộ nhớ RV32I bàn về bộ nhớ định địa chỉ theo byte và thứ tự byte. Sự phân biệt giữa truy cập byte với truy cập rộng hơn hữu ích ở đây: tải một byte không cần sắp nhiều byte, còn tải từ thì có.
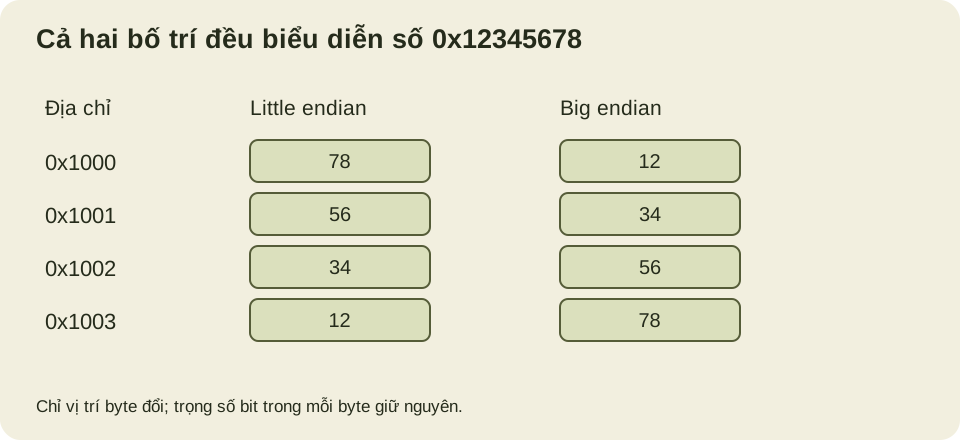
Các bit trong byte 0x78 vẫn là 01111000 ở cả hai cột. Thứ tự truyền bit trên đường nối tiếp là thuộc tính giao thức khác và phải quy định riêng. Gọi cả hai chung là endianness mà không giải thích có thể che mất phép biến đổi thực sự cần làm.
Dựng lại số từ các byte
Với các byte little-endian b0 đến b3, tính b0 + 256*b1 + 65536*b2 + 16777216*b3. Mỗi byte sau đóng góp vào vị trí có trọng số cao hơn. Dựng big-endian gán các lũy thừa ấy theo thứ tự ngược lại.
little = bytes([0x78, 0x56, 0x34, 0x12])
big = bytes([0x12, 0x34, 0x56, 0x78])
assert int.from_bytes(little, "little") == 0x12345678
assert int.from_bytes(big, "big") == 0x12345678
wrong = int.from_bytes(little, "big")
assert wrong == 0x78563412
manual = sum(byte << (8 * i) for i, byte in enumerate(little))
assert manual == 0x12345678
Kết quả sai thứ tự vẫn là số nguyên 32 bit hợp lệ. Bộ phân tích có thể không sập mà hiểu một độ dài nhỏ thành yêu cầu cấp phát khổng lồ, chọn loại thông điệp lạ hoặc chỉ từ chối checksum ở bước sau. Kiểm tra mẫu dễ nhận biết ngay gần ranh giới giải mã giúp tìm lỗi dễ hơn.
Giá trị toàn bit không hoặc toàn bit một là ca kiểm tra thứ tự byte kém vì đảo vẫn giữ nguyên. Giá trị như 0x12345678 cho mỗi byte vị trí khác nhau. Cũng cần giá trị biên thực tế: đúng trên mẫu đẹp mắt chưa xác lập xử lý miền giá trị đúng.
Để giao thức quyết định thứ tự
Thứ tự byte của gói mạng đến từ đặc tả, không từ CPU nhận gói. RFC 768 bố trí các trường độ rộng cố định của header UDP; cách hiện thực diễn giải trường giao thức Internet theo biểu diễn trên đường truyền đã quy định. Máy chạy chương trình có thể cần chuyển giữa biểu diễn đó và bố trí số nguyên bản địa.
Bộ phân tích dễ chuyển nền tảng có thể giải mã tường minh từ byte. Trong JavaScript, DataView có tham số thứ tự byte cho phép đọc nhiều byte. Trong Python, int.from_bytes nhận tham số thứ tự byte tường minh; nên truyền để ghi rõ định dạng thay vì dựa vào mặc định. Các giao diện này làm giả định dễ thấy khi rà soát. Cách xem mảng có kiểu bản địa hoặc ép con trỏ thô có thể kế thừa biểu diễn của máy chạy chương trình.
Bộ phân tích còn cần kiểm tra độ dài trước khi đọc byte. Logic thứ tự byte đúng không làm header bị cắt ngắn có đủ bốn byte. Hãy coi kiểm tra biên, độ rộng, dấu và thứ tự byte là các mục riêng của hợp đồng giải mã. Chúng có thể sai độc lập.
Giải mã từng trường của header trộn thứ tự
Một định dạng có thể gán quy tắc byte khác nhau cho từng trường. Xét header tám byte giả định: một byte phiên bản, một byte cờ, độ dài dữ liệu hai byte big-endian và định danh bốn byte little-endian. Định dạng được cố ý trộn để làm rõ ranh giới trường; nó không phải header UDP hay đề xuất thay giao thức hiện có.
Với phiên bản một, cờ 0xA5, độ dài dữ liệu 512 và định danh 0x12345678, các byte header là 01 A5 02 00 78 56 34 12. Hai byte độ dài biểu diễn 512 vì 0x02 ở byte cao. Byte đầu của trường định danh là 0x78 vì trường đó dùng little-endian. Đảo toàn bộ header sẽ làm lộn vị trí trường cùng cả byte phiên bản và cờ đơn lẻ.
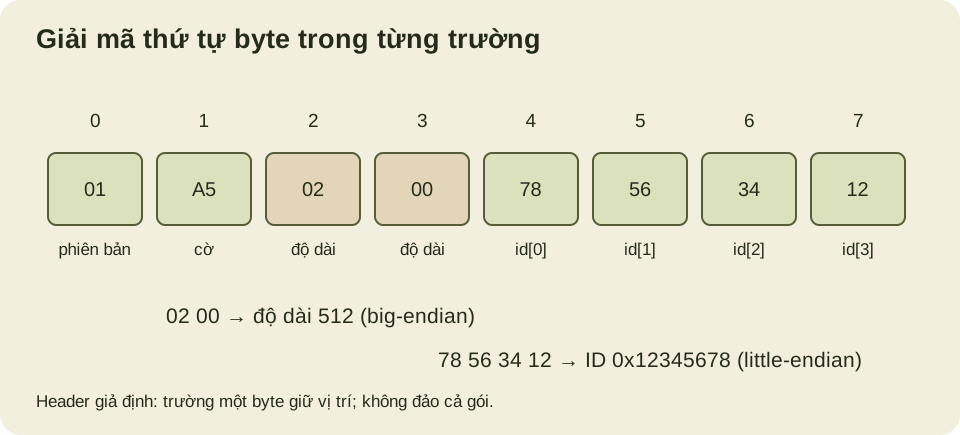
Bộ phân tích dưới chỉ nhận đúng một gói hoàn chỉnh. Nó từ chối header ngắn trước khi cắt trường, rồi kiểm tra phiên bản hỗ trợ và độ dài dữ liệu khai báo với toàn gói được truyền vào. Bộ phân tích luồng có thể đệm gói chưa đủ hoặc trả số byte đã dùng, nhưng đó là giao diện khác cần hợp đồng riêng.
def parse_packet(packet):
    if len(packet) < 8:
        raise ValueError("short header")
    if packet[0] != 1:
        raise ValueError("unsupported version")
    length = int.from_bytes(packet[2:4], "big")
    identifier = int.from_bytes(packet[4:8], "little")
    if len(packet) != 8 + length:
        raise ValueError("payload length mismatch")
    return packet[1], identifier, packet[8:]

header = bytes.fromhex("01 a5 02 00 78 56 34 12")
payload = bytes(512)
assert parse_packet(header + payload) == (0xa5, 0x12345678, payload)
for malformed in (header[:7], header, header + payload + b"x"):
    try:
        parse_packet(malformed)
    except ValueError:
        pass
    else:
        raise AssertionError("malformed packet accepted")
assert int.from_bytes(header[2:4], "little") == 2

wrong_wire = (512).to_bytes(2, "little")
assert int.from_bytes(wrong_wire, "little") == 512
assert wrong_wire != header[2:4]
print("mixed-order packet, three length failures and false round trip checked")
Kiểm tra header ngắn là cần thiết dù thao tác cắt lát của Python tự chấp nhận lát thiếu. Không kiểm tra rõ, định danh bốn byte bị thiếu có thể được giải mã từ ít byte hơn và âm thầm nhận thành số khác. Ngôn ngữ gây lỗi khi phép đọc độ rộng cố định vượt biên thể hiện cùng vi phạm hợp đồng theo cách khác; bộ phân tích nên tự định nghĩa lỗi thay vì phụ thuộc vào tình cờ của hành vi API.
Ba dòng cuối cho thấy vì sao kiểm tra đi rồi về chưa đủ. Bộ mã hóa little-endian sai và bộ giải mã khớp nó cùng thu lại 512, nhưng byte chúng tạo khác trường độ dài big-endian đã khai báo. Vector byte đã biết cung cấp bằng chứng độc lập với giả định chung của hai hàm. Giữ vector đó khi chuyển bộ phân tích sang ngôn ngữ khác và so mọi trường trước khi đo hiệu năng cách hiện thực nhanh hơn.
Để mở rộng, thêm độ dài dữ liệu tối đa chấp nhận trước khi cấp phát hoặc sao chép. Kiểm tra giá trị lớn nhất được nhận, giá trị kế tiếp, gói ngắn và một byte thừa cuối. Sau đó quyết định bit cờ chưa biết được giữ, bỏ qua hay từ chối. Những lựa chọn đó mở rộng hợp đồng định dạng; chỉ đổi thứ tự byte không trả lời được chúng.
Đừng dùng ép con trỏ làm bộ phân tích
Trong C hoặc C++, ép địa chỉ vùng đệm byte sang con trỏ số nguyên rộng hơn có thể thêm vấn đề căn chỉnh và mô hình đối tượng ngoài thứ tự byte bản địa. Truy cập không căn chỉnh tình cờ chạy trên một CPU không giải quyết quy tắc ngôn ngữ hay khả năng chuyển sang đích khác.
Ghép byte tường minh hoặc dùng hàm thư viện phù hợp dễ suy luận hơn. Sao chép byte vào số nguyên bằng thao tác được phép giải quyết một phần vấn đề truy cập đối tượng, nhưng số nguyên nhận được vẫn phản ánh thứ tự byte của máy nếu chưa chuyển đổi. Một bước đúng không âm thầm làm mọi bước cần thiết.
Cấu trúc packed có giới hạn tương tự. Bỏ phần đệm không tự định nghĩa thứ tự byte của từng trường nguyên, và biểu diễn cấu trúc vẫn có thể phụ thuộc phần mở rộng trình biên dịch hoặc quy tắc ABI. Định dạng nhị phân cần biểu diễn ổn định qua trình biên dịch và kiến trúc khác.
Giữ đổi byte ở ranh giới
Khi bộ phân tích đã đổi trường thành số nguyên thông thường của ngôn ngữ lập trình đang dùng, phép tính nên dùng số đó bình thường. Liên tục đảo byte trước số học rồi đảo lại làm trách nhiệm quản lý biểu diễn khó theo dõi. Hãy xác định nơi byte thành giá trị và nơi giá trị thành byte.
Chẳng hạn, ứng dụng giữ độ dài gói như số nguyên 512 bên trong. Mã hóa trường đó ghi 00 02 hoặc 02 00 tùy định dạng hai byte trên đường truyền. Bản thân số nguyên tham gia so biên không cần được gọi là little-endian.
Kiểm tra khứ hồi có ích: mã hóa giá trị, giải mã các byte nhận được và thu lại giá trị gốc trong miền cho phép. Nó cũng nên so byte mã hóa với đặc tả bên ngoài hoặc vector đã biết. Hai hàm dùng chung quy ước đảo sai có thể vượt kiểm tra khứ hồi nhưng không tương tác được với cách hiện thực nào khác.
Khi trường nhị phân trông vô lý, giữ các byte gốc trong thông tin chẩn đoán an toàn rồi xem một đường chuyển đổi. Ví dụ bốn byte thô, độ rộng đã khai báo và giá trị nguyên mong đợi là đủ bằng chứng để thử thứ tự byte mà không đoán theo thương hiệu máy hay ngôn ngữ lập trình.