Tính độ trễ đường tới hạn trong bộ cộng lan truyền bit nhớ
Tính độ trễ bộ cộng bốn bit với giả định rõ ràng, xét đầu vào đến muộn và giữ dữ liệu thẳng hàng khi chia đường ống.
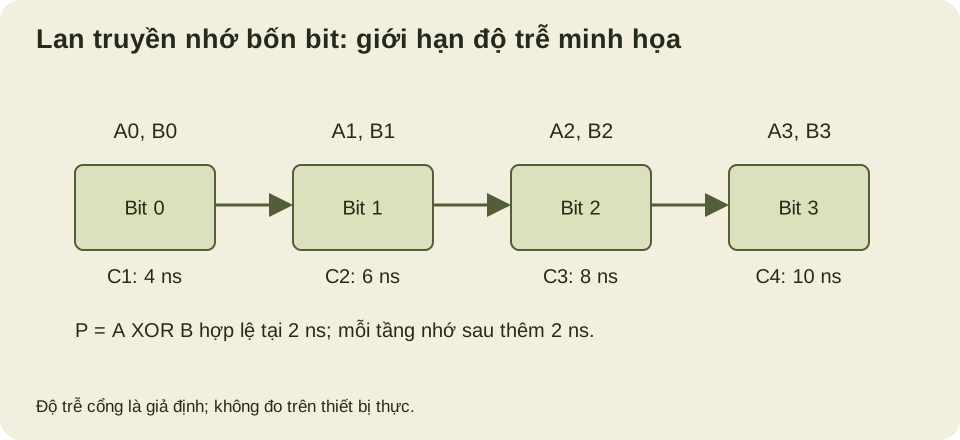
Bộ cộng lan truyền bit nhớ phải chờ bit nhớ đi qua lần lượt các vị trí bit. Vì vậy, đường tín hiệu chậm nhất liên quan đến phép cộng có thể dài thêm khi tăng độ rộng từ, dù lập trình viên chỉ thấy một lệnh cộng. Nếu bạn đang học cách liên hệ logic Boolean với định thời của bộ xử lý, ví dụ bốn bit giúp nhìn rõ độ trễ này mà không giả vờ mô tả một chip cụ thể.
Mọi độ trễ dưới đây đều là giả định. Chúng là các giới hạn được gán cho mô hình cổng đơn giản, không phải kết quả đo trên bo mạch hay số liệu từ thư viện phần tử tiêu chuẩn thương mại. Độ trễ thực tế phụ thuộc vào phần tử được chọn, tốc độ chuyển mức đầu vào, tải đầu ra, dây dẫn, điện áp và nhiệt độ.
Xác định quy tắc cho mỗi bộ cộng đầy đủ
Ở vị trí bit i, bộ cộng đầy đủ nhận hai bit toán hạng A, B và một bit nhớ vào. Nó tạo ra bit tổng và bit nhớ ra. Định nghĩa tín hiệu truyền nhớ là P = A XOR B và tín hiệu tạo nhớ là G = A AND B. Bit nhớ ra bằng G OR (P AND carry_in), còn bit tổng bằng P XOR carry_in.
Dùng các giả định định thời đơn giản sau. Mỗi cổng XOR có độ trễ lớn nhất hai nano giây. Mỗi cổng AND hoặc OR có độ trễ lớn nhất một nano giây. Hai toán hạng và bit nhớ ban đầu đều hợp lệ tại thời điểm không. Mô hình bỏ qua dây dẫn và cho phép các cổng tính đồng thời sau khi đầu vào của chúng hợp lệ.
Các tín hiệu truyền nhớ hợp lệ tại hai nano giây. Các tín hiệu tạo nhớ hợp lệ tại một nano giây. Với bit nhớ ra đầu tiên, nhánh AND giữa tín hiệu truyền nhớ và nhớ vào ổn định tại ba nano giây, rồi cổng OR cuối ổn định tại bốn nano giây. Những tầng tiếp theo nhận nhớ vào sau khi tín hiệu truyền nhớ cục bộ đã sẵn sàng.
| Tín hiệu | Thời điểm hợp lệ muộn nhất trong mô hình |
|---|---|
| P ở mọi bit | 2 ns |
| Nhớ vào bit 1 | 4 ns |
| Nhớ vào bit 2 | 6 ns |
| Nhớ vào bit 3 | 8 ns |
| Nhớ ra khỏi bit 3 | 10 ns |
| Tổng ở bit 0 | 4 ns |
| Tổng ở bit 3 | 10 ns |
Cách tính này dùng quy tắc: đầu ra cổng hợp lệ sau khi đầu vào liên quan đến muộn nhất đã hợp lệ, cộng thêm giới hạn độ trễ lan truyền của cổng. Tài liệu về mô hình số trình bày cách suy luận độ trễ lớn nhất theo đường tín hiệu trong mạch tổ hợp.
Theo dõi một đầu vào tạo ra bit nhớ
Xét 0111 + 0001. Ở bit không, cộng một với một tạo ra bit nhớ. Ở bit một và bit hai, mỗi vị trí có một bit toán hạng bằng một và bit còn lại bằng không, nên cả hai vị trí đều truyền bit nhớ đó. Kết quả là 1000.
Phép tính trên giấy có vẻ tức thời. Mạch vẫn cần thời gian để tín hiệu ổn định. Các đầu ra trung gian có thể tạm phản ánh bit nhớ cũ hoặc toán hạng cũ. Lấy mẫu tổng trước khi hết khoảng thời gian lan truyền đã quy định có thể thu được giá trị quá độ, dù hàm Boolean ổn định là đúng.
Cũng cần hiểu đúng ý nghĩa của giới hạn đường tín hiệu. Con số mười nano giây là giới hạn bảo thủ cho mạng cổng và mô hình độ trễ cụ thể này. Nó không chứng minh mọi phép cộng đều mất đúng mười nano giây để ổn định, cũng không chứng minh mọi đường trong cấu trúc đều tác động đến đầu ra trong mọi chuyển tiếp đầu vào. Phân tích định thời tĩnh chủ động đưa ra bảo đảm trên các điều kiện được phép, thay vì suy đoán từ một ví dụ thuận lợi.
Bạn có thể tái tạo giới hạn bằng một hệ thức lặp ngắn. Cho carry_time bắt đầu bằng không. Với mỗi bit, tính sum_time = max(2, carry_time) + 2, rồi tính thời điểm của nhớ ra bằng max(1, max(2, carry_time) + 1) + 1. Bốn thời điểm hợp lệ của tổng là 4, 6, 8 và 10 nano giây; thời điểm của các bit nhớ ra cũng theo dãy đó.
Tính lại khi một đầu vào đến muộn
Hệ thức lặp nên mô tả thời điểm đến của đầu vào, thay vì mặc định tất cả đều đến sớm như nhau. Ở mỗi bit, tạo tín hiệu truyền nhớ và tạo nhớ sau khi toán hạng đến muộn hơn đã có mặt. Sau đó, tại mỗi cổng tính tổng hoặc nhớ, chờ đầu vào đến muộn hơn. Đây là phép tính thời điểm hợp lệ, không phải mô phỏng dạng sóng nhị phân trung gian.
def ripple_bounds(a_times, b_times, carry_time=0):
    if not a_times or len(a_times) != len(b_times):
        raise ValueError("operand timing lists must have equal nonzero width")
    sums, carries = [], []
    for a_time, b_time in zip(a_times, b_times):
        operand_time = max(a_time, b_time)
        propagate = operand_time + 2
        generate = operand_time + 1
        sums.append(max(propagate, carry_time) + 2)
        carry_time = max(generate, max(propagate, carry_time) + 1) + 1
        carries.append(carry_time)
    return sums, carries

assert ripple_bounds([0]*4, [0]*4) == ([4, 6, 8, 10], [4, 6, 8, 10])
assert ripple_bounds([0]*4, [0]*4, 3) == ([5, 7, 9, 11], [5, 7, 9, 11])
assert ripple_bounds([0, 0, 0, 9], [0]*4) == ([4, 6, 8, 13], [4, 6, 8, 13])
print("3 arrival-time cases passed")
Trong trường hợp thứ hai, nhớ vào ban đầu hợp lệ tại ba nano giây. Thời điểm của nhớ ra đầu tiên chuyển từ bốn lên năm, thay vì tăng đủ ba nano giây, vì phép tính ban đầu vốn đã chờ hai nano giây để có tín hiệu truyền nhớ. Các tầng lan truyền còn lại nhận thêm độ trễ một nano giây đó.
Trong trường hợp thứ ba, chỉ bit cao nhất của toán hạng A đến muộn, tại chín nano giây. Tín hiệu truyền nhớ của nó hợp lệ tại mười một và tín hiệu tạo nhớ tại mười nano giây. Nhớ vào vị trí này đã hợp lệ từ tám nano giây, nên đường toán hạng quyết định giới hạn mười ba nano giây cho cả tổng cuối và nhớ ra cuối. Chỉ đếm số tầng truyền nhớ sẽ bỏ sót điều kiện đầu vào đến muộn này.
Với N bit và mọi đầu vào hợp lệ tại thời điểm không, hệ thức cho giới hạn cuối là 2*N + 2 nano giây trong chính mô hình cổng này. Tầng đầu mất bốn nano giây, mỗi tầng tiếp theo thêm hai. Công thức đó không phải quy luật áp dụng độc lập với thiết bị: phần tử truyền nhớ chuyên dụng và cách phân rã khác có các đường định thời khác. Nó là kết quả gọn của những giả định mà bạn có thể kiểm tra và thay đổi.
Đặt thanh ghi trước và sau bộ cộng
Đường dữ liệu đồng bộ thường có một thanh ghi phát trước mạch tổ hợp và một thanh ghi nhận sau nó. Chu kỳ xung nhịp phải đủ cho độ trễ từ cạnh xung nhịp đến đầu ra của thanh ghi đầu, độ trễ đường dài nhất qua bộ cộng và thời gian thiết lập ở thanh ghi sau. Độ lệch xung nhịp và phần dự phòng cho bất định sẽ thay đổi ngân sách này.
Với một đường giả định không lệch xung nhịp, cho thanh ghi phát cần một nano giây để có đầu ra hợp lệ và thanh ghi nhận cần một nano giây thiết lập. Bộ cộng mười nano giây khi đó cần chu kỳ ít nhất mười hai nano giây trong mô hình lý tưởng. Lấy nghịch đảo cho khoảng 83,3 MHz. Đây là hệ quả số học của các giá trị đã gán, không phải dự đoán hiệu năng của phần cứng được sản xuất.
Chương về logic tuần tự giải thích vì sao độ trễ tổ hợp lớn nhất xuất hiện trong điều kiện thiết lập. Độ trễ nhỏ nhất có vai trò riêng đối với thời gian giữ. Làm bộ cộng nhanh hơn có thể tăng biên thiết lập nhưng khiến một đường ngắn khác khó đáp ứng điều kiện giữ hơn.
Chọn cách tổ chức bit nhớ khác
Cấu trúc nhìn trước bit nhớ hoặc cấu trúc tiền tố tính thông tin nhớ với mức song song cao hơn. Chúng có thể giảm số tầng logic của phép cộng rộng, nhưng cần thêm cổng và dây dẫn. Bố trí vật lý trở nên quan trọng khi tín hiệu đi qua vùng lớn hơn. Chỉ so số tầng Boolean sẽ bỏ qua tải đầu ra và độ trễ dây.
Chuỗi lan truyền nhớ vẫn có thể phù hợp với đường dữ liệu nhỏ hoặc thiết kế có ngân sách thời gian rộng rãi. FPGA còn có tài nguyên truyền nhớ chuyên dụng, nên mô hình đếm từng cổng có thể dự đoán kém cách triển khai trên thiết bị đó. Công cụ tổng hợp và định thời phải đánh giá kiến trúc thực sự có trên thiết bị được chọn.
Chia đường ống cũng là một lựa chọn, nhưng nó thay đổi thời điểm kết quả xuất hiện và cách bit nhớ đi qua ranh giới tầng. Cắt giữa bộ cộng đòi hỏi lưu bit nhớ trung gian và giữ các bit toán hạng còn lại đồng bộ với nó. Chèn thanh ghi vào các tín hiệu tùy ý mà không giữ những quan hệ đó sẽ làm thay đổi phép tính.
Ranh giới đường ống phải giữ đúng cặp đầu vào
Chia bộ cộng bốn bit sau hai bit thấp. Tầng đầu tính hai bit tổng thấp và bit nhớ C2. Thanh ghi đường ống phải giữ C2 cùng với hai nửa cao ban đầu của A, B và phần tổng thấp. Tầng thứ hai cộng hai nửa cao với bit nhớ đã lưu, đồng thời đưa phần tổng thấp tương ứng đến thanh ghi đầu ra cuối.
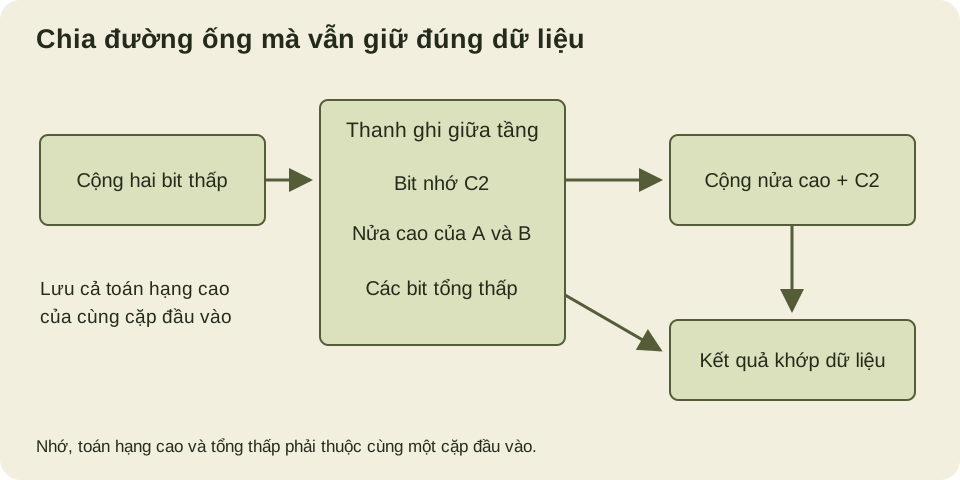
Theo giả định ban đầu, giới hạn tổ hợp cho hai bit là sáu nano giây. Thêm một nano giây trễ từ xung nhịp đến Q và một nano giây thiết lập cho chu kỳ minh họa tám nano giây ở mỗi tầng. Khi đường ống luôn có dữ liệu, nó có thể nhận một cặp đầu vào mỗi tám nano giây, so với mười hai nano giây của thiết kế một tầng. Kết quả cần hai chu kỳ, tức mười sáu nano giây, để đi từ cạnh phát đầu tiên đến cạnh nhận cuối. Thông lượng tăng, còn độ trễ của từng giao dịch dài hơn.
So sánh này giả định không lệch xung nhịp, không có chu kỳ dừng, tín hiệu điều khiển được căn đúng và không có đường nào khác chi phối độ trễ ở hai tầng. Thanh ghi đường ống làm tăng diện tích, tải xung nhịp và công suất. Các đường đi tắt ngắn, kể cả phần tổng thấp đã lưu, vẫn cần kiểm tra thời gian giữ. Phép tính tần số tự nó không chứng minh thiết kế vật lý đáp ứng những yêu cầu đó.
Một phép kiểm tra chức năng hữu ích là biểu diễn rõ nhóm dữ liệu được lưu trong thanh ghi. Nó có thể chứng minh việc ghép các phần số học là đúng cho mọi cặp đầu vào bốn bit, mà không coi đó là phép kiểm tra chu kỳ tám nano giây.
def stage_one(a, b):
    low = (a & 3) + (b & 3)
    return low & 3, low >> 2, a >> 2, b >> 2

def stage_two(bundle):
    low_sum, carry, upper_a, upper_b = bundle
    upper_sum = upper_a + upper_b + carry
    return (upper_sum << 2) | low_sum

for a in range(16):
    for b in range(16):
        assert stage_two(stage_one(a, b)) == a + b
print("256 aligned input pairs passed")
Kết quả chứa cả bit nhớ thứ năm, nên phép đối chiếu bao quát các tổng tới ba mươi. Nếu tầng hai vô tình dùng các toán hạng cao của giao dịch kế tiếp, những bộ cộng đúng vẫn cho đáp án sai. Chẳng hạn, giao dịch đầu 3 + 1 cần nhớ đã lưu bằng một và các nửa cao bằng không. Ghép bit nhớ đó với các nửa cao của giao dịch tiếp theo 12 + 0 sẽ tạo mười sáu thay vì bốn. Khi có chu kỳ trống hoặc dừng, bit hợp lệ hay nhãn giao dịch phải đi cùng nhóm dữ liệu.
Với bài tập tiếp theo, hãy đưa một chuỗi cặp đầu vào khác nhau qua thanh ghi nhóm dữ liệu một phần tử, rồi so các đầu ra đã trễ với một hàng đợi tổng mong đợi. Thêm một chu kỳ trống và quy định rõ nó khiến từng tầng tiến tiếp hay giữ lại. Bài tập này kiểm tra quy tắc điều phối mà bảng chân trị phép cộng đơn thuần không thể mô tả.
Đối với công việc tối ưu phần mềm, bài học cụ thể là một phép cộng trong mã nguồn không tương ứng với một độ trễ cổng chung. Độ trễ lệnh, thông lượng và chu kỳ xung nhịp của bộ xử lý phụ thuộc vào những khía cạnh khác nhau của cách triển khai. Chuỗi lan truyền nhớ nhỏ cho một ví dụ rõ ràng về lý do phải định nghĩa riêng các đại lượng đó.