Insertion sort với dữ liệu gần có thứ tự
Liên hệ số lần dịch phần tử với số nghịch thế, so sánh chèn tuần tự và chèn nhị phân, đồng thời kiểm tra tính ổn định khi khóa trùng nhau.
Insertion sort phù hợp với một mảng ngắn đã gần có thứ tự vì công việc của nó phụ thuộc vào số nghịch thế. Một nghịch thế là cặp vị trí có giá trị sai thứ tự: i < j nhưng values[i] > values[j]. Nếu đã biết vòng lặp lồng nhau, bạn có thể đếm những cặp này để hiểu vì sao một thuật toán có thời gian bậc hai trong trường hợp xấu nhất lại làm ít việc trên một đầu vào cụ thể.
Từ “gần” cần được xác định như vậy. Trong [1, 2, 4, 3, 5], chỉ có cặp bốn và ba tạo nghịch thế. Trong [5, 4, 3, 2, 1], mọi cặp trước-sau đều sai thứ tự, tổng cộng mười nghịch thế. Hai mảng cùng có năm giá trị phân biệt, nhưng insertion sort chỉ dịch một phần tử ở mảng đầu và dịch mười lần ở mảng sau.
Chèn một giá trị vào đoạn đầu đã sắp xếp
Ở lượt i, các vị trí trước nó đã có thứ tự. Lưu giá trị hiện tại, dịch các phần tử lớn hơn sang phải rồi đặt giá trị đã lưu vào chỗ trống. Cần giữ giá trị này trong biến riêng vì ô ban đầu của nó có thể bị ghi đè.
def insertion_sort(values):
    shifts = 0
    for i in range(1, len(values)):
        current = values[i]
        j = i
        while j > 0 and values[j - 1] > current:
            values[j] = values[j - 1]
            shifts += 1
            j -= 1
        values[j] = current
    return shifts

nearly = [1, 2, 4, 3, 5]
reversed_values = [5, 4, 3, 2, 1]
assert insertion_sort(nearly) == 1
assert insertion_sort(reversed_values) == 10
assert nearly == reversed_values == [1, 2, 3, 4, 5]
Khi chèn ba vào [1, 2, 4], bốn dịch sang phải một ô. Hai không lớn hơn ba nên vòng dịch dừng lại, và ba được đặt vào khoảng trống. Giá trị tiếp theo là năm đã nằm đúng phía sau đoạn đầu nên không cần dịch phần tử nào.
Điều kiện so sánh dùng > thay vì >=. Các giá trị bằng nhau giữ nguyên thứ tự ban đầu, vì vậy phiên bản này ổn định. Nếu phần tử là bản ghi, hãy so sánh khóa sắp xếp nhưng di chuyển cả bản ghi. Dịch cả những bản ghi có khóa bằng nhau có thể đảo thứ tự đăng ký hoặc thứ tự có ý nghĩa khác đã tồn tại trong đầu vào.
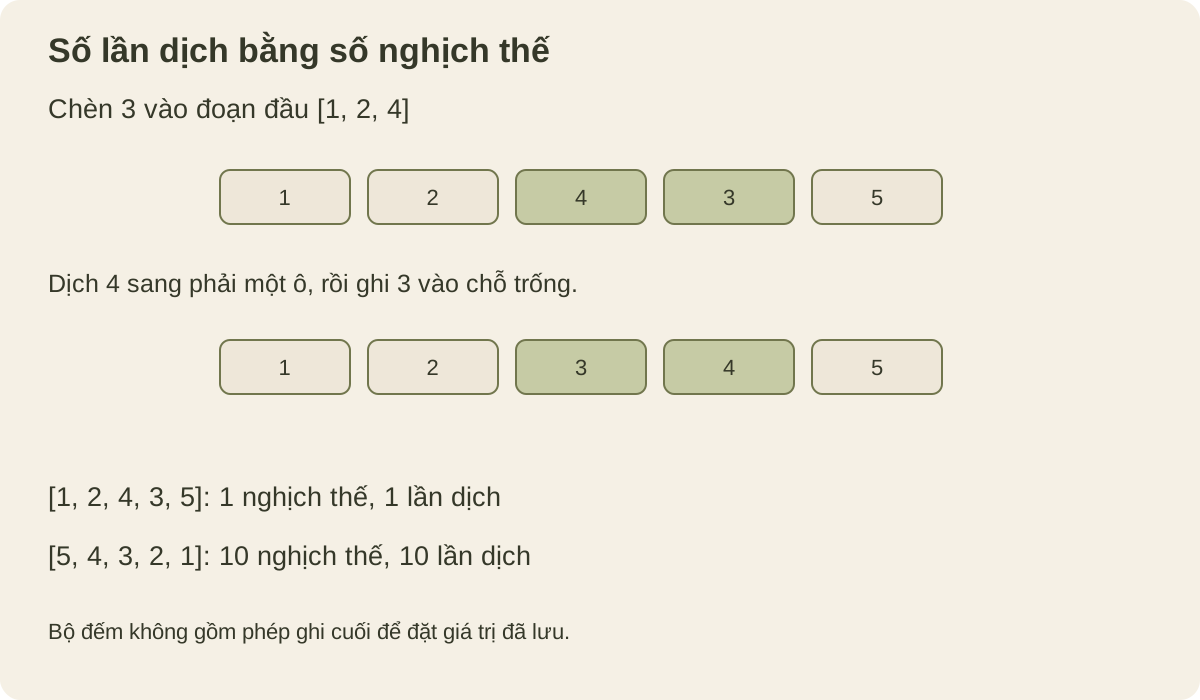
Hình đếm số lần dịch các phần tử đã có trong đoạn đầu. Nó không đếm phép gán cuối cùng để đặt giá trị đã lưu, cũng không đếm mọi lần kiểm tra điều kiện vòng lặp. Khi đối chiếu hai cách cài đặt, cần nói rõ ranh giới này trước khi dùng các con số.
Mỗi lần dịch loại bỏ một nghịch thế
Xét giá trị đang được chèn. Mỗi giá trị đứng trước và lớn hơn nó tạo thành một nghịch thế với nó. Vòng lặp chuyển đúng những giá trị lớn hơn đó sang phía sau giá trị hiện tại, mỗi lần một ô. Các giá trị nhỏ hơn hoặc bằng vẫn nằm phía trước. Vì thế, số lần dịch ở lượt này bằng số nghịch thế mà giá trị hiện tại là phần tử đứng sau.
Mỗi nghịch thế chỉ có một phần tử đứng sau. Cộng số lần dịch qua mọi lượt sẽ đếm mỗi nghịch thế ban đầu đúng một lần. Tổng số lần dịch do đó bằng số nghịch thế ban đầu D. Đoạn đầu vẫn có thứ tự vì mọi giá trị trước vị trí chèn đều không lớn hơn giá trị đã lưu, còn những giá trị vừa dịch ra sau đều lớn hơn nó.
Ngay cả khi D bằng không, thuật toán vẫn có việc phải làm. Vòng ngoài đi qua từng giá trị, và phần lớn các lượt cần một phép so sánh để xác định rằng không cần dịch. Tổng công việc là Θ(n + D): Θ(n) với đầu vào đã sắp xếp và Θ(n²) trong trường hợp xấu nhất. Tài liệu về các phép sắp xếp cơ bản của Princeton cũng mô tả quan hệ giữa insertion sort và nghịch thế.
Với các giá trị phân biệt theo thứ tự đảo ngược, D = n(n - 1) / 2, vì mọi cặp đều là nghịch thế. Hai giá trị bằng nhau không tạo nghịch thế khi thứ tự đã sắp xếp cho phép bằng nhau. Do đó, một đầu vào toàn giá trị bằng nhau không cần lần dịch nào trong phiên bản ổn định này.
Đếm vị trí sai là một câu hỏi khác
Trong [2, 3, 4, 5, 1], mọi giá trị đều nằm ngoài vị trí cuối cùng của nó, nhưng chỉ có bốn nghịch thế: hai đến năm đều đứng trước một. Khi chèn giá trị cuối, mỗi phần tử trong bốn phần tử đó dịch một lần. Nếu chỉ đếm “vị trí sai”, ta sẽ gọi đầu vào này là hoàn toàn lộn xộn và bỏ qua lý do insertion sort xử lý nó với ít công việc.
Một đoạn đảo ngược dài nằm giữa mảng đã có thứ tự có thể tạo nhiều nghịch thế dù phần còn lại không đổi. Nếu đoạn dài k và các giá trị của nó vẫn nằm trong khoảng xác định bởi hai phía bên ngoài, riêng đoạn đó tạo k(k - 1) / 2 nghịch thế. Ảnh hưởng của chiều dài đoạn tăng theo bậc hai.
Vì vậy, phép đo hiệu năng cần mô tả cách tạo đầu vào. Một vài lần đổi chỗ ngẫu nhiên, một đoạn ngắn đảo ngược và một giá trị chuyển từ cuối lên đầu có thể tạo các số nghịch thế khác nhau. Gọi chung chúng là “gần có thứ tự” sẽ che mất đặc điểm công việc. Hãy đếm số lần dịch bên cạnh thời gian để có thể giải thích kết quả đo.
So sánh công bằng với thư viện sắp xếp
Ngoài danh sách đầu vào và các biến vòng lặp, cách cài đặt này dùng bộ nhớ bổ sung hằng số. Tuy nhiên, nó thực hiện các phép gán ở mức Python. So thời gian với hàm thư viện sẽ trộn ảnh hưởng của thuật toán với chi phí của trình thông dịch. Mô hình trên giả sử phép so sánh khóa có chi phí hằng số; khóa cần phân tích tài liệu hoặc truy cập mạng không tuân theo giả định đơn giản đó.
Thư viện thực tế cũng có thể khai thác cấu trúc sẵn có. Hướng dẫn sắp xếp của Python nói rằng thuật toán của nó tận dụng được thứ tự đã tồn tại. Việc insertion sort hưởng lợi từ ít nghịch thế không chứng minh rằng nó nhanh hơn hàm sắp xếp chuẩn trong ứng dụng của bạn.
Một bài tập có kiểm soát là liệt kê các mảng ngắn có giá trị trùng, đếm nghịch thế bằng hai vòng lặp đơn giản rồi so với bộ đếm dịch của thuật toán. Đừng đưa hàm đếm bậc hai này vào phép đo hiệu năng. Kiểm thử phải xác nhận cả kết quả đã sắp xếp lẫn đẳng thức giữa số lần dịch và số nghịch thế; mỗi điều riêng lẻ đều bỏ sót một phần lập luận.
Chèn nhị phân tách phép so sánh khỏi phép di chuyển
Tìm kiếm nhị phân có thể xác định chỗ chèn trong đoạn đầu đã sắp xếp. Nó không tự tạo ra chỗ trống trong mảng liên tiếp: các bản ghi nằm giữa vẫn phải dịch đi. Khác biệt này đáng quan tâm khi so sánh khóa tốn kém còn di chuyển một tham chiếu tương đối rẻ. Hãy đếm cả hai loại thao tác trước khi quyết định thay đổi có hữu ích hay không.
Để giữ tính ổn định, ta tìm khóa đầu tiên trong đoạn đầu lớn hơn hẳn khóa đã lưu. Vị trí đó nằm sau các khóa bằng nó. Nếu dùng cận dưới, bản ghi mới sẽ nằm trước các bản ghi bằng khóa đã có, làm đảo thứ tự đến khi liên tục chèn các bản ghi cùng khóa.
def binary_insertion_sort(records, key):
    comparisons = shifts = 0
    for i in range(1, len(records)):
        current = records[i]
        current_key = key(current)
        lo, hi = 0, i
        while lo < hi:
            middle = (lo + hi) // 2
            comparisons += 1
            if key(records[middle]) <= current_key:
                lo = middle + 1
            else:
                hi = middle
        for j in range(i, lo, -1):
            records[j] = records[j - 1]
            shifts += 1
        records[lo] = current
    return comparisons, shifts

backwards = list(range(8, 0, -1))
ordered = list(range(1, 9))
assert binary_insertion_sort(backwards, key=lambda x: x) == (17, 28)
assert binary_insertion_sort(ordered, key=lambda x: x) == (13, 0)
assert backwards == ordered

registrations = [(2, 'Zoe'), (1, 'Ava'), (2, 'Amy')]
binary_insertion_sort(registrations, key=lambda record: record[0])
assert registrations == [(1, 'Ava'), (2, 'Zoe'), (2, 'Amy')]
Với tám giá trị phân biệt theo thứ tự đảo ngược, insertion sort thông thường thực hiện hai mươi tám phép so sánh khóa và hai mươi tám lần dịch. Phiên bản nhị phân dùng mười bảy phép so sánh nhưng vẫn dịch hai mươi tám lần. Với tám giá trị đã có thứ tự, bản thông thường so sánh bảy lần và không dịch; bản nhị phân này so sánh mười ba lần và cũng không dịch. Tìm kiếm nhị phân giảm so sánh trên một đầu vào nhưng làm tăng trên đầu vào khác.
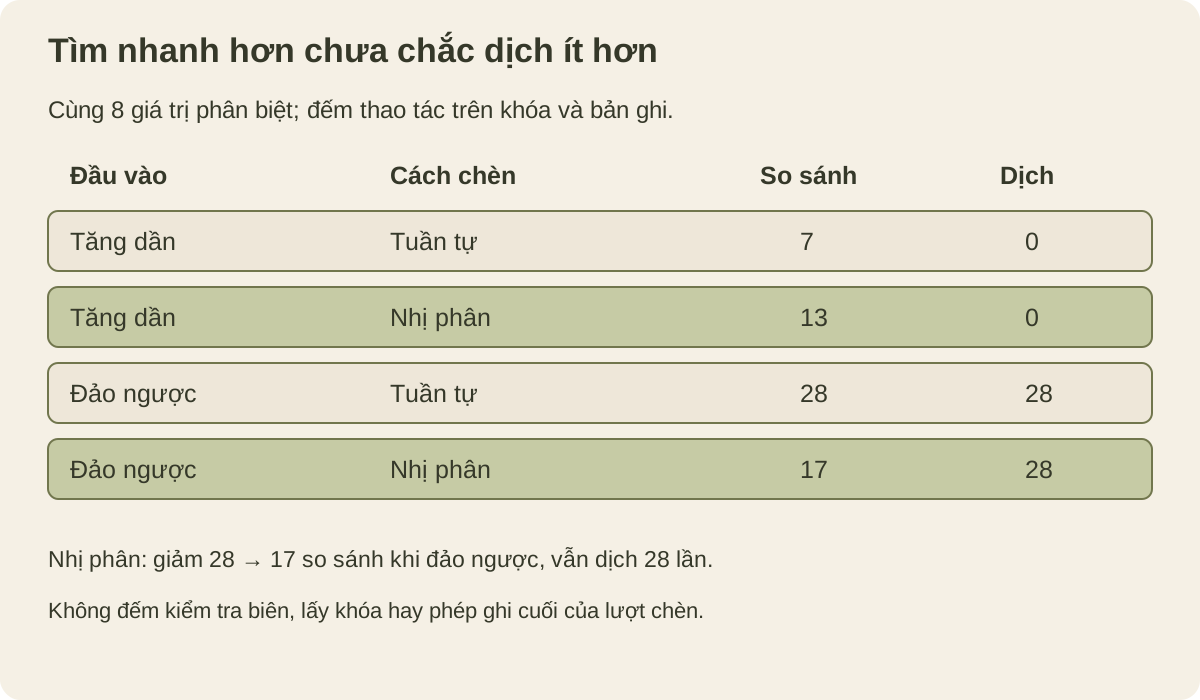
Ở đây, một phép so sánh khóa là phép so sánh giữa hai khóa dữ liệu. Bộ đếm không tính kiểm tra biên chỉ số, lời gọi hàm lấy khóa hay phép ghi cuối để đặt bản ghi đã lưu. Phiên bản nhị phân lấy khóa của bản ghi đang chèn một lần, nhưng có thể lấy lại khóa của các bản ghi trong đoạn đầu nhiều lần. Nó không bảo đảm mỗi bản ghi đầu vào chỉ được lấy khóa một lần. Có thể dùng thêm mảng khóa đã lưu để đạt điều đó, đổi lại cần bộ nhớ và phải dịch hai mảng đồng bộ.
Chèn nhị phân giảm số phép so sánh khóa trong trường hợp xấu nhất xuống O(n log n), nhưng thời gian xấu nhất vẫn là bậc hai vì phải dịch qua mọi nghịch thế. Với cùng mô hình chi phí hằng số, thời gian là O(n log n + D). Một phép kiểm tra trước với khóa cuối đoạn đầu có thể bỏ qua tìm kiếm khi bản ghi đã đúng chỗ ở cuối; đó là một cách cài đặt khác và có bộ đếm khác.
Hãy thêm bộ đếm so sánh vào hàm ban đầu, không tính lần điều kiện biên sai thành một phép so sánh khóa. Tái hiện các số trong hình, rồi liệt kê đầu vào ngắn có khóa trùng và bản ghi gắn nhãn. Hai cách cài đặt phải có cùng số lần dịch, cho khóa đã sắp xếp và giữ thứ tự nhãn trong từng nhóm khóa bằng nhau. Bài tập kiểm tra đồng thời cách giải thích chi phí và cam kết về tính ổn định.