Lan truyền ngược cộng đóng góp từ mọi nhánh
Lần theo phép tính vô hướng dùng chung, tái tạo gradient, phát hiện nhánh bị tách và phân biệt điểm gãy ReLU với lỗi đạo hàm.
Một giá trị trung gian có thể ảnh hưởng đến tổn thất qua nhiều nhánh. Lan truyền ngược phải cộng các đóng góp ấy trước khi truyền kết quả tiếp về phía đầu vào. Trong mạng nhỏ dưới đây, nếu chỉ giữ nhánh qua lớp ẩn, đạo hàm theo trọng số bằng 24. Tính cả nhánh trực tiếp thì đạo hàm đúng bằng 32, dù hai chương trình đều báo cùng tổn thất bằng 8 ở lượt tính xuôi.
Bài viết dành cho sinh viên và kỹ sư đang học cách vi phân tự động hoạt động. Bạn cần biết đạo hàm của một tích và có thể chạy các hàm Python nhỏ. Chúng ta sẽ xây dựng bản tham chiếu vô hướng, xem giá trị cùng đạo hàm thực tế, rồi kiểm tra một điểm gãy của ReLU. Đầu vào được tạo riêng cho bài học; không có tập huấn luyện, phép đo bộ tăng tốc hay lần chạy thư viện học sâu nào.
Gán ý nghĩa cho từng giá trị trung gian
Cố định đầu vào x = 2, mục tiêu bằng 1 và các tham số w = 1, b = −1, v = 3. Tính p = w*x, z = p+b, h = max(0,z), q = v*h, rồi y = q+p. Phép cộng trực tiếp p dùng lại chính giá trị trung gian đi vào nút ẩn. Đây là phép tính dùng chung được thu nhỏ để học, không phải khẳng định về một kiến trúc mạng residual cụ thể.
Dùng tổn thất nửa bình phương sai số L = (y−target)^2/2. Các giá trị xuôi là p=2, z=1, h=1, q=3 và y=5. Sai số bằng 4, tổn thất bằng 8. Tại điểm này ReLU nằm hẳn trong nhánh dương nên có đạo hàm thông thường bằng 1. Những giá trị đã lưu xác định các đạo hàm cục bộ cần dùng trong lượt ngược.
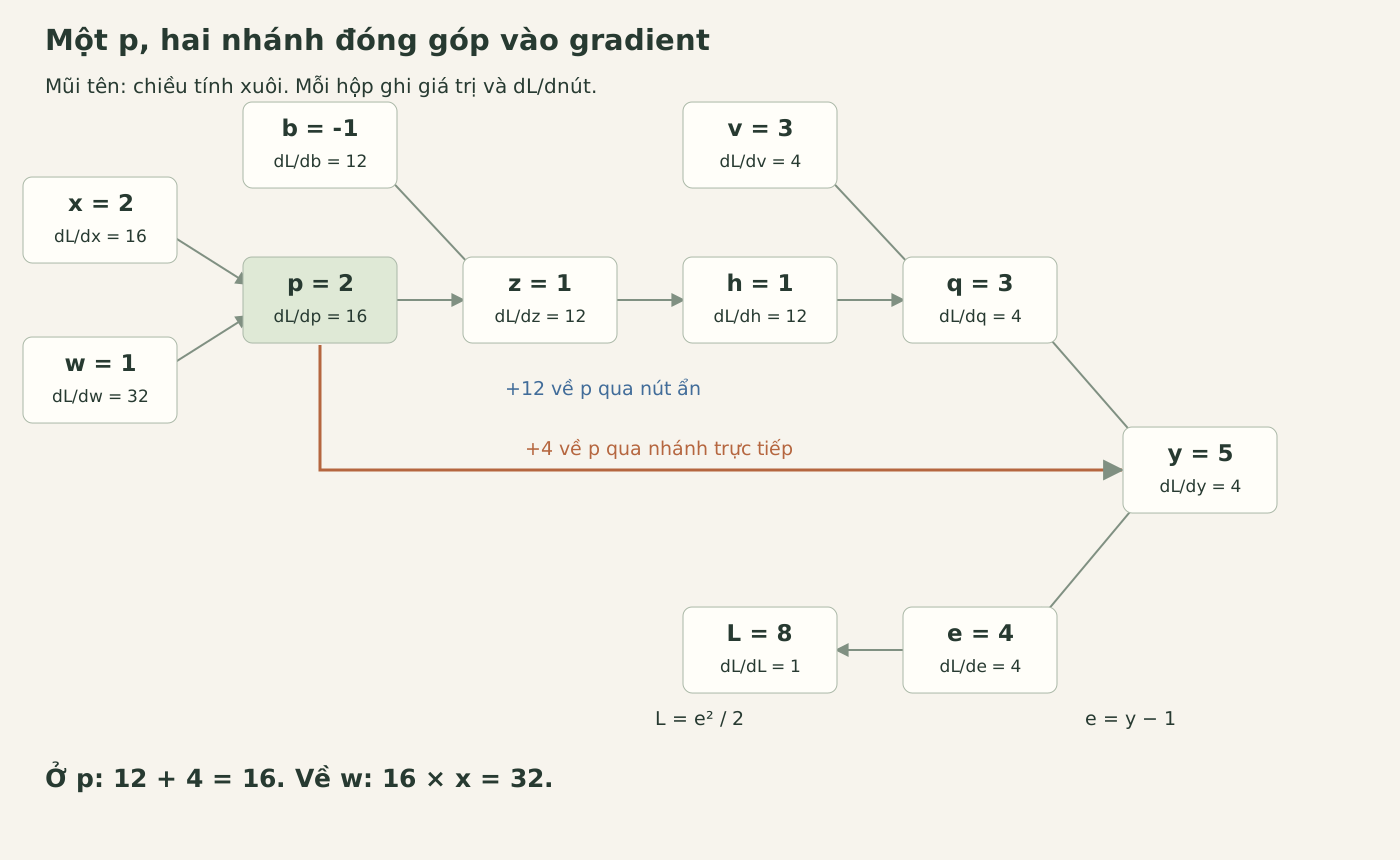
Mũi tên mô tả đúng phép tính minh họa. Đóng góp ngược đến p bằng 12 qua nút ẩn và bằng 4 qua phép cộng trực tiếp.
Bắt đầu từ dL/dL = 1. Tổn thất truyền sai số 4 về y. Phép cộng truyền cùng giá trị 4 về q và trực tiếp về p. Phép nhân với v truyền 4*v = 12 về h; ReLU đang hoạt động truyền 12 về z. Phép cộng tạo z gửi thêm 12 về p và 12 về b. Vì vậy, dL/dp = 4+12 = 16. Phép nhân tạo p cho dL/dw = 16*x = 32 và dL/dx = 16*w = 16. Trọng số đầu ra nhận dL/dv = 4*h = 4.
Đó là quy tắc dây chuyền nhiều biến tại một nút dùng chung: cộng đóng góp từ từng nơi dùng kết quả của nút. Đạo hàm của phép toán theo đầu vào của chính nó là đại lượng cục bộ; gradient đã cộng dồn đo ảnh hưởng lên tổn thất cuối được chọn. Nhầm hai con số này rất dễ khiến bạn bỏ sót một hệ số hoặc một nhánh.
Chương lan truyền xuôi và ngược của Dive into Deep Learning trình bày thứ tự phụ thuộc đảo ngược và việc dùng lại giá trị xuôi. Ví dụ trong sách còn có các đóng góp riêng từ tổn thất dữ liệu và số hạng điều chuẩn. Ví dụ vô hướng của bài này dùng nhánh đầu ra trực tiếp để từng đóng góp đều có thể đối chiếu bằng số.
Viết quy tắc cục bộ rồi cộng các đóng góp
Bốn khối Python sau chạy theo thứ tự trong cùng một phiên. Bản tham chiếu nhỏ hỗ trợ cộng, nhân và ReLU. Hàm pullback phân phối gradient đã cộng dồn ở đầu ra về các đầu vào của một phép toán. Các phép cộng vào trường gradient bên trong những hàm này là điều bắt buộc.
class Value:
    def __init__(self, value, parents=()):
        self.value = float(value)
        self.grad = 0.0
        self.parents = parents
        self.pullback = lambda: None

    @staticmethod
    def wrap(value):
        return value if isinstance(value, Value) else Value(value)

    def __add__(self, other):
        other = self.wrap(other)
        out = Value(self.value + other.value, (self, other))
        def pullback():
            self.grad += out.grad
            other.grad += out.grad
        out.pullback = pullback
        return out

    def __mul__(self, other):
        other = self.wrap(other)
        left, right = self.value, other.value
        out = Value(left * right, (self, other))
        def pullback():
            self.grad += right * out.grad
            other.grad += left * out.grad
        out.pullback = pullback
        return out

    def relu(self):
        active = self.value > 0
        out = Value(max(0.0, self.value), (self,))
        def pullback():
            self.grad += out.grad if active else 0.0
        out.pullback = pullback
        return out

    def backward(self):
        order, visited = [], set()
        def visit(node):
            if node in visited:
                return
            visited.add(node)
            for parent in node.parents:
                visit(parent)
            order.append(node)
        visit(self)
        for node in order:
            node.grad = 0.0
        self.grad = 1.0
        for node in reversed(order):
            node.pullback()

    __radd__ = __add__
    __rmul__ = __mul__
Phép duyệt thăm mỗi nút một lần, nhưng mỗi phép toán vẫn phân phối đóng góp cho từng vị trí toán hạng. Nếu cùng một nút xuất hiện hai lần trong phép nhân, nó phải nhận cả hai số hạng. Tránh thăm lặp một nút là đúng; bỏ đạo hàm của toán hạng xuất hiện lặp thì không đúng. Với r*r tại r=3, hai số hạng ấy đều bằng 3.
Bộ máy micrograd của Karpathy là một cách triển khai gọn để học mô hình này, gồm cộng vào trường gradient và duyệt theo thứ tự tô pô đảo ngược. Bản tham chiếu ở đây theo các ý tưởng ấy nhưng chủ đích xóa mọi gradient có thể đi tới từ kết quả ở đầu mỗi lần gọi backward. Nó cũng giữ lại giá trị của phép nhân và nhánh ReLU trong lượt xuôi. Những lựa chọn này xác định hành vi của ví dụ, không mô tả mọi API vi phân tự động.
Ta dựng đồ thị mới mỗi khi đổi tham số. Đừng sửa giá trị nút hay liên kết tới nút cha trong đồ thị đã tính xong rồi kỳ vọng phép tính xuôi đã lưu tự trở thành lần đánh giá mới. Lớp này được giữ nhỏ: không có tensor, broadcasting, đạo hàm bậc cao, checkpoint hay chính sách tổng quát cho đầu vào không hữu hạn. Phép duyệt đệ quy phù hợp với đồ thị ngắn này, không phù hợp với chuỗi dài không giới hạn.
def network(w=1.0, b=-1.0, v=3.0, x=2.0, target=1.0, detach_skip=False):
    x, w, b, v = [Value(t) for t in (x, w, b, v)]
    p = w * x
    z = p + b
    h = z.relu()
    q = v * h
    skip = Value(p.value) if detach_skip else p
    y = q + skip
    e = y + (-target)
    loss = 0.5 * e * e
    return dict(x=x, w=w, b=b, v=v, p=p, z=z, h=h, q=q, y=y, e=e, loss=loss)

full = network()
full['loss'].backward()
print('forward', {k: full[k].value for k in ('p', 'z', 'h', 'q', 'y', 'e', 'loss')})
print('gradients', {k: full[k].grad for k in ('p', 'w', 'b', 'v', 'x')})
assert [full[k].grad for k in ('p', 'w', 'b', 'v', 'x')] == [16, 32, 12, 4, 16]
full['loss'].backward()
assert full['w'].grad == 32
broken = network(detach_skip=True)
broken['loss'].backward()
print('detached skip', 'loss', broken['loss'].value, 'w gradient', broken['w'].grad)
assert broken['loss'].value == 8 and broken['w'].grad == 24
r = Value(3)
(r * r).backward()
print('repeated operand', 'value', r.value, 'gradient', r.grad)
assert r.grad == 6
Lượt chạy đầy đủ in gradient p=16, w=32, b=12, v=4 và x=16. Gọi backward của bản tham chiếu thêm lần nữa trả lại cùng kết quả vì các bộ đệm được đặt lại. Muốn chủ đích tích lũy qua nhiều ví dụ thì cần chính sách riêng, bao gồm việc hàm mục tiêu lấy tổng hay trung bình của chúng.
Lượt chạy tách nhánh bọc giá trị số hiện tại của p vào một nút lá mới trước phép cộng trực tiếp. Phép tính xuôi vẫn cho tổn thất 8, nhưng nút lá mới không có quan hệ phụ thuộc được ghi lại với w. Nhánh ẩn còn lại tạo gradient theo trọng số bằng 24. Vi phân tự động đi theo đồ thị mà nó nhận. Trong ví dụ này, dựng lại hàm bao tách nhánh ở mỗi giá trị w bị nhiễu cũng tính lại giá trị p được sao chép, nên sai phân hữu hạn thông thường của hàm bao vẫn bằng 32. Con số 24 là đạo hàm của đồ thị đã ghi khi giữ nút lá được sao chép cố định; nó không phải đạo hàm thông thường của hàm bao dựng lại bản sao.
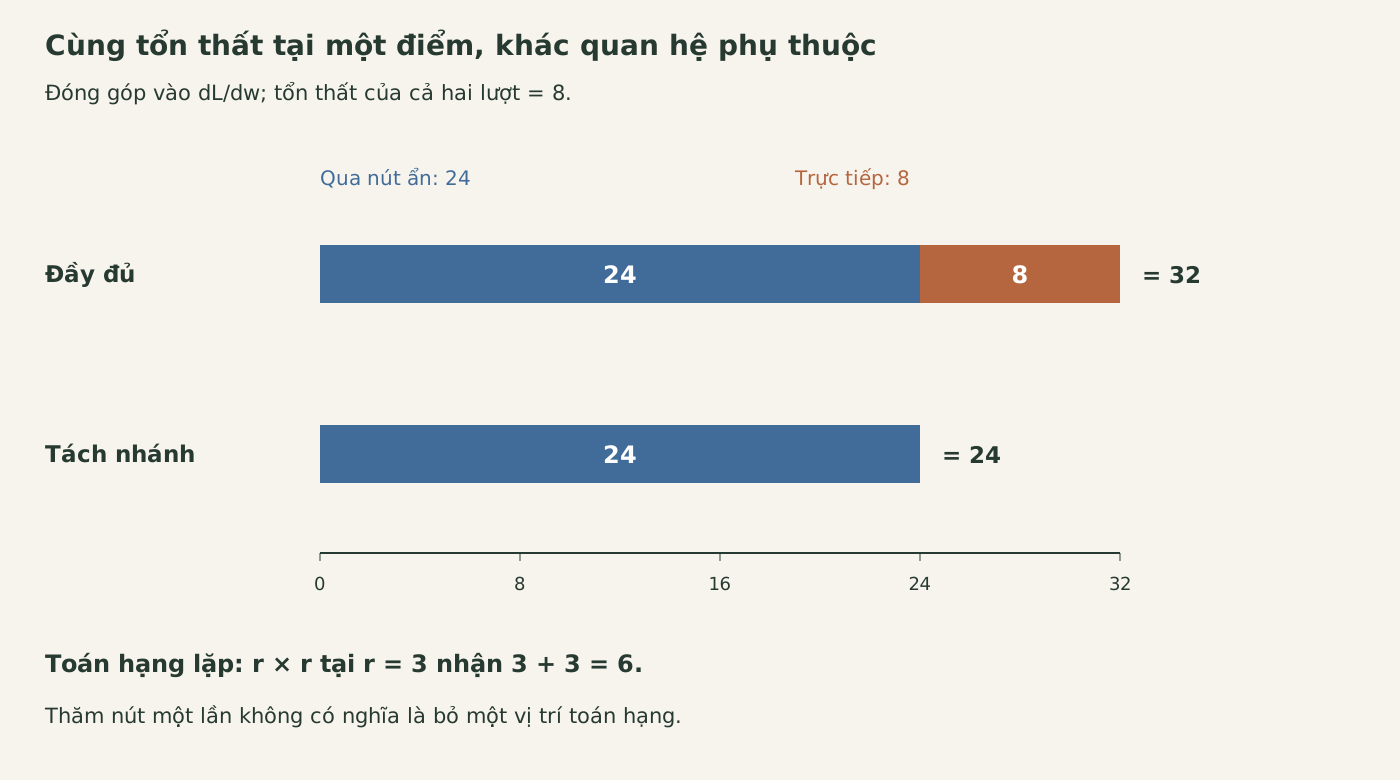
Nhánh ẩn đóng góp 24 vào đạo hàm theo trọng số, nhánh trực tiếp đóng góp 8. Thay nhánh trực tiếp bằng giá trị số của nó sẽ loại bỏ đóng góp đạo hàm được ghi lại từ nhánh đó.
Một lượt xuôi và một lượt duyệt ngược tính được tất cả gradient đầu vào vô hướng ở đây. Số phép toán phụ thuộc các nút và cạnh của đồ thị. Trong khi đó, kiểm tra sai phân trung tâm thường cần hai lần đánh giá tổn thất mới cho mỗi tham số được kiểm tra. Điều này giải thích lợi ích của việc dùng lại kết quả mà không hứa một mức tăng tốc cụ thể: nhân tensor, lưu lượng bộ nhớ và chi phí thực thi nằm ngoài thí nghiệm này.
Kiểm tra riêng điểm trơn và điểm gãy
Ở bộ tham số ban đầu, thay đổi w một lượng nhỏ vẫn giữ ReLU trong nhánh dương. Tổn thất cục bộ là hàm bậc hai theo w, nên sai phân đối xứng không có sai số cắt cụt trong số học chính xác khi cả hai lần đánh giá vẫn ở nhánh đó. Các giá trị dấu phẩy động đã chạy gần bằng 32, với sai số làm tròn nhỏ.
Bây giờ đặt b bằng −2 và giữ w=1. Giá trị trước kích hoạt đúng bằng không. Ngay bên trái, đầu ra nút ẩn vẫn bằng không và đạo hàm theo trọng số tiến tới 2. Ngay bên phải, nhánh ẩn hoạt động và đạo hàm tiến tới 8. Không có một đạo hàm thông thường duy nhất tại điểm này.
def loss_at(w, b=-1.0):
    return network(w=w, b=b)['loss'].value

smooth_checks = []
for step in (1e-2, 1e-4, 1e-6):
    central = (loss_at(1 + step) - loss_at(1 - step)) / (2 * step)
    smooth_checks.append((step, central))
    assert abs(central - 32) < 1e-6
print('smooth central differences', [(h, round(d, 9)) for h, d in smooth_checks])
kink = network(b=-2.0)
kink['loss'].backward()
print('kink chosen w gradient', kink['w'].grad)
kink_checks = []
for step in (1e-2, 1e-4, 1e-6):
    base = loss_at(1, b=-2)
    left = (base - loss_at(1 - step, b=-2)) / step
    right = (loss_at(1 + step, b=-2) - base) / step
    central = (loss_at(1 + step, b=-2) - loss_at(1 - step, b=-2)) / (2 * step)
    kink_checks.append((step, left, right, central))
print('kink differences', [tuple(round(t, 9) for t in row) for row in kink_checks])
assert kink['w'].grad == 2
assert abs(kink_checks[-1][1] - 2) < 1e-4
assert abs(kink_checks[-1][2] - 8) < 1e-4
assert abs(kink_checks[-1][3] - 5) < 1e-4
Quy tắc ReLU của chúng ta chọn đạo hàm riêng bằng không tại đầu vào bằng không, nên nhánh trực tiếp vẫn còn và gradient trả về theo trọng số bằng 2. Sai phân trung tâm tiến tới 5 vì nó trải qua cả hai phía. Việc nó khác 2 không chứng minh mã cộng dồn bị lỗi. Cần diễn giải sai phân hữu hạn dựa trên tính khả vi cục bộ của hàm.
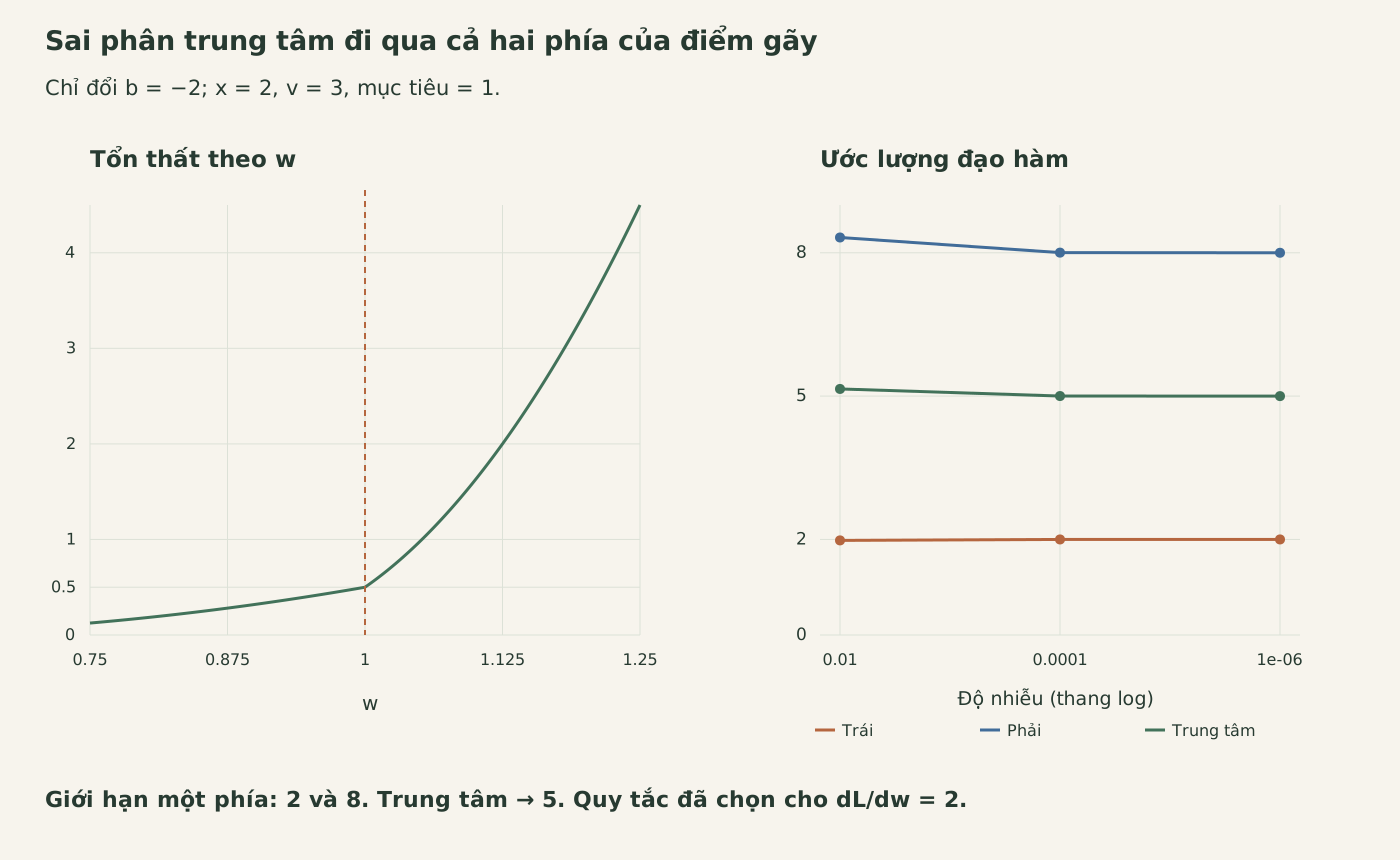
Thí nghiệm điểm gãy chỉ đổi b thành −2. Đạo hàm giới hạn bên trái và phải là 2 và 8; sai phân trung tâm tiến tới 5, còn quy tắc ngược đã khai báo trả về 2 tại điểm gãy.
Ghi chú cơ chế autograd của PyTorch phân biệt rõ đạo hàm thông thường với quy ước cho phép toán cơ bản không khả vi. Ta dùng phần giải thích này để xác định giới hạn, không dùng nó làm bằng chứng đã chạy PyTorch. Quy tắc ReLU cục bộ được chọn đã hiện rõ trong mã; bài không khẳng định quy tắc dây chuyền tổng quát cho mọi phép hợp hàm không trơn.
Khi kiểm tra gradient thực tế, trước hết chọn điểm cách xa ranh giới nhánh đã biết. So sánh nhiều độ lớn nhiễu, xem cả sai số tuyệt đối lẫn tương đối, và giữ nguyên định nghĩa tổn thất cùng cách dựng đồ thị. Nhiễu quá nhỏ có thể mất thông tin qua phép trừ và làm tròn. Nếu hai phía kích hoạt nhánh khác nhau, hãy xem hành vi một phía trước khi coi ước lượng trung tâm là đạo hàm tham chiếu.
Gradient đúng không tự chọn được bước an toàn
Lượt ngược trả về đạo hàm, không trả về bộ tham số mới. Khối tiếp theo đổi w, b và v đồng thời bằng cùng gradient tại điểm ban đầu. Nó giữ x và mục tiêu cố định, rồi dựng lại đồ thị sau bước cập nhật. Nhờ vậy, phép tính đạo hàm được tách khỏi quyết định của bộ tối ưu.
updates = []
for rate in (0.01, 0.1):
    fresh = network()
    fresh['loss'].backward()
    parameters = {k: fresh[k].value - rate * fresh[k].grad for k in ('w', 'b', 'v')}
    after = network(**parameters)
    updates.append(dict(rate=rate, parameters=parameters, loss=after['loss'].value, hidden=after['h'].value))
print('one-step updates', updates)
assert updates[0]['loss'] < 8 < updates[1]['loss']
Với tốc độ 0,01, tham số mới xấp xỉ w=0,68, b=−1,12 và v=2,96. Tổn thất tính lại xấp xỉ 0,57287808. Với tốc độ 0,1, chúng trở thành −2,2, −2,2 và 2,6, còn tổn thất tăng lên 14,58. Bước cập nhật thứ hai vượt ranh giới kích hoạt. Gradient ban đầu vẫn đúng tại điểm ban đầu; nó không bảo đảm cải thiện cho mọi bước hữu hạn tùy ý.
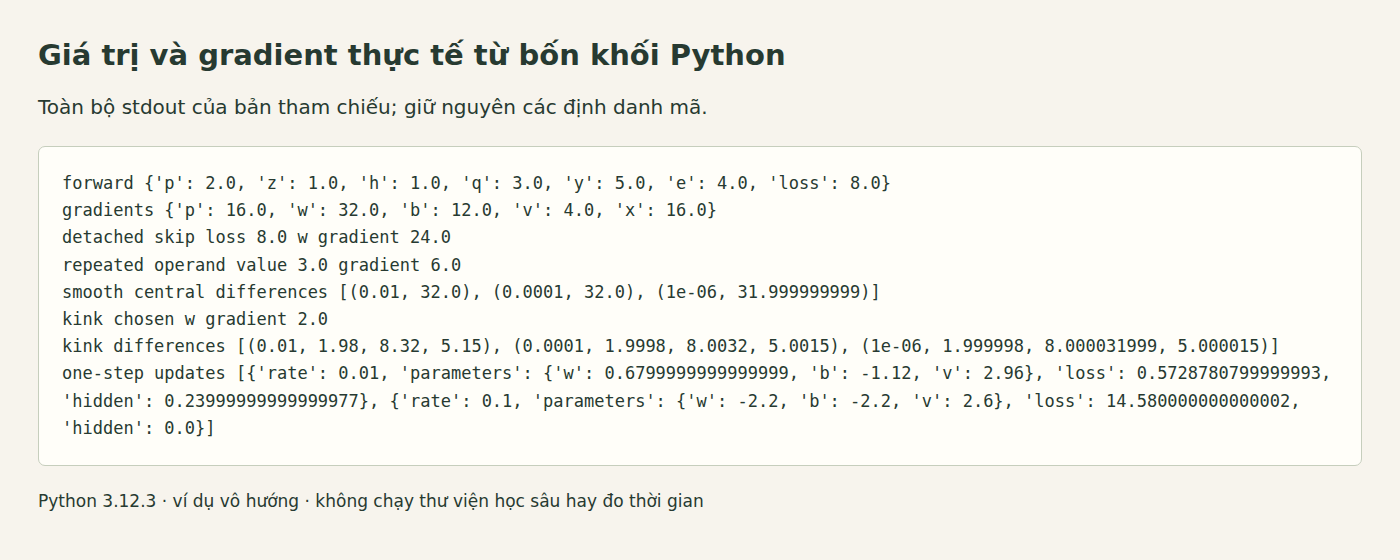
Ảnh chụp trình duyệt cục bộ trình bày stdout lưu từ bốn khối đã thực thi. Nhãn xác định đúng thí nghiệm vô hướng, không phải bảng theo dõi huấn luyện.
Trong bài tập đầu, bỏ hẳn nhánh đầu ra trực tiếp và chỉ dùng y=q. Với giá trị tham số ban đầu, hãy kỳ vọng tổn thất 2 và các đạo hàm w=12, b=6, v=2. Thao tác này đổi cả hàm xuôi lẫn đạo hàm, khác thí nghiệm tách nhánh: thí nghiệm đó giữ một giá trị xuôi nhưng đổi quan hệ phụ thuộc được ghi lại.
Sau đó khôi phục nhánh trực tiếp và đặt v bằng không. Kỳ vọng tổn thất 0,5, đạo hàm theo trọng số bằng 2, theo bias bằng 0 và theo trọng số đầu ra bằng 1. Trọng số đầu ra bằng không chặn đóng góp hiện tại của nhánh ẩn tới các tham số phía trước, nhưng không ngăn chính trọng số đầu ra nhận gradient. Hãy kiểm tra bằng đồ thị mới và mục tiêu đã khai báo, thay vì mang bộ đệm cũ từ bài tập trước sang.