Đổi thang đặc trưng làm thay đổi hình học của gradient descent
Suy ra tác động của đơn vị đặc trưng lên độ cong, bảo toàn hạng phạt khi đổi thang và kiểm tra vì sao phương sai đơn vị vẫn có thể đi cùng số điều kiện 100.
Đổi thang đặc trưng làm thay đổi cách một bước gradient đánh giá độ lớn của các dịch chuyển tham số. Điều đó có thể giúp tối ưu hóa khi đơn vị của một đầu vào tạo ra độ cong lớn hơn nhiều so với đầu vào khác. Nó cũng có thể làm thay đổi mô hình được khớp nếu giữ nguyên các hạng phạt hệ số.
Nếu bạn đã biết hồi quy tuyến tính và gradient descent, bài nền tảng này tách hai tác động ấy bằng bốn quan sát giả lập. Ta suy ra một hàm mất mát có điều kiện số kém trực tiếp từ ma trận thiết kế, sửa sự chênh lệch đơn vị, rồi dựng hai đặc trưng đều đã chuẩn hóa nhưng vẫn có số điều kiện bằng 100 do tương quan. Đây là phép tính chính xác, không phải so sánh tốc độ huấn luyện đo được.
Suy ra hình học từ bốn hàng dữ liệu
Cho hai vector đặc trưng đã có trung bình không là q = (-1,-1,1,1) và z = (-1,1,-1,1). Trung bình bình phương của mỗi vector bằng một, còn trung bình tích của chúng bằng không. Dùng q làm đầu vào thứ nhất và 10z làm đầu vào thứ hai. Với mục tiêu bằng không, không khớp hệ số chặn và quy ước mất mát bình phương trung bình bên dưới, hàm mất mát theo hệ số là:
L(beta) = ||X beta||² / (2n), n = 4
H = XᵀX / n = diag(1,100)
L(beta) = (beta_1² + 100 beta_2²) / 2
Với Hessian đối xứng xác định dương, số điều kiện phổ là trị riêng lớn nhất chia cho trị riêng nhỏ nhất: ở đây bằng 100. Ta đang xét ma trận cụ thể này và gradient descent theo hình học Euclid, không phải một số điều kiện độc lập với hệ tọa độ. Chương tính toán số của sách Deep Learning liên hệ độ cong theo hướng của Hessian với bước học phù hợp.
Ở tốc độ học 0,019, mỗi lần cập nhật nhân hệ số thứ nhất với 0,981 và hệ số thứ hai với −0,9. Bắt đầu từ (1,1), sau 100 lần cập nhật, độ lớn của chúng xấp xỉ 0,147 và 0,0000266. Cả hai hội tụ, nhưng hướng có độ cong nhỏ tiến triển chậm. Tăng tốc độ lên 0,02 chạm ranh giới không hội tụ nếu thành phần thứ hai ban đầu khác không.
Chạy lần lượt ba khối Python. Phân số giữ các đẳng thức của ma trận thiết kế và phép cập nhật chính xác; các số thập phân được in chỉ tóm tắt những giá trị ấy.
from fractions import Fraction as Q

q = tuple(map(Q, (-1, -1, 1, 1)))
z = tuple(map(Q, (-1, 1, -1, 1)))


def gram(rows):
    return tuple(tuple(sum(row[i]*row[j] for row in rows) / len(rows)
                       for j in range(2)) for i in range(2))


def mv(matrix, vector):
    return tuple(sum(a*b for a, b in zip(row, vector)) for row in matrix)


raw_rows = tuple(zip(q, (10*v for v in z)))
H = gram(raw_rows)
assert H == ((1, 0), (0, 100))
beta = (Q(1), Q(1))
eta = Q(19, 1000)
for _ in range(100):
    gradient = mv(H, beta)
    beta = tuple(b - eta*g for b, g in zip(beta, gradient))
assert beta == (Q(981, 1000)**100, Q(-9, 10)**100)
print(tuple(float(abs(b)) for b in beta))

scaled_H = gram(tuple(zip(q, z)))
theta = (Q(1), Q(10))
assert scaled_H == ((1, 0), (0, 1))
theta = tuple(t - g for t, g in zip(theta, mv(scaled_H, theta)))
assert theta == (0, 0)
Giữ nguyên dự đoán khi đổi tọa độ
Chia đầu vào thứ hai cho mười và đặt theta_2 = 10 beta_2; giữ theta_1 = beta_1. Mọi dự đoán được bảo toàn vì 10z beta_2 = z theta_2. Trong tọa độ mới, mất mát là (theta_1² + theta_2²)/2, có Hessian là ma trận đơn vị. Một bước với tốc độ học bằng một đi chính xác tới cực tiểu của hàm bậc hai này. Hệ số khởi tạo sau biến đổi là (1,10), biểu diễn cùng dự đoán ban đầu với (1,1) ở tọa độ cũ.
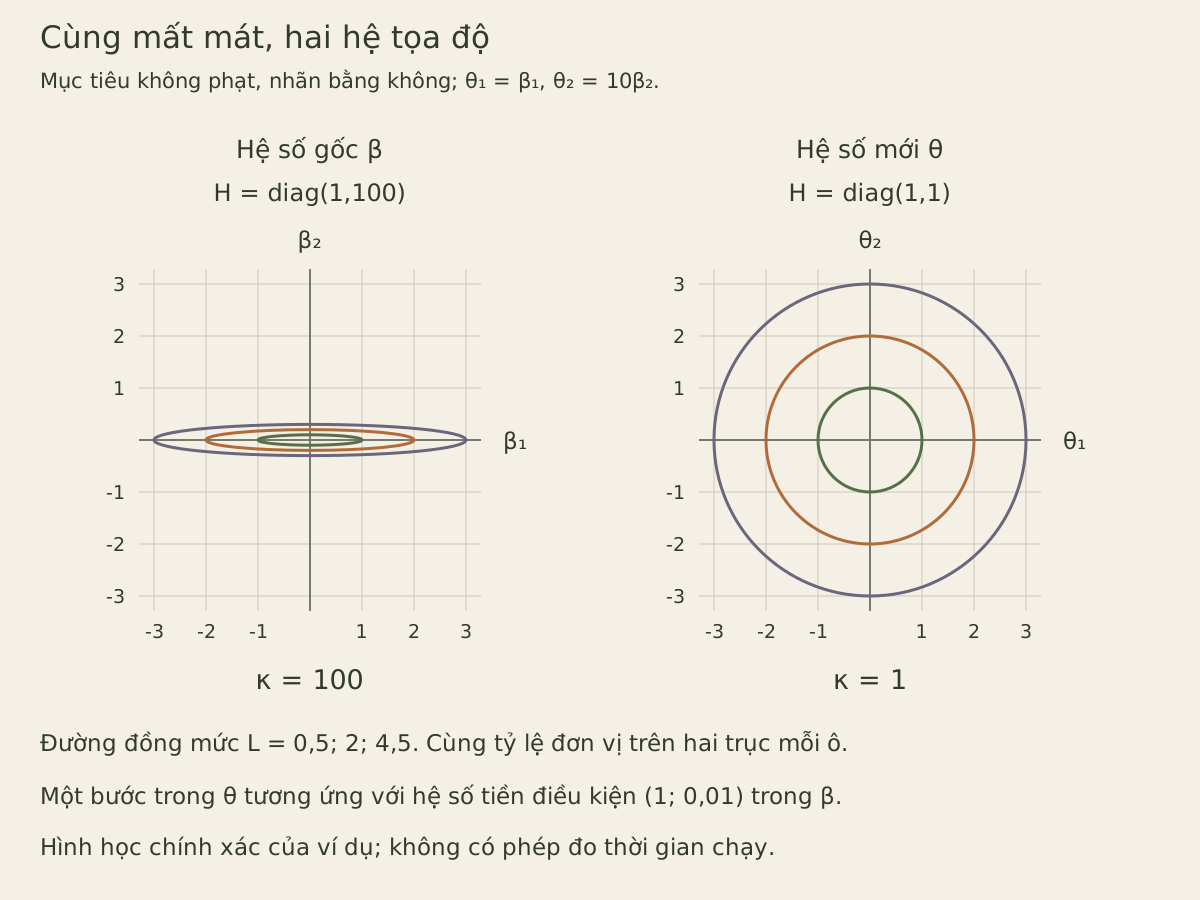
Các mức mất mát ở hai ô hình giống nhau; hệ tọa độ thì khác. Khi viết lại trong tọa độ gốc, phép cập nhật sau biến đổi là một bước có tiền điều kiện: nhân thành phần thứ hai của gradient gốc với 0,01 trước khi áp dụng tốc độ chung. Quỹ đạo tối ưu hóa đã thay đổi, không phải cùng một phép cập nhật chỉ tình cờ chạy nhanh hơn.
Tổng quát hơn, viết theta = D beta và X_scaled = X D⁻¹, với D là ma trận đường chéo khả nghịch biểu diễn thang đổi. Hessian sau biến đổi là D⁻¹ H D⁻¹, còn gradient descent trong tọa độ đó tương ứng với beta_next = beta - eta D⁻² gradient_beta. Các biểu thức giả định thang thực trên đường chéo và cùng một mục tiêu vô hướng được viết lại qua phép đổi tọa độ. Chúng không mô tả mọi lớp chuẩn hóa tùy ý.
Giữ nguyên hạng phạt có thể làm thay đổi đáp án
Bây giờ đổi vector mục tiêu thành 10z và thêm hạng phạt hệ số có độ mạnh bằng một. Ở tọa độ gốc, phần liên quan của mục tiêu là 50(beta_2-1)² + beta_2²/2; hệ số thứ nhất đạt tối ưu tại không. Cho đạo hàm bằng không thu được beta_2 = 100/101.
Sau khi đổi thang đầu vào, muốn giữ nguyên mục tiêu ấy thì hạng phạt của hệ số thứ hai sau biến đổi phải là theta_2²/200. Nếu vẫn dùng biểu thức quen thuộc theta_2²/2, ta đã chọn một mô hình khác. Nghiệm tối ưu của nó bằng năm, tương ứng với hệ số gốc 0,5 thay vì 100/101.
raw_beta = Q(100, 101)
unchanged_penalty_theta = Q(5)
equivalent_penalty_theta = Q(1000, 101)
assert 100*(raw_beta - 1) + raw_beta == 0
assert (unchanged_penalty_theta - 10) + unchanged_penalty_theta == 0
assert (equivalent_penalty_theta - 10) + equivalent_penalty_theta/100 == 0
assert equivalent_penalty_theta/10 == raw_beta
assert unchanged_penalty_theta/10 == Q(1, 2)
print('Original coefficient:', raw_beta)
print('Same penalty after scaling:', unchanged_penalty_theta/10)
print('Transformed penalty:', equivalent_penalty_theta/10)
Chênh lệch vẫn tồn tại ngay cả khi mọi bộ tối ưu đều tới đúng cực tiểu. Vì thế, không thể giải thích nó bằng bộ giải nhanh hơn hoặc số vòng lặp chưa đủ. Hãy xác định thí nghiệm đang xét phép đổi tọa độ giữ nguyên mục tiêu, hay một hạng phạt khác được biểu diễn theo đơn vị đã chuẩn hóa. Cả hai đều có thể hữu ích, nhưng trả lời những câu hỏi khác nhau.
Ví dụ này khai báo rõ các hệ số của mất mát trung bình và hạng phạt. Tham số alpha trong một thư viện không nhất thiết dùng cùng quy ước. Cần chuyển đổi từ mục tiêu được tài liệu hóa của thư viện trước khi đưa giá trị một vào lời gọi API.
Phương sai đơn vị không loại bỏ tương quan
Ở phép tính tiếp theo, quay lại mất mát không có hạng phạt và mục tiêu bằng không.
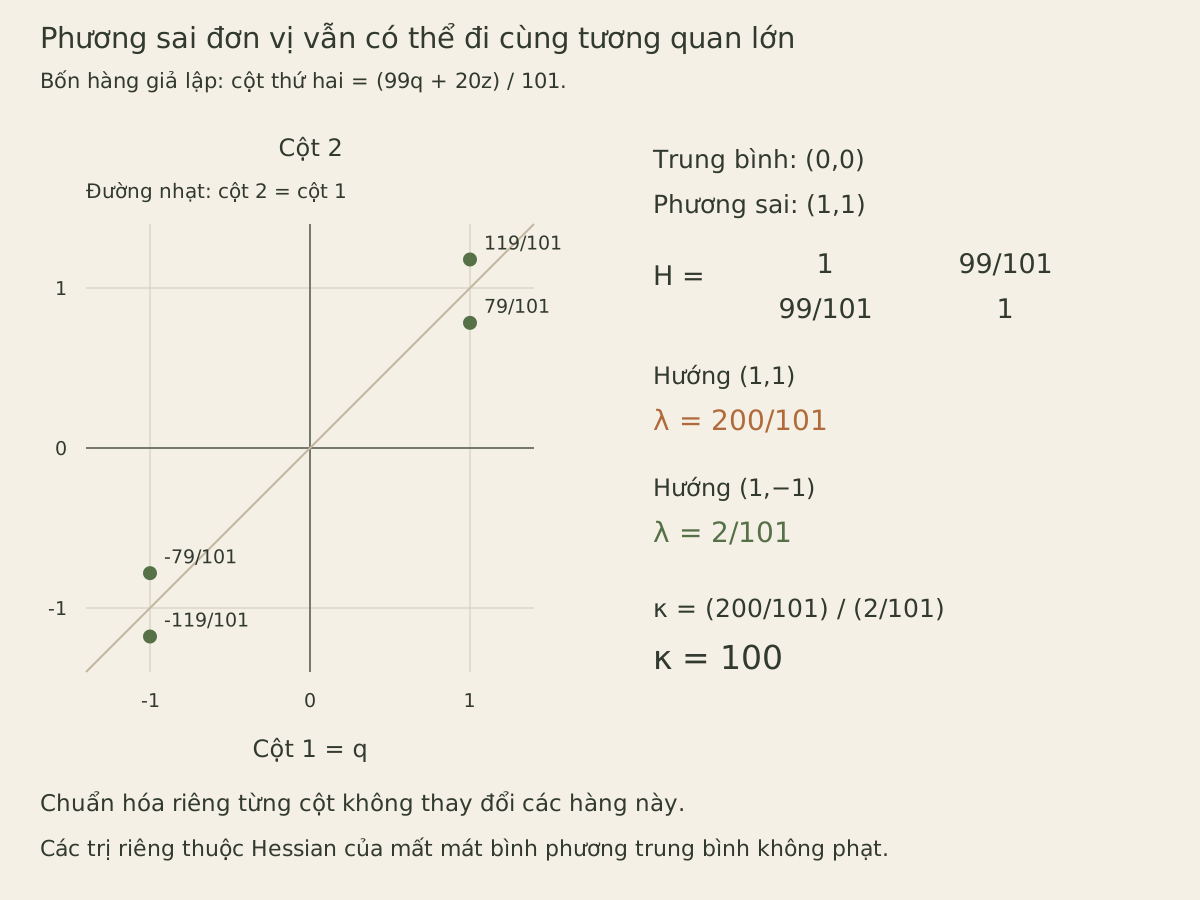
Tài liệu StandardScaler định nghĩa việc trừ trung bình và đổi thang riêng từng đặc trưng, đồng thời dùng quy ước phương sai có mẫu số n. Xét cột thứ hai mới (99q + 20z)/101. Nó đã có trung bình không và phương sai một vì 99² + 20² = 101². Tuy nhiên, tương quan của nó với q vẫn là 99/101.
rho = Q(99, 101)
mix = Q(20, 101)
correlated_rows = tuple((a, rho*a + mix*b) for a, b in zip(q, z))
assert all(sum(row[j] for row in correlated_rows) == 0 for j in range(2))
correlated_H = gram(correlated_rows)
assert correlated_H == ((1, rho), (rho, 1))
assert mv(correlated_H, (1, 1)) == (1 + rho, 1 + rho)
assert mv(correlated_H, (1, -1)) == (1 - rho, -(1 - rho))
assert (1 + rho)/(1 - rho) == 100
print('Curvatures:', 1 + rho, 1 - rho)
print('Condition number:', (1 + rho)/(1 - rho))

inverse_H = ((1/(1-rho*rho), -rho/(1-rho*rho)),
             (-rho/(1-rho*rho), 1/(1-rho*rho)))
beta = (Q(2), Q(-3))
assert mv(inverse_H, mv(correlated_H, beta)) == beta
Hai hướng (1,1) và (1,-1) có trị riêng 200/101 và 2/101. Tỷ số độ cong vẫn bằng 100. Chuẩn hóa lại từng cột không làm thay đổi bộ dữ liệu chính xác này. Câu lệnh kiểm tra cuối cho thấy tác dụng của một ma trận tiền điều kiện đầy đủ và chính xác đối với hàm bậc hai xác định dương: nó biến gradient thành vector độ lệch so với nghiệm tối ưu có mục tiêu không.
Hướng dẫn tiền xử lý của scikit-learn phân biệt đổi thang từng đặc trưng với phép làm trắng, vốn có thể loại bỏ tương quan tuyến tính. Biến đổi dùng ma trận hiệp phương sai hoặc độ cong đầy đủ đòi hỏi ước lượng và áp dụng nhiều thông tin hơn các thang riêng của từng cột. Trong bộ giải thực tế, không cần tính tường minh ma trận nghịch đảo; thường nên dùng phép giải hệ tuyến tính hoặc phân rã phù hợp. Nghịch đảo chính xác ở trên nhằm giải thích hình học, không quy định cách cài đặt cho sản phẩm.
Khi hai cột trùng hoàn toàn, đặc trưng thứ hai bằng q và Hessian suy biến. Các hệ số (1,0) và (0,1) tạo cùng dự đoán trên cả bốn hàng. Không phép đổi thang khả nghịch nào tạo ra hướng độc lập bị thiếu hoặc khiến thiết kế này xác định duy nhất các hệ số ấy. Cột có phương sai bằng không cũng không trở nên có thông tin chỉ nhờ chia cho một thang. Tài liệu bộ chuẩn hóa nêu hệ số chia bằng một khi phương sai bằng không; quy ước đó không khôi phục hạng ma trận.
Chủ động so sánh các bài toán tương đương
Khi thử nghiệm đổi thang, giữ nguyên cách chia dữ liệu, định nghĩa mất mát và dự đoán khởi tạo. Nếu muốn bảo toàn mục tiêu thống kê, cần biến đổi cả hạng phạt. Ghi số vòng lặp riêng với thời gian thực thi: đẳng thức một bước trong bài không phải phép đo tốc độ chạy. So sánh mất mát hoặc dự đoán trong cùng cách biểu diễn, vì chuẩn gradient thô và độ lớn cập nhật hệ số thay đổi theo đơn vị tọa độ.
Trong ví dụ không phạt đầu tiên, gradient gốc tại khởi tạo là (1,100), còn gradient sau biến đổi là (1,10). Bình phương chuẩn Euclid của chúng bằng 10.001 và 101 ngay cả trước khi bộ tối ưu nào thực hiện một bước. Vì thế, chuẩn gradient nhỏ hơn sau đổi thang không nhất thiết có nghĩa dự đoán tốt hơn hoặc mục tiêu thấp hơn. Quy tắc dừng dùng đơn vị gradient theo hệ số phải tính đến phép biến đổi; nếu không, một lần chạy có thể dừng sớm hơn chỉ vì tọa độ số của nó đã đổi.
Chỉ ước lượng các thang từ phần huấn luyện, rồi dùng lại các giá trị ấy cho tập kiểm định và đầu vào về sau. Hướng dẫn tiền xử lý mô tả rõ sự tách biệt giữa học phép biến đổi và áp dụng nó. Ngoại lệ có thể chi phối ước lượng phương sai thông thường; chuyển sang thang bền vững với ngoại lệ làm thay đổi phép biến đổi đang được đánh giá. Với hàm mất mát khác, Hessian có thể phụ thuộc dự đoán và các trọng số bổ sung. Vì vậy, phương sai đặc trưng bằng một không nhất thiết tạo ra độ cong mất mát bằng nhau, ngay cả khi không có tương quan tuyến tính mạnh.
Để luyện tập, hãy nhân đặc trưng thô thứ hai với 100 thay vì mười. Phần tử Hessian không phạt tương ứng trở thành 10.000; bảo toàn dự đoán cần theta_2 = 100 beta_2, còn giữ nguyên hạng phạt hệ số gốc có độ mạnh một cần độ mạnh 1/10000 ở hướng sau biến đổi. Tiếp theo, thay 99/101 và 20/101 bằng 3/5 và 4/5. Suy ra phương sai đơn vị, tương quan 3/5 và số điều kiện bốn. Cuối cùng, đặt đặc trưng thứ hai bằng đặc trưng thứ nhất và xác định những tổng hệ số nào vẫn quan sát được. Các phép kiểm tra này phân biệt đơn vị không phù hợp, gần dư thừa và mất hạng thực sự.