Cận dưới sắp xếp qua cây quyết định
Đếm lá để suy ra cận so sánh, dựng cây đầy đủ cho ba phần tử và phân biệt trường hợp xấu nhất với trung bình theo phân phối đầu vào.
Mọi thuật toán tất định sắp xếp các khóa phân biệt chỉ bằng so sánh từng cặp đều cần Ω(n log n) phép so sánh trong trường hợp xấu nhất. Cây quyết định giải thích cận bằng cách đếm số thứ tự đầu vào mà thuật toán phải phân biệt. Bài này dành cho bạn nếu đã biết vòng lặp và phép so sánh, đang bắt đầu học cận dưới. Ba phần tử có nhãn đã đủ để thấy lập luận trước khi đưa giai thừa vào.
Giả sử mọi khóa khác nhau và mỗi phép so sánh đặt một câu hỏi nhị phân, chẳng hạn A có nhỏ hơn B không. Phép toán trên chữ số của khóa, dùng giá trị khóa làm chỉ số mảng và giả định đầu vào vốn gần có thứ tự đều nằm ngoài mô hình này. Cận dưới chỉ hữu ích khi xác định rõ các thao tác được phép và họ đầu vào.
Mỗi phép so sánh chọn một nhánh
Hãy hình dung chạy một thuật toán sắp xếp cố định nhưng chưa quyết định kết quả các phép so sánh. Phép so sánh đầu tiên tạo gốc cây. Một nhánh biểu diễn đúng, nhánh kia sai. Thuật toán có thể chọn các phép so sánh kế tiếp khác nhau trên hai nhánh, tạo cây mà các lá là quyết định đã hoàn tất.
Ba phần tử có nhãn A, B và C có thể có sáu thứ tự tương đối nghiêm ngặt. Bộ sắp xếp đúng phải phân biệt cả sáu, vì mỗi thứ tự cần một hoán vị khác của các vị trí ban đầu. Nếu hai thứ tự không tương thích đến cùng một lá, thuật toán tạo cùng một hoán vị vị trí cho cả hai và sẽ sai trên ít nhất một đầu vào.
Cây nhị phân cao hai có nhiều nhất bốn lá, không đủ phân biệt sáu thứ tự. Chiều cao ba cho phép tối đa tám lá, nên ít nhất một đầu vào cần ba phép so sánh. Điều này không nói mọi đầu vào đều cần ba; một số đường ngắn có thể kết thúc sau hai.
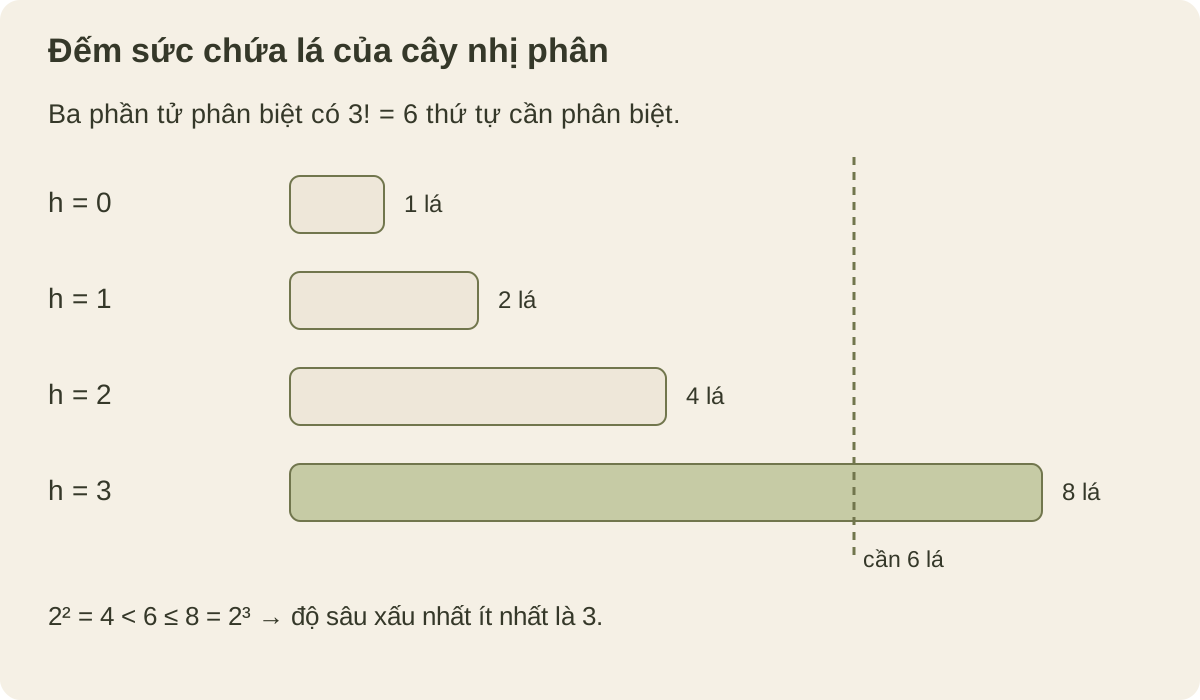
Hình thể hiện lập luận về sức chứa, không khẳng định mọi cây đầy đủ đều tương ứng một thuật toán sắp xếp hợp lệ. Đếm lá cung cấp điều kiện cần. Xây dựng thuật toán đạt một cận cụ thể là nhiệm vụ riêng.
Từ sáu thứ tự đến n giai thừa
Với n phần tử có nhãn và khóa phân biệt, có n! thứ tự tương đối. Cây quyết định nhị phân có độ sâu lớn nhất h có nhiều nhất 2^h lá. Để đúng, cần 2^h >= n!, từ đó h >= ceil(log2(n!)).
Có thể thấy tốc độ tăng mà không cần xấp xỉ chi tiết bằng cách xét n chẵn. n/2 thừa số lớn nhất của n! đều ít nhất bằng n/2, nên n! >= (n/2)^(n/2). Lấy logarit cho cận dưới (n/2) * log2(n/2), tức Ω(n log n). Với kích thước lẻ, giảm về số chẵn liền trước để có cùng bậc tăng.
Một phép sắp xếp so sánh O(n log n) khớp cận dưới tiệm cận xấu nhất đó. Không thể suy ra mọi cài đặt như vậy có cùng số so sánh chính xác, bộ nhớ, tính ổn định hoặc thời gian chạy. Phần merge sort của Princeton trình bày cận dưới so sánh bên cạnh phân tích cận trên.
Theo dõi đường so sánh trên mọi hoán vị nhỏ
Insertion sort có bộ đếm minh họa khác biệt giữa cận dưới xấu nhất và số thao tác của một đầu vào cụ thể. Với ba khóa phân biệt, mã dùng hai phép so sánh trên một số hoán vị và ba trên các hoán vị còn lại.
from itertools import permutations


def insertion_comparisons(source):
    original = list(source)
    values = original.copy()
    count = 0
    for i in range(1, len(values)):
        current = values[i]
        j = i
        while j > 0:
            count += 1
            if values[j - 1] <= current:
                break
            values[j] = values[j - 1]
            j -= 1
        values[j] = current
    assert values == sorted(original)
    return count

counts = [insertion_comparisons(order) for order in permutations(range(3))]
assert counts.count(2) == 2
assert counts.count(3) == 4
assert max(counts) == 3
assert insertion_comparisons(iter([3, 1, 2])) == 3
Hàm đọc đầu vào một lần và giữ các giá trị ban đầu để đối chiếu ở cuối, nên iterator chỉ dùng được một lần cũng hoạt động. Bộ đếm chỉ ghi phép so sánh trong vòng lặp chèn; sao chép và phép sắp xếp tham chiếu riêng là công việc kiểm chứng nằm ngoài bộ đếm.
Trung bình trên sáu đầu vào đồng xác suất là 16 / 6, xấp xỉ 2,67. Con số này cao hơn log2(6), khoảng 2,58, phù hợp với lập luận thông tin. Muốn mở rộng phát biểu xấu nhất thành phát biểu trung bình phải có phân phối đầu vào; các hoán vị đồng xác suất là một lựa chọn cụ thể, không phải tính chất tự có của dữ liệu thực tế.
Ngẫu nhiên hóa cũng cần phát biểu chính xác. Các lựa chọn ngẫu nhiên có thể cải thiện kỳ vọng của một chính sách pivot tất định tệ, nhưng không khiến sắp xếp so sánh tổng quát cần công việc kỳ vọng nhỏ hơn bậc n log n dưới mọi phân phối đầu vào. Lập luận cây tất định là điểm xuất phát; chứng minh cận dưới ngẫu nhiên cần xét phân phối của thuật toán trên các cây đó.
Khi nào số lá cần thiết thay đổi
Khóa lặp làm giảm số cách bố trí giá trị mà thuật toán phải phân biệt. Nếu số lần xuất hiện cố định là m1, m2, ..., số hoán vị giá trị khác nhau là n! / (m1! * m2! * ...). Đầu vào toàn khóa bằng nhau chứa ít thông tin thứ tự hơn nhiều so với hoán vị các giá trị phân biệt. Thuật toán có thể khai thác khác biệt đó khi hợp đồng so sánh và đầu ra cho phép.
Cam kết đầu vào thuộc một họ hạn chế cũng thay đổi cách đếm. Sắp xếp một dãy biết trước chỉ có vài nghịch thế là bài toán nhỏ hơn chấp nhận mọi hoán vị. Cận dưới xấu nhất tổng quát không cấm xử lý nhanh hơn trên họ hạn chế ấy.
Counting sort và radix sort đọc khóa có miền giá trị giới hạn hoặc chữ số rồi dùng chúng chọn nhóm. Mô hình thao tác của chúng cung cấp thông tin vượt ngoài phép so sánh nhị phân giữa hai khóa đầy đủ. Vì vậy, các cận tuyến tính dưới giả định phù hợp về miền khóa không mâu thuẫn với cận dưới so sánh. Các ứng dụng sắp xếp của Princeton đặt lựa chọn thuật toán trong bối cảnh kiểu khóa và yêu cầu ứng dụng.
Trước một tuyên bố sắp xếp mới, hãy viết rõ miền khóa, thao tác cho phép, các bản ghi bằng nhau có cần ổn định không và đang xác định cận cho loại chi phí nào. Sau đó hỏi thuật toán phải phân biệt bao nhiêu kết quả. Cách này chính xác hơn việc áp dụng cận quen thuộc lên mọi tuyên bố “nhanh hơn n log n” mà bỏ qua giả định.
Xây dựng đầy đủ một cây cho ba phần tử
Cây cụ thể cho thấy vì sao đường ngắn và đường dài có thể cùng thuộc một bộ sắp xếp đúng. Trước tiên so A với B. Nếu A nhỏ hơn, so B với C: kết quả đúng kết thúc tại A, B, C sau hai so sánh. Kết quả sai chưa xác định vị trí C so với A, nên cần thêm một phép để chọn A, C, B hoặc C, A, B. Nhánh kia đối xứng sau khi đổi vai trò A và B.
def order_three(values):
    if len(values) != 3:
        raise ValueError('exactly three distinct comparable keys are required')
    trace = []

    def before(i, j):
        outcome = values[i] < values[j]
        trace.append((i, j, outcome))
        return outcome

    if before(0, 1):
        if before(1, 2):
            order = (0, 1, 2)
        elif before(0, 2):
            order = (0, 2, 1)
        else:
            order = (2, 0, 1)
    else:
        if before(0, 2):
            order = (1, 0, 2)
        elif before(1, 2):
            order = (1, 2, 0)
        else:
            order = (2, 1, 0)
    return order, trace

order, trace = order_three([30, 10, 20])
assert order == (1, 2, 0)
assert trace == [(0, 1, False), (0, 2, False), (1, 2, True)]
for values in permutations(range(3)):
    order, trace = order_three(values)
    assert [values[i] for i in order] == sorted(values)
    assert len(trace) in (2, 3)
Tuple trả về là hoán vị vị trí đầu vào, không phải tập giá trị số mới, và không phụ thuộc vào việc nhãn có thể sắp theo bảng chữ cái. Đầu vào phải thỏa hợp đồng khóa phân biệt, so sánh nhất quán từ trước; kiểm tra độ dài không xác nhận điều kiện ngữ nghĩa đó. Nhờ vậy, ví dụ nằm trong mô hình so sánh đã nêu thay vì âm thầm phân loại giá trị bằng thao tác khác.
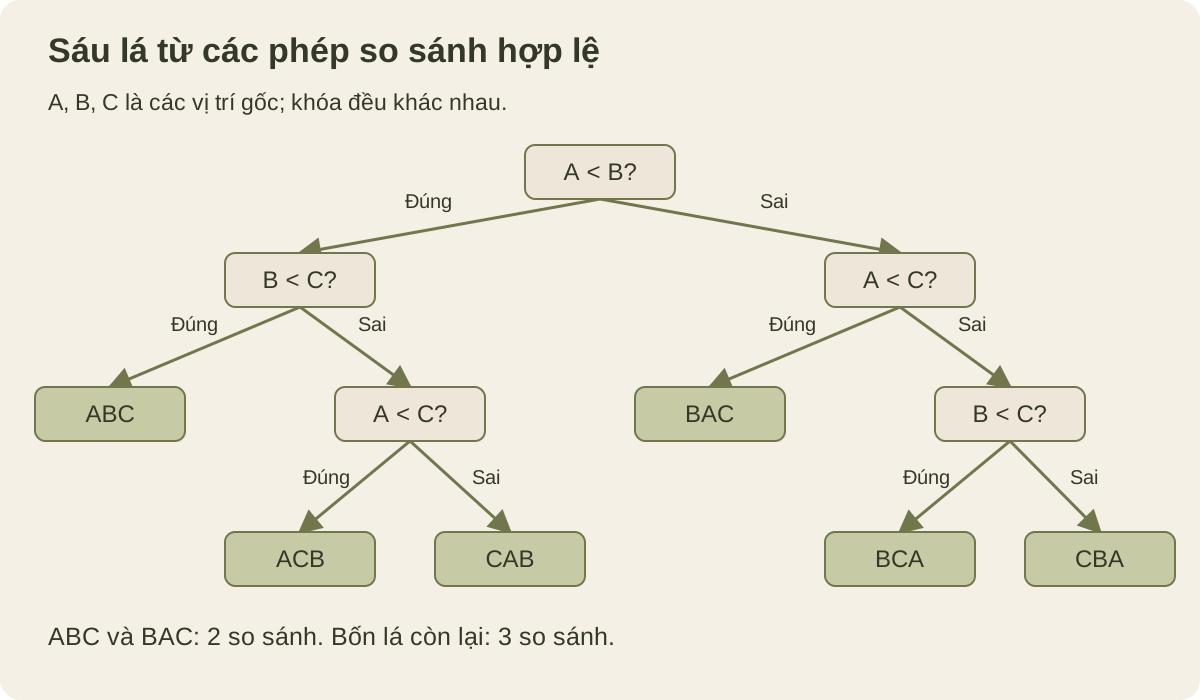
Có sáu lá: hai ở độ sâu hai và bốn ở độ sâu ba. Nhãn lá là thứ tự nghiêm ngặt của các phần tử ban đầu. Một số nhánh kết thúc sớm vì các so sánh đã suy ra quan hệ còn thiếu bằng tính bắc cầu. Ví dụ, A nhỏ hơn B và B nhỏ hơn C suy ra A nhỏ hơn C mà không cần câu hỏi thứ ba. Sức chứa tám lá của cây nhị phân đầy đủ cao ba không bắt buộc thuật toán tiếp tục hỏi khi đã biết đáp án.
Cây này đạt cận xấu nhất ba phép so sánh cho ba phần tử phân biệt. Nó không chứng minh rằng chỉ cần lấy trần của cận thông tin là luôn có thuật toán đạt được ở mọi kích thước lớn hơn. Cây gồm các câu hỏi có/không trừu tượng còn linh hoạt hơn cây buộc phải hỏi những phép so sánh hợp lệ giữa các khóa đang có. Sức chứa lá cần thiết và chiến lược sắp xếp thực hiện được là hai nghĩa vụ riêng.
Cùng cây đó có trung bình khác nhau khi phân phối đầu vào đổi. Giả sử trong công việc giả định, ABC và BAC mỗi thứ tự có xác suất 0,4, còn mỗi thứ tự khác có xác suất 0,05. Tám mươi phần trăm trường hợp dùng hai so sánh và hai mươi phần trăm dùng ba, nên trung bình là 0.8*2 + 0.2*3 = 2.2. Trường hợp xấu nhất vẫn là ba. Các xác suất này chỉ mô tả phân phối ví dụ, không phải số đo từ ứng dụng thật.
Để luyện tập, dồn toàn bộ xác suất vào một lá cần ba phép so sánh rồi đối chiếu trung bình mới với trung bình đồng xác suất. Tiếp theo, liệt kê cây ba phần tử và xác nhận không có hai thứ tự nghiêm ngặt khác nhau đến cùng một lá. Bài tập tách hai câu hỏi thường bị trộn trong tuyên bố hiệu năng: mọi đầu vào hợp lệ có được sắp đúng không, và công việc cụ thể đi qua từng đường hợp lệ thường xuyên đến đâu.