Đọc một ma trận attention nhỏ bằng phép tính cụ thể
Tính trọng số attention, áp dụng mặt nạ nhân quả và cộng vector giá trị; phân biệt phép tính bên trong với lời giải thích cho quyết định cuối cùng.
Nếu bạn đang học transformer, attention dễ kiểm tra hơn khi tự tính một hàng. Attention tích vô hướng có điều chỉnh tỷ lệ biến điểm số query-key thành trọng số, rồi dùng trọng số để kết hợp các vector value. Trọng số quyết định một phép tính; chúng không tự giải thích vì sao câu trả lời cuối của mô hình đúng.
Bài báo Attention Is All You Need định nghĩa thao tác này bằng softmax của tích query-key đã điều chỉnh tỷ lệ, sau đó nhân với ma trận value. Ta giữ tên query, key và value để đối chiếu với mã nguồn: query là vector truy vấn, key là vector được so khớp, còn value chứa thông tin được kết hợp. Ví dụ dưới đây chọn điểm số và vector hai chiều để mọi số đều có thể kiểm tra bằng tay.
Bắt đầu sau bước tính điểm
Với một query và ba key, giả sử điểm số đã được điều chỉnh tỷ lệ là 0, ln(2) và ln(3). Trong lớp attention đầy đủ, điểm số được tính từ tích vô hướng chia cho căn bậc hai của số chiều key. Chọn trực tiếp các số này giúp tách riêng bước chuẩn hóa.
Softmax lấy hàm mũ của từng điểm rồi chia cho tổng. Các giá trị sau hàm mũ là 1, 2 và 3, nên trọng số bằng 1/6, 2/6 và 3/6. Chúng không âm và có tổng bằng một.
Cho các vector value là v1 = (1, 0), v2 = (0, 2) và v3 = (3, 1). Đầu ra là tổng có trọng số:
output = (1/6)*(1,0) + (2/6)*(0,2) + (3/6)*(3,1)
       = (1/6 + 9/6, 4/6 + 3/6)
       = (5/3, 7/6)
Trọng số lớn nhất thuộc vector thứ ba, nhưng cả ba vector đều đóng góp. Bản đồ nhiệt chỉ hiển thị trọng số sẽ bỏ qua các vector đang được cộng. Giữ nguyên trọng số nhưng thay vector value có thể tạo đầu ra khác.
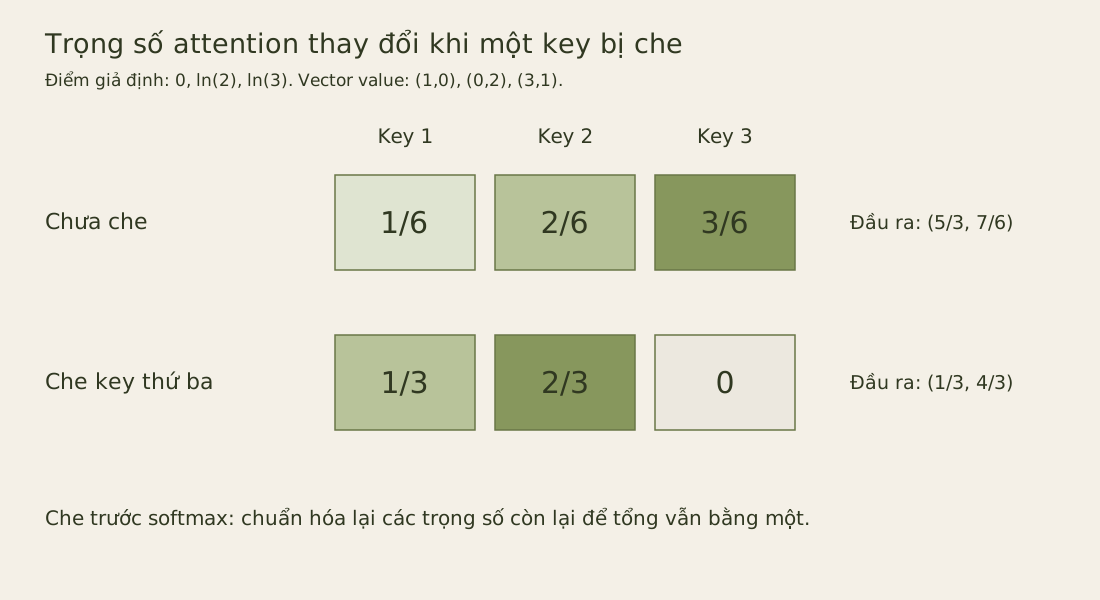
Hình biểu diễn một hàng attention, không phải toàn bộ transformer. Mô hình đầy đủ có nhiều vị trí, đầu attention, lớp, nhánh kết nối phần dư và những thao tác khác. Giữ ví dụ nhỏ giúp các chi tiết đó không che mất phép cộng có trọng số cơ bản.
Áp dụng mặt nạ nhân quả trước softmax
Giả sử key thứ ba thuộc token tương lai mà query này không được nhìn thấy. Mặt nạ nhân quả loại vị trí đó trước khi chuẩn hóa, thường được biểu diễn bằng cách thay điểm số thành âm vô cực. Giá trị hàm mũ của nó trở thành không.
Hai trọng số chưa chuẩn hóa còn lại là 1 và 2. Sau khi chuẩn hóa lại, trọng số thành 1/3, 2/3 và 0. Đầu ra lúc này bằng (1/3, 4/3). Chỉ đặt trọng số thứ ba cũ về không sẽ khiến tổng trọng số còn một nửa và không thực hiện cùng phép attention.
Trong bộ giải mã của transformer, mặt nạ ngăn một vị trí dùng token đầu ra tương lai trong lúc huấn luyện. Nếu thiếu ràng buộc đó, mô hình có thể sử dụng thông tin chưa tồn tại khi sinh token tiếp theo. Bài báo mô tả mặt nạ trong attention của bộ giải mã; cùng ý tưởng nhân quả này là cơ sở cho sinh tự hồi quy.
Chỉ số của mặt nạ cũng phải đúng. Lệch một vị trí có thể vô tình lộ token tiếp theo hoặc che mất ngữ cảnh hiện tại được phép dùng. Kiểm thử bằng ma trận nhỏ hữu ích vì bạn chỉ ra được chính xác vị trí nào phải có trọng số bằng không.
Triển khai phép tính cẩn thận
Để ổn định số học, trừ điểm hữu hạn lớn nhất trước khi lấy hàm mũ. Softmax không thay đổi khi cộng hoặc trừ cùng một hằng số ở mọi điểm, trong khi phép trừ giảm nguy cơ tràn số. Triển khai sản xuất cũng cần quy định hành vi khi cả hàng đều bị che.
from math import exp, log

scores = [0.0, log(2), log(3)]
maximum = max(scores)
unnormalized = [exp(score - maximum) for score in scores]
weights = [value / sum(unnormalized) for value in unnormalized]
values = [(1, 0), (0, 2), (3, 1)]
output = [sum(w * value[j] for w, value in zip(weights, values))
          for j in range(2)]
Đoạn mã minh họa một hàng chưa che. Nó không thay thế triển khai attention theo lô của thư viện tensor. Khi kiểm thử, so sánh với các phân số phía trên bằng sai số cho phép của số dấu phẩy động, thay vì yêu cầu bằng nhau tuyệt đối.
Xác định hình dạng mặt nạ trước khi thêm chiều lô
Với ba vị trí trong self-attention nhân quả, ma trận vị trí được phép thường có dạng tam giác dưới. Query tại vị trí 0 được đọc key tại vị trí 0. Query tại vị trí 1 được đọc key tại vị trí 0 và 1. Query tại vị trí 2 được đọc cả ba. Đường chéo được phép vì trạng thái ẩn ở một vị trí dự đoán token kế tiếp theo cách huấn luyện thông thường với mục tiêu dịch một vị trí; cho phép đường chéo không làm lộ token đích kế tiếp đó.
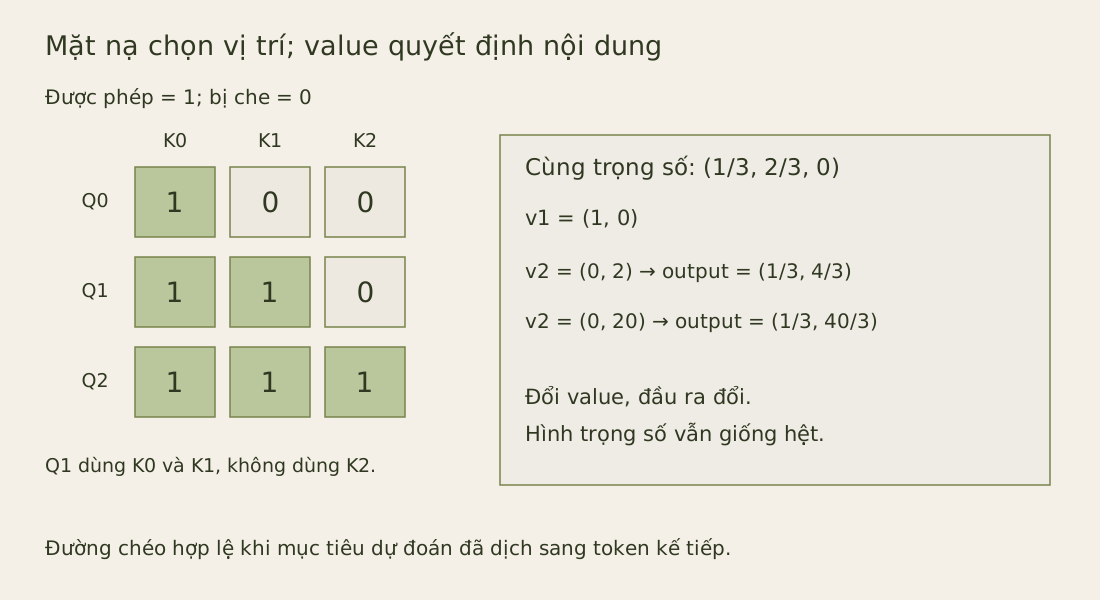
Viết trước các vị trí được phép rồi mới đối chiếu thư viện. Một số API hiểu boolean true là “giữ”, trong khi API khác dùng nó để đánh dấu vị trí bị chặn. Mặt nạ có thể đúng hình dạng nhưng diễn đạt chính sách ngược hẳn. Mặt nạ cho phần đệm tạo thêm một ràng buộc và cần được kết hợp có chủ đích với quy tắc nhân quả.
Đây là hàm tham chiếu vô hướng cho bước chuẩn hóa. Hàm từ chối hàng không có vị trí được phép, nhờ đó quy tắc của ví dụ rõ ràng. Một thư viện tensor cụ thể có thể chọn hành vi khác đã được công bố; khi kiểm thử tích hợp thật, hãy theo đúng hợp đồng của thư viện đó.
from math import exp, isclose, log

def masked_weights(scores, allowed):
    if len(scores) != len(allowed) or not any(allowed):
        raise ValueError("need matching lengths and an allowed key")
    maximum = max(score for score, keep in zip(scores, allowed) if keep)
    raw = [exp(score - maximum) if keep else 0.0
           for score, keep in zip(scores, allowed)]
    return [value / sum(raw) for value in raw]

weights = masked_weights([0.0, log(2), log(3)], [True, True, False])
assert isclose(weights[0], 1/3)
assert isclose(weights[1], 2/3)
assert weights[2] == 0.0
Hàm tham chiếu giả định các điểm tại vị trí được phép là số thực hữu hạn. NaN và giá trị vô cực cần kiểm tra đầu vào hoặc xử lý lỗi số học riêng. Thêm trường hợp chỉ có một key được phép, các điểm bằng nhau, cộng cùng hằng số và một hàng bị che hoàn toàn. Chúng kiểm tra những bất biến cụ thể mà không cần GPU hay tải mô hình lớn.
Hiểu hệ số điều chỉnh tỷ lệ
Phép chia cho căn bậc hai của số chiều key kiểm soát độ lớn tích vô hướng query-key. Dưới giả định đơn giản rằng các thành phần có phương sai gần một và đóng góp độc lập, phương sai của tổng các tích thành phần tăng theo số chiều. Điểm số lớn có thể khiến softmax tập trung mạnh, ảnh hưởng tới gradient khi huấn luyện. Hệ số này xử lý ảnh hưởng của độ lớn; nó không chuẩn hóa mọi query đã học hay bảo đảm một mẫu attention cụ thể.
The Illustrated Transformer của Jay Alammar, công bố ngày 27 tháng 6 năm 2018, đi qua các phép chiếu query, key và value đã học trước khi cộng có trọng số. Trình tự hình ảnh của bài đó giúp nối các số nhỏ ở đây với phép toán ma trận xung quanh. Giá trị số và hình trong bài hiện tại là ví dụ riêng; không có hình nào được sao chép từ tài liệu đó.
Trong hàng ví dụ, bước điều chỉnh tỷ lệ đã diễn ra trước khi các điểm được chọn đi vào softmax. Chia những điểm đó thêm lần nữa sẽ làm đổi ví dụ. Khi đọc mã triển khai, xác định rõ vị trí của phép điều chỉnh và mặt nạ để biết hình trực quan đang mô tả ma trận nào.
Giới hạn lời giải thích ở điều đã có bằng chứng
Trọng số attention giúp kiểm tra phép tính của mô hình, nhưng trọng số lớn trên một token không tự chứng minh token đó gây ra quyết định cuối theo cách người đọc hình dung. Phép chiếu value, những đầu attention khác, các lớp sau và nhánh kết nối phần dư đều ảnh hưởng đầu ra.
Attention is not Explanation khảo sát hạn chế của việc coi phân phối attention là lời giải thích trong các thiết lập được nghiên cứu. Điều đó không có nghĩa hình trực quan attention vô ích. Nó có nghĩa một khẳng định về khả năng giải thích cần bằng chứng ngoài một bản đồ nhiệt hấp dẫn.
Khi điều tra ứng dụng, thay một sự kiện liên quan trong đầu vào, giữ nguyên văn bản không liên quan rồi quan sát đầu ra. Bạn cũng có thể thử bỏ hoặc thay một đoạn để xem quyết định có đổi không. Can thiệp như vậy trả lời câu hỏi hành vi cụ thể hơn việc hỏi token nào có màu sáng nhất.
Phép tính nhỏ cung cấp hai điều cần kiểm tra khi đọc mô hình lớn: che vị trí trước chuẩn hóa, và trọng số chỉ mô tả cách kết hợp các vector value hiện có. Khi một sơ đồ hoặc lời giải thích bỏ qua một trong hai điểm, quay về ví dụ ba vector để xác định phần tính toán nào đang thiếu.
Bài tập cuối: giữ trọng số sau mặt nạ là một phần ba và hai phần ba, nhưng thay vector thứ hai bằng (0, 20). Tọa độ thứ hai của đầu ra trở thành 40/3 thay vì 4/3, trong khi trọng số hiển thị hoàn toàn không đổi. Thay đổi có kiểm soát này đủ để thấy riêng trọng số không quyết định nội dung được biểu diễn. Nó không chứng minh một kết luận phổ quát về khả năng diễn giải; nó tách một đầu vào còn thiếu của một phép attention, đúng phạm vi mà lời giải thích hữu ích cần nêu rõ.