Theo sáu lệnh qua pipeline năm giai đoạn
Lập bảng chu kỳ cho sáu lệnh độc lập, tính chi phí làm đầy và rút pipeline, rồi phân biệt bubble với dừng mọi giai đoạn.
Pipeline năm giai đoạn chồng lấp công việc của nhiều lệnh. Nó không hoàn tất một lệnh trong một phần năm thời gian ban đầu. Nếu bạn đọc hợp ngữ hoặc so sánh thiết kế CPU, hãy tách ba đại lượng: độ trễ một lệnh, khoảng cách giữa các lệnh hoàn tất và tổng thời gian của một nhóm hữu hạn.
Dùng bộ xử lý giả định chỉ bắt đầu tối đa một lệnh mỗi chu kỳ, gồm nạp lệnh, giải mã/đọc thanh ghi, thực thi, bộ nhớ và ghi kết quả, viết tắt IF, ID, EX, MEM và WB. Mỗi lệnh ở mỗi giai đoạn đúng một chu kỳ đầy đủ. Thanh ghi chốt kết quả ở cuối chu kỳ, rồi giai đoạn sau dùng giá trị ấy trong chu kỳ tiếp theo. Đây là lịch minh họa, không phải mô hình thời gian cho mọi triển khai RISC-V.
Chọn lệnh thỏa lịch đơn giản
Cho x20 ban đầu chứa 100 và giữ nguyên nó. Sáu phép cộng RV32 minh họa ghi vào các thanh ghi đích khác nhau:
addi x1, x20, 1
addi x2, x20, 2
addi x3, x20, 3
addi x4, x20, 4
addi x5, x20, 5
addi x6, x20, 6
Gọi các lệnh lần lượt là I1 đến I6. Không lệnh nào dùng thanh ghi đích do lệnh khác trong nhóm tạo ra. Không có nhánh, lỗi hoặc ngắt; việc cung cấp lệnh không gặp miss hay phải dừng. Giả sử triển khai có đủ tài nguyên để các giai đoạn theo lịch hoạt động đồng thời. Chính các điều kiện này xác lập diễn tiến đơn giản, không phải chỉ tên giai đoạn.
Lệnh số học mang kết quả qua MEM mà không truy cập bộ nhớ dữ liệu. Pipeline cố định này vẫn dùng chu kỳ MEM: bỏ qua giai đoạn với một số lệnh sẽ tạo lịch khác. Đặc tả RV32 cơ sở định nghĩa số học kiến trúc của ADDI, còn giả định thời gian ở đây được đặt ra rõ ràng cho ví dụ.
Đặt từng lệnh lên bảng chu kỳ
I1 ở IF trong chu kỳ 1, ID trong chu kỳ 2, EX trong chu kỳ 3, MEM trong chu kỳ 4 và WB trong chu kỳ 5. Nó ghi thanh ghi ở cuối chu kỳ 5. Đồng thời, I2 bắt đầu IF trong chu kỳ 2 và đến WB trong chu kỳ 6. Các lệnh còn lại dịch chéo theo cùng quy tắc.
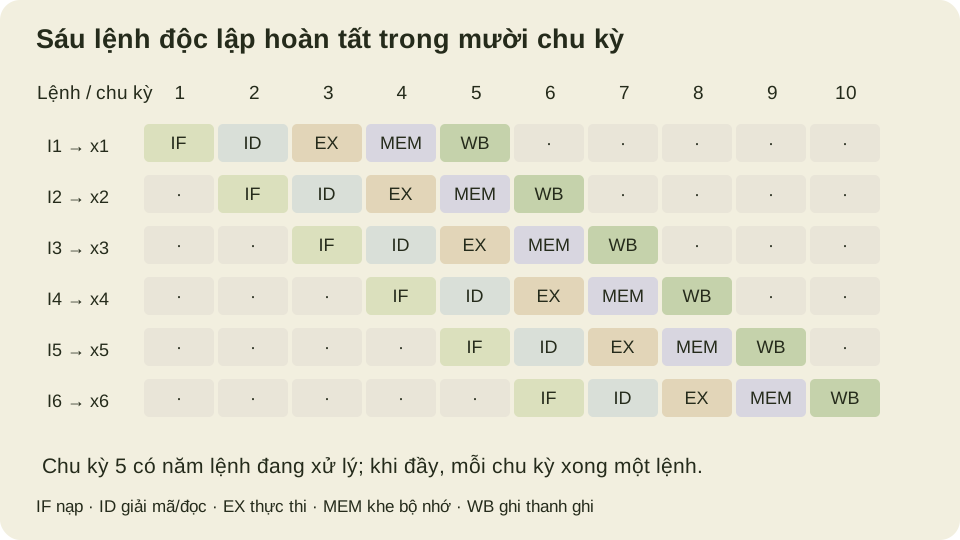
Đọc bảng theo cả hai chiều. Một hàng theo một lệnh qua thời gian. Cột chu kỳ 5 chứa I5 ở IF, I4 ở ID, I3 ở EX, I2 ở MEM và I1 ở WB. Có năm lệnh đang xử lý, nhưng chỉ I1 hoàn tất trong chu kỳ ấy. Nhầm số lệnh đang ở trong pipeline với số hoàn tất sẽ biến sai bộ xử lý chỉ phát hành một lệnh mỗi chu kỳ thành máy hoàn tất năm lệnh mỗi chu kỳ.
Từ pipeline rỗng, lần hoàn tất đầu cần năm chu kỳ. Mỗi lệnh còn lại thêm một chu kỳ khi dòng lệnh không gián đoạn. Vì vậy nhóm N lệnh không rỗng hoàn tất trong N cộng bốn chu kỳ dưới các giả định này. Sáu lệnh cần mười chu kỳ; số chu kỳ trung bình mỗi lệnh của nhóm là mười chia sáu, tức năm phần ba. Khoảng hoàn tất khi dòng lệnh đã ổn định vẫn là một chu kỳ.
Bài giảng Computation Structures về Beta có pipeline xây dựng cách chồng lấp năm giai đoạn và các hazard làm gián đoạn nó. Tên giai đoạn đọc thanh ghi và ALU của bài giảng hơi khác bảng này. Thời gian bộ nhớ của nó cũng đặc thù bộ xử lý học tập ấy; đừng chuyển chi tiết đó thành khẳng định chung cho mọi pipeline năm giai đoạn.
Mang danh tính lệnh cùng kết quả
Thanh ghi pipeline phải giữ nhiều hơn một đáp số. Các giai đoạn sau còn cần thanh ghi đích, tín hiệu cho phép ghi và thông tin điều khiển khác của đúng lệnh đó. Ghép kết quả I3 với đích I4 sẽ làm sai trạng thái kiến trúc dù mọi giá trị số học đều được tính đúng.
Mô hình chạy được sau mang danh tính, đích và kết quả tính sẵn cùng nhau. Nó kiểm tra vị trí trong giai đoạn và ghi tại ranh giới WB mô hình. Nó không giải mã hay thực thi hợp ngữ: sáu kết quả số học được tính trực tiếp từ toán hạng đã nêu để cô lập lịch và việc theo dõi thông tin.
from fractions import Fraction

STAGES = ("IF", "ID", "EX", "MEM", "WB")
MASK32 = (1 << 32) - 1

def trace(admissions, initial=100):
    pipeline = [None] * 5
    rows, commits, registers = [], [], {}
    for cycle in range(1, len(admissions) + 5):
        index = admissions[cycle - 1] if cycle <= len(admissions) else None
        token = None if index is None else (
            index, index + 1, (initial + index + 1) & MASK32)
        pipeline = [token] + pipeline[:-1]
        rows.append(tuple(None if item is None else item[0] + 1
                          for item in pipeline))
        if pipeline[-1] is not None:
            identity, destination, value = pipeline[-1]
            assert destination == identity + 1
            registers[destination] = value
            commits.append((cycle, identity + 1))
    return rows, commits, registers

rows, commits, registers = trace(list(range(6)))
assert rows[4] == (5, 4, 3, 2, 1)
assert commits == [(i + 5, i + 1) for i in range(6)]
assert registers == {i: 100 + i for i in range(1, 7)}
assert Fraction(commits[-1][0], 6) == Fraction(5, 3)

# Two idle admission slots; older instructions continue advancing.
_, delayed, same_registers = trace([0, 1, None, 2, 3, None, 4, 5])
assert delayed == [(5, 1), (6, 2), (8, 3), (9, 4), (11, 5), (12, 6)]
assert same_registers == registers
_, _, wrapped = trace(list(range(6)), initial=0xfffffffd)
assert wrapped == {1: 0xfffffffe, 2: 0xffffffff, 3: 0, 4: 1, 5: 2, 6: 3}

logic_ps = (180, 160, 210, 190, 120)
register_budget_ps = 30
clock_ps = max(logic_ps) + register_budget_ps
unsegmented_ps = sum(logic_ps) + register_budget_ps
assert (clock_ps, unsegmented_ps) == (240, 890)
assert 5 * clock_ps == 1200
assert commits[-1][0] * clock_ps == 2400
assert Fraction(6 * unsegmented_ps, 10 * clock_ps) == Fraction(89, 40)
print("six-instruction schedule, two bubbles, 32-bit results and timing budget checked")
Trường hợp quay vòng đổi thanh ghi nguồn chung thành 0xFFFFFFFD mà vẫn giữ tính độc lập. Nó kiểm tra mô hình giữ số học 32 bit như đã nêu. Nó không biến bảng thời gian thành chứng minh giải mã lệnh, xử lý ngoại lệ hoặc forwarding. Đó là cơ chế riêng mà mô hình gói thông tin đơn giản cố ý bỏ qua.
Đổi chu kỳ sang thời gian theo giai đoạn chậm nhất
Giả sử độ trễ tổ hợp của năm giai đoạn lần lượt là 180, 160, 210, 190 và 120 picôgiây. Thêm ba mươi picôgiây cho mỗi khoảng xung nhịp làm ngân sách tổng hợp cho thanh ghi và yêu cầu thời gian. Giai đoạn giới hạn là EX với 210 picôgiây, nên chu kỳ pipeline mô hình là 240 picôgiây. Cộng năm độ trễ rồi chia năm sẽ bỏ qua giai đoạn chậm nhất và cho phép xung mà một số đường không đáp ứng được.
Để có đối chứng chưa chia giai đoạn được đặt ra tương ứng, giả sử cả năm độ trễ tổ hợp nằm trên một đường nối tiếp và dùng cùng ngân sách đầu-cuối ba mươi picôgiây. Khoảng của nó là 890 picôgiây. Đây là giả định để tính toán, không phải độ trễ lấy từ chip, báo cáo tổng hợp hay thư viện cell. Setup, hold, clock skew và ràng buộc đường vật lý thật cần phân tích thời gian riêng.
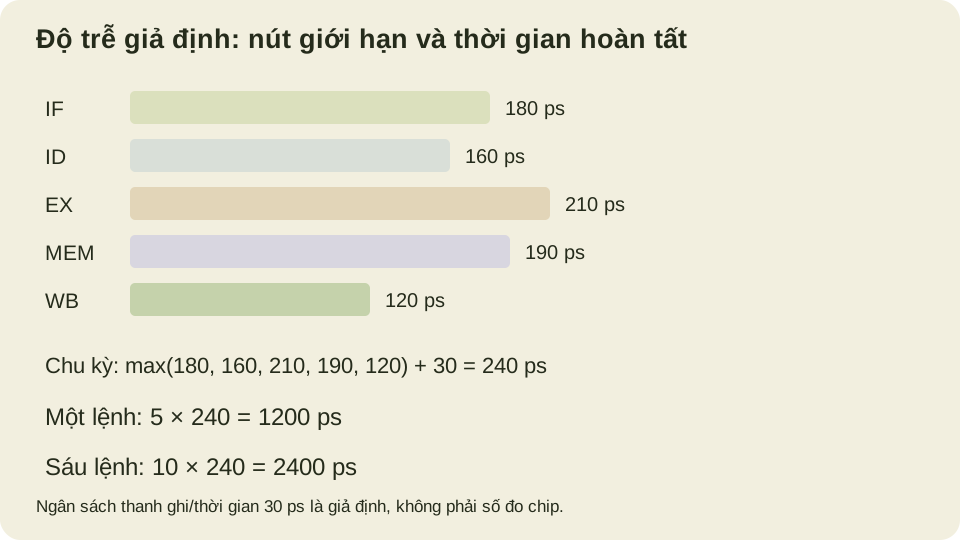
Một lệnh qua pipeline mất 1.200 picôgiây, dài hơn khoảng chưa chia giai đoạn 890 picôgiây. Sáu lệnh chưa chia giai đoạn mất 5.340 picôgiây; nhóm qua pipeline mất 2.400. Hệ số tăng tốc của nhóm là 2,225, không phải năm. Với dòng rất dài không gián đoạn, tỷ số thông lượng tiến tới 890 chia 240, xấp xỉ 3,708. Chi phí làm đầy và rút hết pipeline ở nhóm hữu hạn giải thích vì sao lợi ích của sáu lệnh nhỏ hơn.
Ghi chú về độ trễ và mạch pipeline phân biệt các chỉ số này và giải thích vì sao thanh ghi có thể tăng thông lượng trong khi tăng độ trễ. Thêm giai đoạn chỉ giúp thông lượng nếu giảm khoảng giới hạn đủ để bù ngân sách thanh ghi tăng thêm. Số giai đoạn tự nó không phải phép đo tần số xung.
Mô hình hóa bubble mà không gọi là dừng toàn bộ
Lịch thứ hai chèn hai khe không nhận lệnh, trước I3 và trước I5. Lệnh cũ vẫn tiến lên. Các khe rỗng đi qua giai đoạn và tạo khoảng trống giữa những lần hoàn tất. Lệnh cuối nay xong ở cuối chu kỳ 12, trong khi giá trị thanh ghi và thứ tự lệnh không đổi.
Đây là mô hình bubble do không nhận lệnh đầu vào. Hazard thật có thể giữ một số thanh ghi pipeline trong khi cho phần khác tiến, hoặc chặn cả pipeline. Cache miss có thể cần máy trạng thái khác và độ trễ dài hơn nhiều. Không khẳng định mọi gián đoạn hai chu kỳ chỉ chèn hai khe như vậy nếu quy tắc điều khiển được triển khai không khớp mô hình.
Bài tập: chèn một khe không nhận lệnh ngay trước I6 và dự đoán chu kỳ hoàn tất của nó. Sau đó tưởng tượng một lần dừng giữ nguyên mọi giai đoạn đang có lệnh trong một chu kỳ sau chu kỳ 3. Vẽ trường hợp thứ hai riêng: vị trí trung gian bị ảnh hưởng khác nhau dù một số cách đếm tổng thời gian có thể trùng. Nêu phần nào tiến, phần nào giữ nguyên giúp người khác rà soát được khẳng định thời gian pipeline.