Tiền xử lý phải được khớp bên trong mỗi fold cross-validation
Tính cách đầu vào giữ lại làm đổi bộ chuẩn hóa và hình phạt ridge, rồi phân biệt rò rỉ thông tin với thay đổi dự đoán và sai số.
Hãy khớp từng bước tiền xử lý có học từ dữ liệu trên phần huấn luyện của mỗi fold cross-validation, rồi áp dụng bước đã khớp cho phần được giữ lại. Bộ chuẩn hóa có thể vượt ranh giới thông tin dù không dùng nhãn. Câu hỏi quan trọng khi kiểm tra là những hàng nào đã cung cấp trung bình, phương sai, từ vựng hoặc tập đặc trưng được chọn.
Bài này dành cho kỹ sư hoặc sinh viên đã hiểu trung bình và một đường thẳng được khớp từ dữ liệu. Ta sẽ tính cách một đầu vào giữ lại làm thay đổi bộ chuẩn hóa, rồi xem khi nào thay đổi ấy tác động đến dự đoán. Các con số được xây dựng cho ví dụ. Chương trình Python chính xác triển khai một hàm mục tiêu sai số bình phương đã khai báo; nó không chạy bộ ước lượng scikit-learn hay đo độ chính xác vận hành.
Khớp và biến đổi có nhiệm vụ khác nhau
Bộ chuẩn hóa đã khớp lưu các thống kê học từ những quan sát được cung cấp. Biến đổi đầu vào đến sau dùng lại những giá trị đã lưu. Nếu đưa đầu vào validation vào bước khớp, mô hình nhận thông tin mà một bộ dự đoán thông thường cho đầu vào tương lai chưa thấy sẽ không có.
Hướng dẫn các lỗi thường gặp của scikit-learn khuyến nghị chia dữ liệu trước khi tiền xử lý có học, dùng dữ liệu huấn luyện để khớp và áp dụng phép biến đổi đã khớp cho dữ liệu giữ lại. Pipeline giúp duy trì ranh giới ấy qua cross-validation. Nó không thể hoàn tác phép biến đổi toàn cục đã được khớp trước khi đầu vào đi vào pipeline.
Quy tắc liên quan đến việc học từ mẫu đánh giá. Nhân số mét với một hệ số cố định để đổi sang centimet không ước lượng gì từ mẫu đó. Tính trung bình từ tất cả quãng đường đã ghi nhận thì có. Một bài toán chủ ý cung cấp toàn bộ lô đầu vào đích chưa gán nhãn trong giai đoạn phát triển có hợp đồng thông tin khác; hãy gọi tên bài toán đó thay vì ngầm coi nó là dự đoán thông thường cho đầu vào chưa thấy.
Một đầu vào cực trị làm đổi thống kê đã lưu
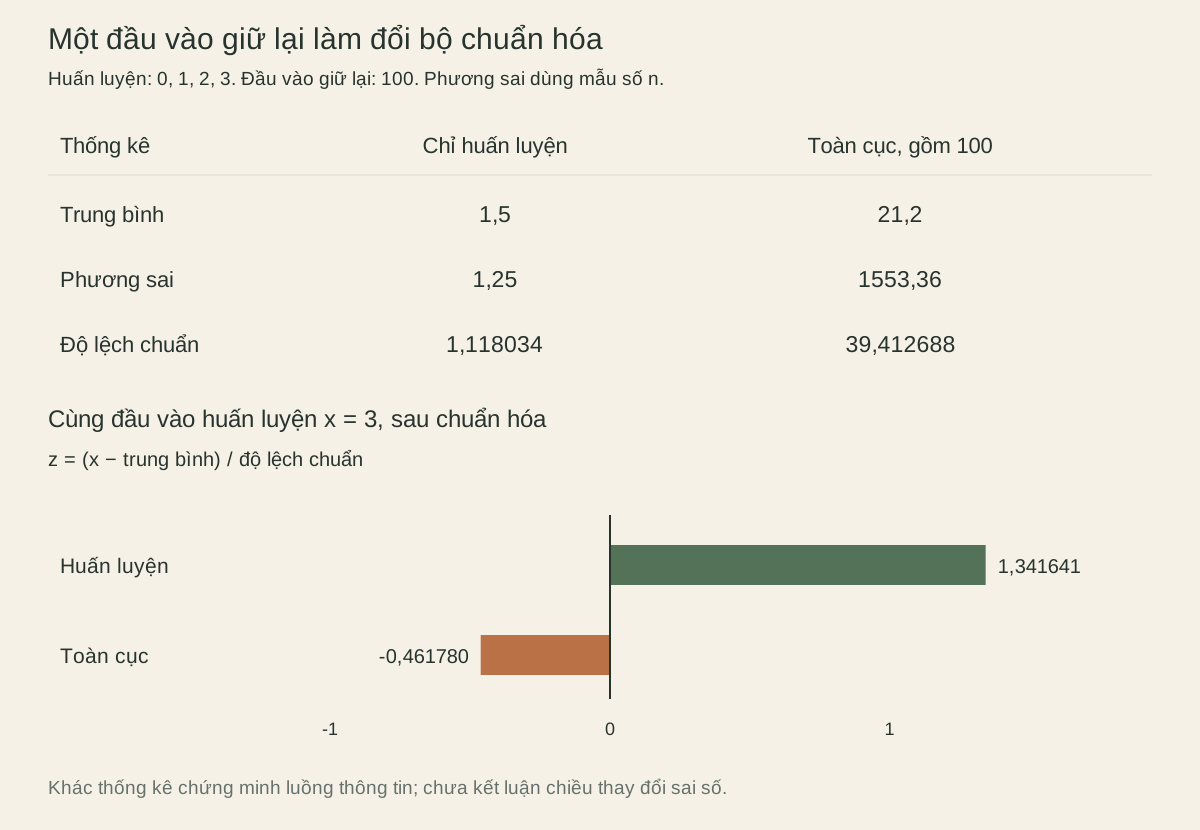
Lấy đầu vào huấn luyện 0, 1, 2 và 3, cùng đầu vào giữ lại bằng 100. Trung bình huấn luyện bằng 1,5; phương sai tính bằng trung bình bình phương độ lệch là 1,25. Đưa thêm 100 vào làm trung bình thành 21,2 và phương sai thành 1553,36.
Tài liệu StandardScaler mô tả việc lưu trung bình và thang đo huấn luyện, đồng thời dùng quy ước phương sai có mẫu số bằng số giá trị đã quan sát. Ta dùng quy ước ấy ở đây. Điều đó không khẳng định mọi bộ ước lượng phương sai trong thống kê đều dùng cùng mẫu số.
Chạy các khối theo thứ tự trong cùng một trình thông dịch Python. Dữ liệu ví dụ gồm các đầu vào hữu tỉ hữu hạn, không rỗng, với phương sai dùng để chuẩn hóa dương.
from fractions import Fraction as F
from math import sqrt


def moments(values):
    mean = sum(values) / len(values)
    variance = sum((x - mean)**2 for x in values) / len(values)
    return mean, variance


train_x = list(map(F, [0, 1, 2, 3]))
train_y = train_x.copy()
held_x = F(100)
train_mean, train_variance = moments(train_x)
global_mean, global_variance = moments(train_x + [held_x])
for name, mean, variance in [
    ('training', train_mean, train_variance),
    ('global', global_mean, global_variance),
]:
    z3 = float(F(3) - mean) / sqrt(float(variance))
    print(name, str(mean), str(variance), f'{z3:.6f}')
training 3/2 5/4 1.341641
global 106/5 38834/25 -0.461780Số cuối là giá trị đã chuẩn hóa của đầu vào huấn luyện 3. Với bộ chuẩn hóa từ tập huấn luyện, nó cao hơn trung bình đã khớp; với bộ chuẩn hóa toàn cục, nó thấp hơn trung bình. Đầu vào giữ lại đã làm đổi biểu diễn dùng để huấn luyện, dù nhãn của nó không hề xuất hiện trong phép tính.
Quan sát đó chứng minh luồng thông tin, nhưng không chứng minh một chiều thay đổi hiệu năng đúng cho mọi trường hợp. Một số bộ ước lượng hấp thụ được những phép đổi tọa độ nhất định. Các bộ khác thay đổi mức điều chuẩn thực tế hoặc hình học khoảng cách. Chẩn đoán đáng tin cần tách những trường hợp ấy, thay vì khẳng định mọi bộ chuẩn hóa bị rò rỉ nhất thiết làm điểm báo cáo tốt hơn.
Hệ số chặn tự do hấp thụ việc dịch tâm, nhưng số hạng phạt vẫn chịu tác động của thang đo
Cho bốn đầu vào huấn luyện có giá trị đích bằng chính đầu vào. Xét đường thẳng khớp theo đầu vào chuẩn hóa z, có hệ số chặn tự do và số hạng phạt trên hệ số góc. Hàm mục tiêu là trung bình sai số bình phương huấn luyện cộng hệ số phạt nhân bình phương hệ số góc trong tọa độ chuẩn hóa. Hệ số chặn không chịu phạt.
Viết cùng dự đoán bằng đơn vị đầu vào gốc: một hệ số chặn cộng hệ số góc gốc nhân x. Nếu phương sai của bộ chuẩn hóa là s², bình phương hệ số góc chuẩn hóa bằng s² nhân bình phương hệ số góc gốc. Vì vậy, thang đo làm thay đổi hình phạt đối với hàm trong tọa độ gốc. Khi hệ số chặn tự do, thay đổi trung bình của bộ chuẩn hóa có thể được hấp thụ vào hệ số chặn; trong ví dụ này, phương sai thay đổi mới là yếu tố tác động.
Tối thiểu hóa hàm mục tiêu trong tọa độ gốc cho:
raw slope = training covariance(x,y) / (training variance(x) + penalty*s²)
raw intercept = mean(training y) - raw slope*mean(training x)
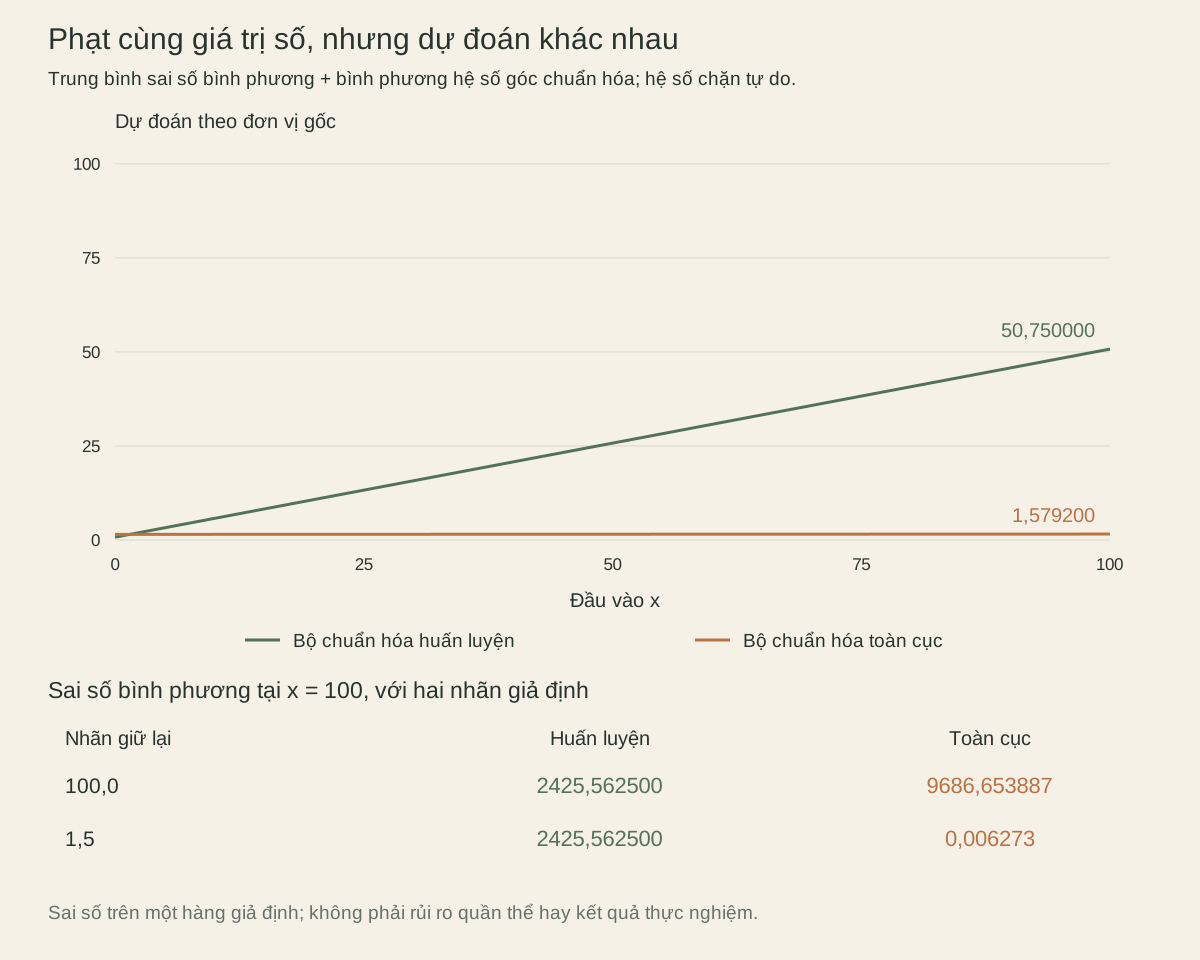
Hai dòng lần lượt tính hệ số góc gốc từ hiệp phương sai huấn luyện và tính hệ số chặn gốc từ các trung bình huấn luyện. Với các giá trị đích đang dùng, hiệp phương sai huấn luyện bằng phương sai huấn luyện. Hệ số phạt bằng một với bộ chuẩn hóa huấn luyện cho hệ số góc một nửa và hệ số chặn ba phần tư. Dùng bộ chuẩn hóa toàn cục với cùng giá trị số của hệ số phạt cho hệ số góc chỉ khoảng 0,000804. Đầu vào giữ lại trên thực tế đã áp hình phạt mạnh hơn nhiều lên biến thiên của dự đoán theo đơn vị gốc.
Hàm tiếp theo tính chính xác các hệ số ấy. Nó giả định hai danh sách huấn luyện hữu tỉ hữu hạn, không rỗng, dài bằng nhau; phương sai chuẩn hóa dương; hệ số phạt không âm; và phương sai huấn luyện dương khi bỏ phạt. Đây là ví dụ toán học nhỏ, không phải thư viện xác thực đầu vào tổng quát. Hàm mục tiêu dùng tổn thất trung bình; đừng thay bằng tham số phạt của thư viện dùng tổng tổn thất mà chưa kiểm tra cách chuẩn hóa.
def fit_scaled_ridge(x, y, scale_variance, penalty):
    mean_x, variance_x = moments(x)
    mean_y = sum(y) / len(y)
    covariance = sum((a-mean_x)*(b-mean_y) for a, b in zip(x, y)) / len(x)
    slope = covariance / (variance_x + penalty*scale_variance)
    return mean_y - slope*mean_x, slope


for name, scale_variance in [('training', train_variance), ('global', global_variance)]:
    intercept, slope = fit_scaled_ridge(train_x, train_y, scale_variance, F(1))
    prediction = intercept + slope*held_x
    errors = [(label-prediction)**2 for label in [F(100), F(3, 2)]]
    print(name, str(slope), f'{float(prediction):.6f}',
          *(f'{float(error):.6f}' for error in errors))

adjusted = train_variance / global_variance
assert fit_scaled_ridge(train_x, train_y, global_variance, adjusted) == (F(3,4), F(1,2))
for scale_variance in [train_variance, global_variance]:
    assert fit_scaled_ridge(train_x, train_y, scale_variance, F(0)) == (F(0), F(1))
print('adjusted penalty', str(adjusted))
training 1/2 50.750000 2425.562500 2425.562500
global 125/155461 1.579200 9686.653887 0.006273
adjusted penalty 125/155336Sau tên và hệ số góc chính xác, các cột là dự đoán tại 100, sai số bình phương nếu nhãn giữ lại bằng 100, và sai số bình phương nếu nhãn đó bằng 1,5. Số thập phân chỉ là cách hiển thị làm tròn của phép tính hữu tỉ.
Rò rỉ có thể làm sai số giữ lại này tệ hơn hoặc tốt hơn
Với bộ chuẩn hóa huấn luyện, dự đoán tại 100 là 50,75. Với bộ chuẩn hóa toàn cục, dự đoán khoảng 1,5792. Nếu nhãn chưa thấy bằng 100, phiên bản toàn cục có sai số lớn hơn nhiều. Nếu nhãn bằng 1,5, nó có sai số nhỏ hơn nhiều. Đây là hai nhãn khả dĩ được giả định cho cùng đầu vào; cả hai đều không tham gia khớp mô hình.
Hai trường hợp không đo rủi ro quần thể hoặc tần suất xảy ra của mỗi kết quả. Chúng xác lập rằng phép biến đổi không giám sát bị rò rỉ không nhất thiết làm mọi điểm validation thực tế dịch chuyển theo cùng một hướng. Vấn đề phương pháp là quy trình đã khớp sử dụng thông tin ngoài ranh giới dự định. Điểm thấp của quy trình rò rỉ không làm giao thức trở nên hợp lệ, cũng như điểm đẹp không chứng minh một cải thiện hữu ích.
Với bình phương tối thiểu thông thường có hệ số chặn tự do và không có số hạng phạt, cả hai bộ chuẩn hóa đều cho hệ số góc gốc bằng một và hệ số chặn bằng không. Cả hai dự đoán 100 tại đầu vào giữ lại. Phép biến đổi affine khả nghịch chỉ viết lại cùng lớp đường thẳng. Tính bất biến ấy giải thích vì sao kiểm tra rò rỉ chỉ bằng câu hỏi dự đoán có đổi hay không có thể bỏ sót ranh giới khớp sai.
Ta cũng có thể khôi phục hệ số ridge ban đầu bằng cách giảm hệ số phạt số học của phiên bản toàn cục, sao cho tích của nó với phương sai toàn cục bằng tích tương ứng của phiên bản chỉ dùng huấn luyện. Giá trị điều chỉnh được assertion kiểm tra trong chương trình thực hiện đúng điều đó. Đây là lời giải thích về sự phụ thuộc tọa độ, không phải khuyến nghị ước lượng bộ chuẩn hóa toàn cục rồi bù lại sau. Chọn đặc trưng, điền thiếu và các phép biến đổi phi tuyến tùy ý không có cùng phép triệt tiêu đơn giản.
Lặp lại toàn bộ ranh giới khớp ở mỗi fold
Với mỗi fold cross-validation, bắt đầu bằng bản sao chưa khớp của toàn bộ quy trình. Khớp bộ điền thiếu, chuẩn hóa và bộ ước lượng bằng các hàng huấn luyện của fold đó. Dùng trạng thái đã lưu để biến đổi và dự đoán các hàng validation của chính fold ấy. Mỗi fold có thể có trung bình, thang đo hoặc tập đặc trưng khác nhau; biến thiên đó thuộc về quy trình học đang được đánh giá.
Hướng dẫn ghép pipeline giải thích cách pipeline khớp các phép biến đổi và bộ dự đoán trên cùng mẫu huấn luyện trong cross-validation. Tài liệu cũng mô tả việc lưu đệm phép biến đổi đã khớp khi cả đầu vào lẫn tham số giống nhau. Bộ chuẩn hóa toàn cục được lưu đệm riêng không thể thay cho các trạng thái theo từng fold. Cache tự xây dựng phải nhận diện đúng dữ liệu huấn luyện và cấu hình liên quan, không chỉ dùng một tên tệp như scaled-data.
Giá trị đặc trưng được giữ lại vẫn tham gia tính dự đoán. Điều đó đúng với nhiệm vụ: dự đoán một đầu vào đòi hỏi nhìn thấy nó. Thứ phải giữ cố định là trạng thái đã học từ tập con huấn luyện. Để kiểm tra trực tiếp ranh giới, thay giá trị giữ lại trong khi giữ nguyên tập huấn luyện và xác nhận thống kê huấn luyện đã lưu không đổi. Dự đoán có thể đổi vì đầu vào cần dự đoán đã đổi; riêng điều đó không phải bằng chứng rò rỉ.
Pipeline không sửa được mọi nguồn rò rỉ thông tin
Chọn đặc trưng theo tương quan với toàn bộ nhãn dùng mục tiêu giữ lại để chọn biểu diễn. Hãy đặt bước chọn đó bên trong mỗi fold huấn luyện. Đừng chọn trước một tập đặc trưng chung cho tiện bằng toàn bộ dữ liệu có nhãn rồi mô tả cross-validation của bộ phân loại phía sau là đánh giá chưa bị tác động.
Ràng buộc nhóm và thời gian vẫn cần thiết. Nếu bản ghi của cùng người nói xuất hiện ở cả hai phía, chuẩn hóa đúng không xác lập hiệu năng trên người nói mới. Đặc trưng lịch sử dùng nhãn đến sau hoặc tổng hợp tương lai vẫn chưa có ở thời điểm dự đoán gốc. Pipeline áp dụng đầu vào nó nhận; nó không chứng minh nguồn gốc của các đặc trưng phía trước.
Một phép biến đổi có giám sát còn có thể cần tách thông tin trong chính thuật toán huấn luyện của nó. Chẳng hạn, thay trực tiếp một danh mục chỉ xuất hiện một lần bằng nhãn quan sát của dòng đó tiết lộ đáp án cho bộ ước lượng phía sau. Chỉ riêng ranh giới fold bên ngoài không làm các đặc trưng huấn luyện ấy đại diện cho thứ mà dự đoán tương lai sẽ nhận. Cần quy định cách bộ mã hóa xử lý nhãn huấn luyện và danh mục chưa thấy, thay vì cho rằng bọc trong pipeline là đủ.
Đặc trưng thiếu và đặc trưng hằng cần hành vi rõ ràng. Ví dụ tránh chúng để mọi phép chia được trình bày đều xác định. Trong ứng dụng, hãy thử đặc trưng thiếu hoàn toàn ở fold huấn luyện, đặc trưng có phương sai bằng không và danh mục chỉ xuất hiện ở validation. Kiểm tra hợp đồng của phép biến đổi đã chọn cùng schema kết quả; đừng lấp khoảng trống bằng thống kê tính từ các hàng validation.
Bài tập và bước kiểm tra phát hành có thể tái lập
Trước hết, thay đầu vào giữ lại 100 bằng 10. Bộ chuẩn hóa được khớp đúng vẫn có trung bình 1,5 và phương sai 1,25; chỉ giá trị truy vấn sau biến đổi thay đổi. Bộ chuẩn hóa toàn cục đổi sang trung bình 3,2 và phương sai 12,56. Tính lại hai dự đoán ridge và xác định thao tác nào được phép thấy giá trị mới.
Tiếp theo, nhân mọi đầu vào, gồm cả truy vấn tương lai, với mười. Biến đổi trung bình và phương sai đã lưu cho nhất quán, rồi xác minh giá trị chuẩn hóa và dự đoán giữ nguyên. So sánh phép đổi đơn vị đồng bộ ấy với việc thêm một quan sát giữ lại vào bước khớp bộ chuẩn hóa. Hai thao tác thay đổi phép tính vì những lý do khác nhau.
Cuối cùng, đặt hệ số phạt bằng không và xác nhận cả hai bộ chuẩn hóa đã khớp cho cùng dự đoán dù vẫn lưu thống kê khác nhau. Bài tập kiểm tra trực tiếp ranh giới thông tin, thay vì dùng chênh lệch dự đoán số học làm tín hiệu duy nhất.
Lưu phép biến đổi đã đánh giá cùng bộ ước lượng, gồm thứ tự đặc trưng, hành vi với giá trị thiếu và ánh xạ danh mục. Áp dụng cùng trạng thái đó khi suy luận. Ghi định nghĩa cách chia và các hàng hoặc ảnh chụp dữ liệu đã khớp từng trạng thái. Một fold ngoại tuyến đúng không bảo vệ được bản triển khai tự tính lại bộ chuẩn hóa khác từ lưu lượng đang đến.